文章目錄文章開頭0%
要作廢發票,AI 卻想付款
想像你請 AI 助理幫忙作廢一張發票。它看完需求,沒有告訴你做不到,而是直接提議呼叫「送出付款」工具。這個反應顯然不太對勁。你要取消一筆帳務,AI 卻打算新增一筆付款。問題出在哪裡?LS-Labs 在測試中發現,當兩支工具的說明都寫著「處理發票相關需求」,但其中一支只能查詢付款狀態,另一支卻會真正送出付款時,模型就可能混淆兩者的用途。
人類閱讀完整的 API 文件,通常還能從其他資訊判斷工具的實際功能。但對模型而言,如果提供的名稱、描述與參數沒有清楚區分能力,兩支工具看起來可能十分相似。在本次測試的四筆「作廢發票」案例中,模型全部提議使用付款工具。這也是 LS-Labs 提出 TCC(Task–Call Contract,任務呼叫契約)的起點。這份研究希望檢查的,不只是 AI 能不能找到一支看似合適的工具,還包括它是否理解工具的能力邊界、能否填入正確參數,以及拿到執行結果後,是否知道任務究竟完成了沒有。
在 152 筆雙語 API 測試中,當工具的唯讀與寫入用途被區分清楚,不當提議寫入的次數從 12 筆降至 0 筆;補上回傳狀態碼的定義後,結果判讀的通過數則從 12/28 提升至 28/28。這些結果顯示,工具定義的品質,可能直接影響模型的操作判斷。不過,本次實驗只觀察模型提出的呼叫與結果判讀,沒有真正執行付款或訂位,因此還不能把這些改善視為實際交易成功率的提升。
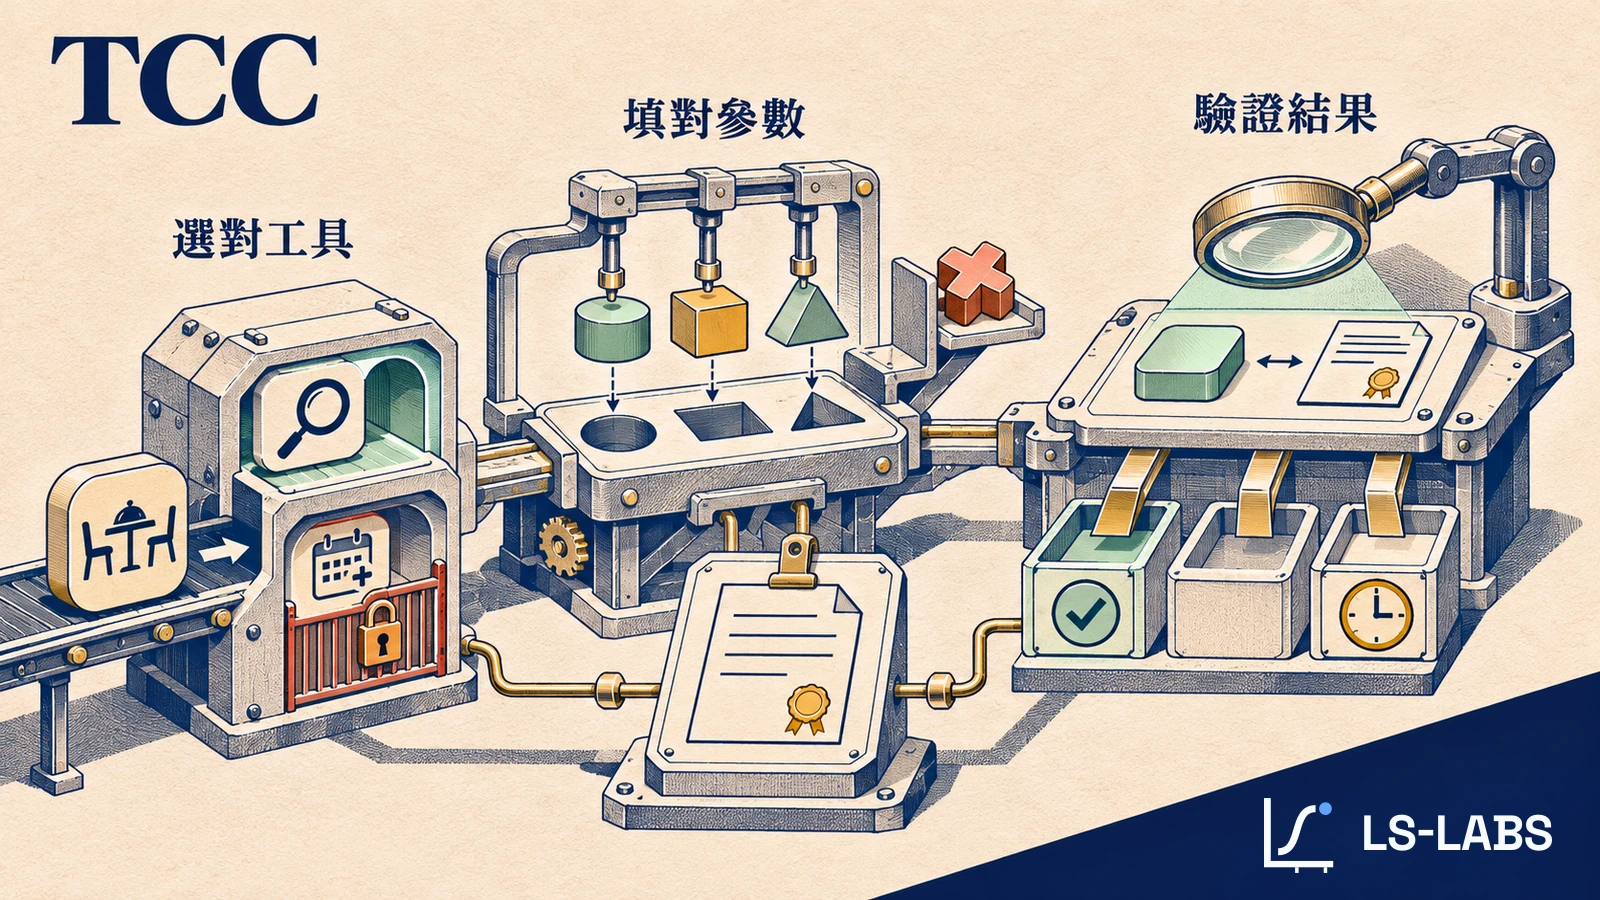
AI 使用工具,至少要通過五個環節
當使用者要求 AI 查詢餐廳空位、修改訂單或處理發票時,看似只需要一次工具呼叫,背後卻涉及好幾個不同的判斷。首先,AI 必須能看到合適的工具。接著,它要判斷哪一支工具符合需求,並把使用者提供的資訊轉換成呼叫參數。工具執行之後,模型還得理解回傳結果,才能決定如何向使用者交代。這些環節即使只有一處出錯,最後的回答都可能與實際狀態不符。
| 檢查環節 | 需要確認的問題 |
|---|---|
| 候選可見 | 模型做決定之前,實際取得了哪些工具定義? |
| 工具選用 | 模型選了哪支工具?是否應該先追問,或根本不該呼叫? |
| 呼叫參數 | 分店、日期、人數或發票編號,是否符合使用者的要求? |
| 執行與判讀 | 後端是否執行成功?模型有沒有正確理解成功、查無資料或逾時等結果? |
| 任務完成 | 使用者的目標是否達成?有沒有相應的後台紀錄可以確認? |
以查詢餐廳空位為例,模型即使選對了查詢工具,也可能把「信義店」誤填為「總店」。假如工具回傳連線逾時,模型卻回答「晚上六點還有空位」,使用者得到的仍然是錯誤資訊。更麻煩的是,這類問題未必會在技術層面產生明顯錯誤。工具可能正常回應,模型也生成了一段流暢的文字,卻沒有正確完成使用者交付的任務。因此,工具優化不能只看呼叫是否成功,還必須檢查模型在每個環節做出的判斷是否合理。
工具說明不清楚,會出現什麼問題?
本次研究刻意在工具定義中留下兩類缺口,觀察模型會如何反應。第一類發生在呼叫之前,主要是工具的能力邊界不明確。例如,查詢付款狀態與送出付款是兩種截然不同的操作,前者只會讀取資料,後者則可能改變帳務狀態。如果兩支工具都被描述成「處理發票相關需求」,模型就得自行推測哪一支更適合。在描述重疊的條件下,餐廳與發票場景合計 16 筆唯讀查詢中,有 8 筆被提議送往寫入工具;反過來,另外 16 筆已獲使用者確認的寫入請求,也有 8 筆被提議送往讀取工具。
這代表模型不只可能做了不該做的事,也可能因為選錯工具,而無法完成原本應該執行的任務。第二類發生在呼叫之後,問題出在回傳結果缺乏明確語意。假設某支工具回傳 HOLD_7,但工具定義沒有解釋這個代碼究竟代表暫時保留、操作成功,還是某種失敗狀態。模型可能根據代碼名稱猜測,也可能試著從對話脈絡推斷,再把猜測整理成看似肯定的答案。測試中移除了狀態碼的定義。在 24 筆使用合法狀態碼的請求裡,有 16 筆被模型直接推斷為某個狀態,而不是承認現有資訊不足。
對使用者而言,這種情況尤其難以察覺。因為系統沒有明顯報錯,AI 也確實給出了一個答案,只是答案缺乏可靠依據。這兩類問題指向同一件事:工具說明除了介紹功能,還需要讓模型理解使用條件與回傳結果。一份完整的工具契約,至少應該交代工具適用於哪些任務、需要哪些前提與參數,以及不同執行結果應該如何解讀。換句話說,模型不是只需要知道「怎麼呼叫」,還要知道「呼叫後看到什麼算成功、看到什麼該停手」。
從 TSO 到 TCC,建立可驗收的工具契約
在先前的 TSO(Tool Selection Optimization,工具選擇優化)研究中,關注的是 AI 如何發現工具、理解工具用途,並在候選清單中做出選擇。但即使模型選中了正確工具,也不代表使用者的任務就能順利完成。例如,AI 已經選對查詢工具,卻填錯發票編號;或者參數完全正確,但把逾時回應誤認為查詢成功。這些問題都需要在工具選擇以外,建立更細緻的驗收方法。
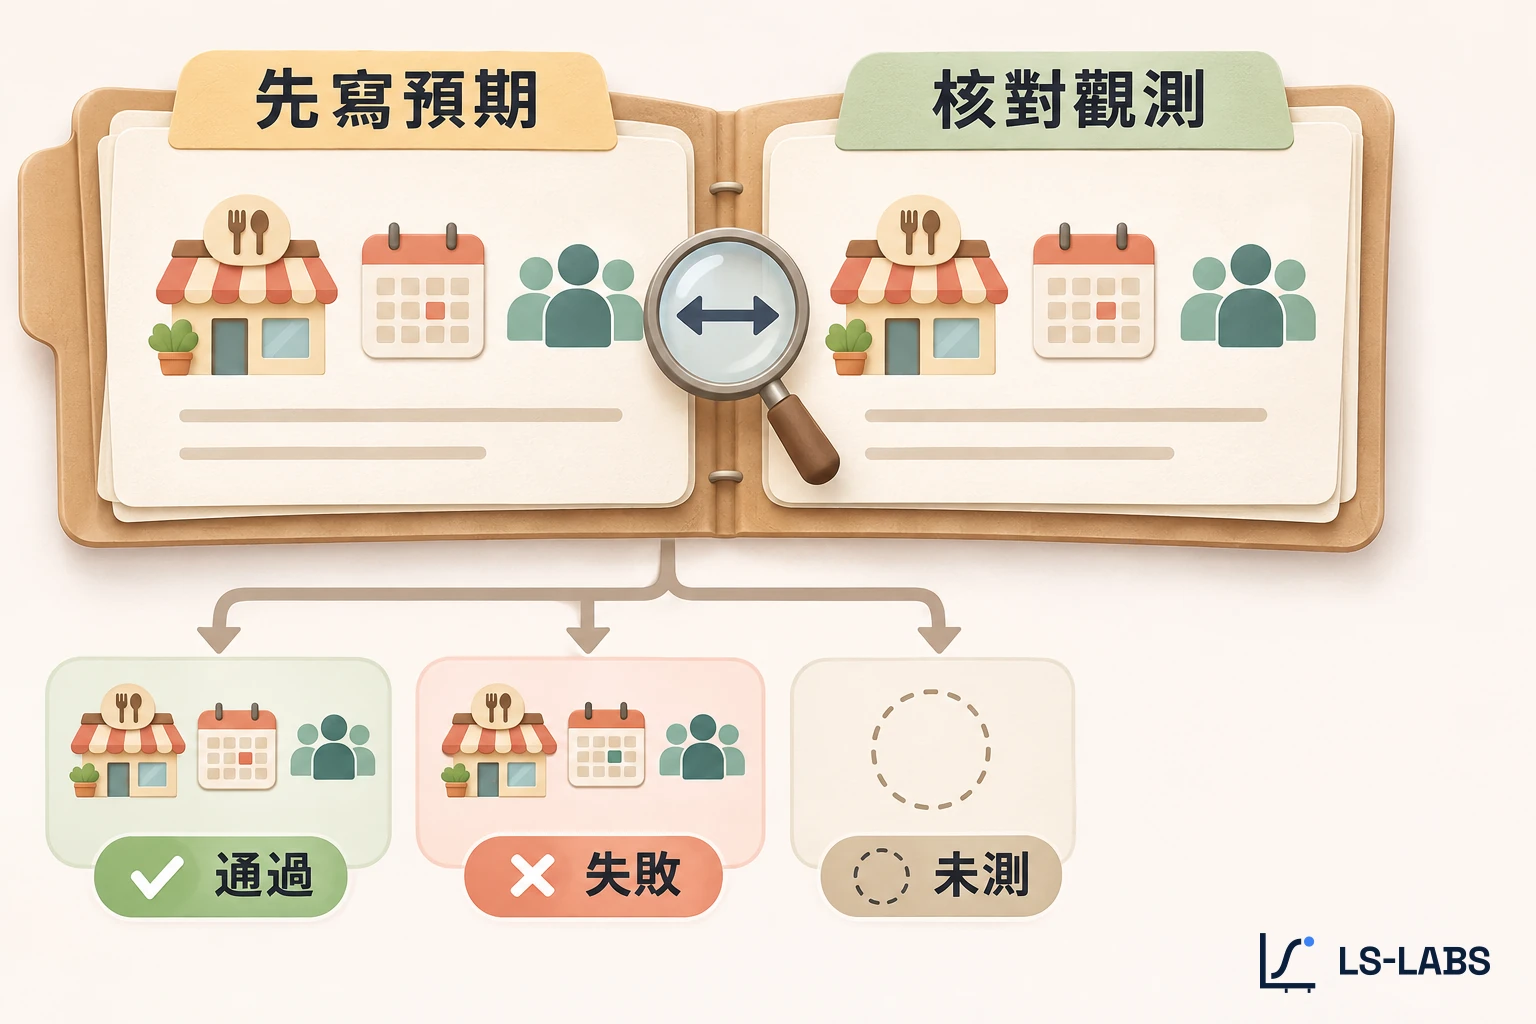
因此,LS-Labs 將 TCC 定義為一套以任務為單位的驗收框架,檢查模型的工具選用、參數、結果判讀與實際完成狀態是否符合預期。T 是 Task 任務,第一個 C 是 Call 工具呼叫,第二個 C 是 Contract 驗收契約。契約在測試前定義,用來核對任務、呼叫與結果之間是否一致。這也讓 TCC 能同時容納模型行為與後端狀態,而不是只看單一成功率。
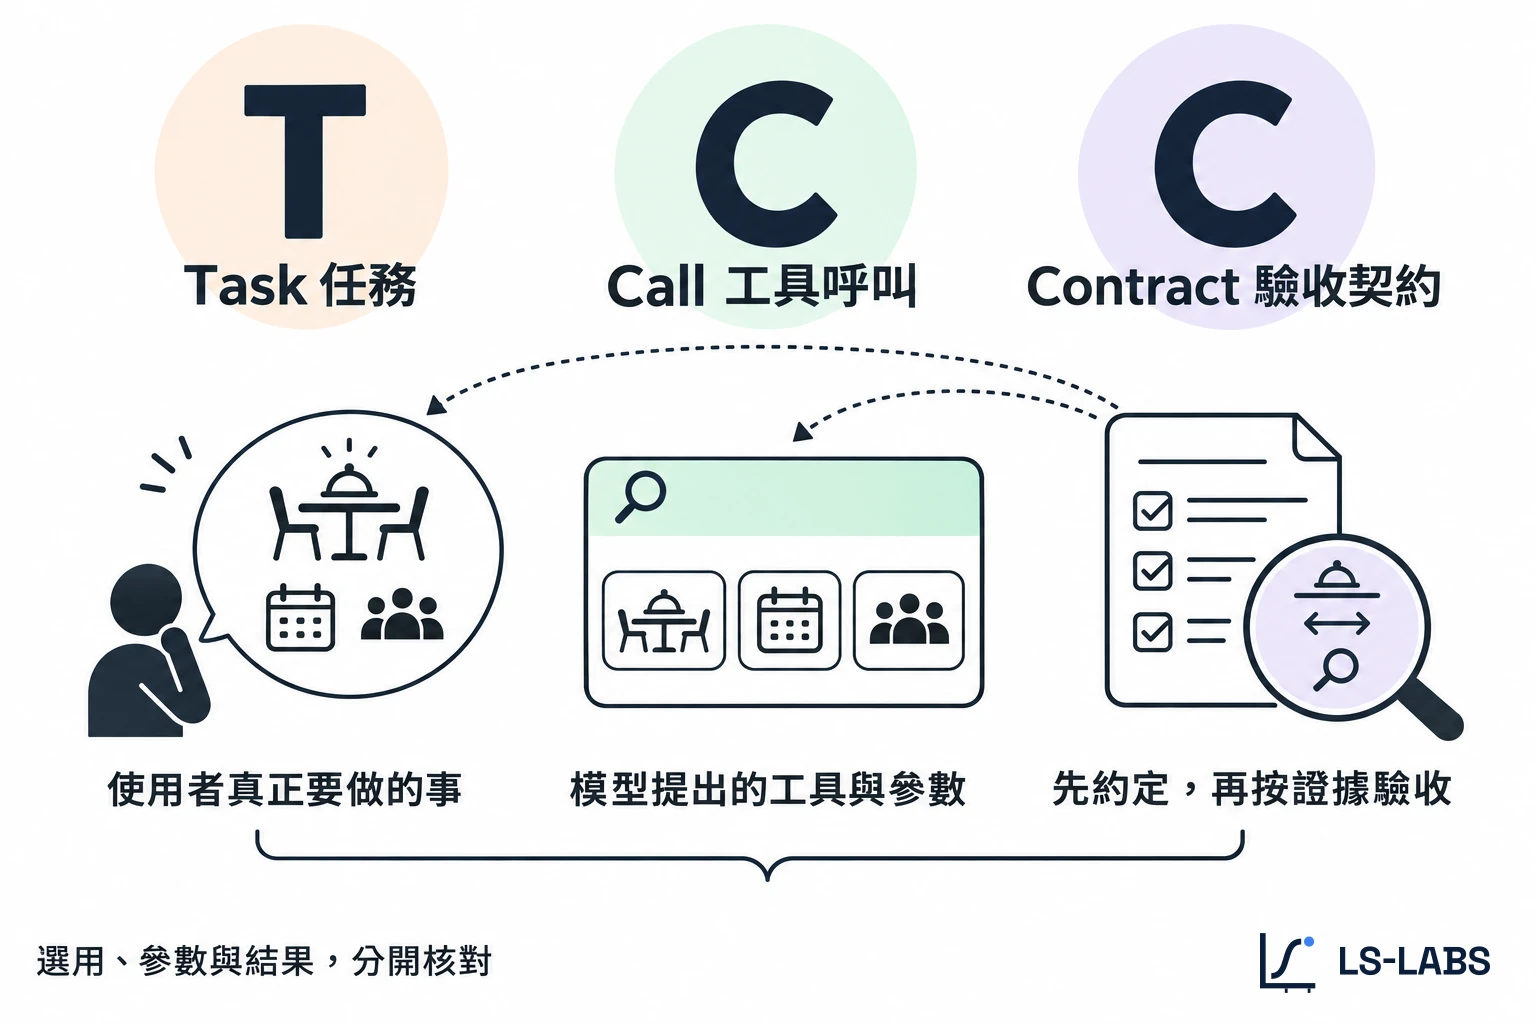
TSO 偏重工具被發現與選用的機制,TCC 則將選用納入完整任務流程,進一步驗證呼叫與結果是否正確。兩者有重疊的觀測範圍,但處理的問題層次不同。TCC 的操作方式,是在測試開始之前,先為每個任務建立一張題卡。題卡不只記錄使用者說了什麼,還要事先固定模型版本、工具定義、測試環境,以及預期的工具選擇、參數與回傳結果。測試完成後,再根據實際取得的紀錄逐項核對。TCC 把驗收分成兩個主要面向。
| 驗收面向 | 開始前需要定義什麼? | 測試後如何確認? |
|---|---|---|
| 任務適用性可判定 | 哪支工具適合任務?什麼情況應先追問或停止? | 查付款狀態應選唯讀工具;缺少發票編號應追問;要求作廢但沒有相應能力時,不應呼叫現有工具。 |
| 呼叫與結果可驗證 | 正確參數、回傳語意與後台狀態應該是什麼? | 核對呼叫參數、模型判讀與執行紀錄;沒有取得後台證據的項目,標記為「未測」。 |
這裡有一個重要區別。模型沒有選錯工具,不等於它真的完成任務;模型宣稱完成,也不能取代後端的執行紀錄。因此,TCC 不會把缺乏觀測資料的項目推定為成功。能直接驗證的部分才列入通過或失敗,其餘保留「未測」狀態。工具描述如何影響召回與首選,可對照只修改 Tool Description 的控制實驗,分清工具是否進入候選與模型最後選了誰。
實驗設計:152 筆請求,檢查工具選用與結果判讀
這套框架能不能協助開發者改善工具定義?為了觀察實際效果,這份研究設計了兩組對照測試,分別檢查模型在呼叫之前如何選擇工具,以及取得結果之後如何理解回傳語意。相關研究也曾指出工具描述品質的重要性。例如,Hasan 等人的研究分析了 103 個 MCP 伺服器、856 支工具的描述,並進一步評估描述品質與任務執行表現之間的關係。不過,對實際開發工具的人而言,除了知道描述品質重要,更需要一套能重現錯誤、比較改寫效果的驗收方法。
因此使用合成工具,建立「餐廳訂位」與「發票帳務」兩個情境,分別設計描述含糊的版本,以及能力邊界較清楚的版本。實驗於 2026 年 11 月 5 日進行,使用 Gemini 3.1 Flash-Lite,並同時測試繁體中文與英文。總計發出 152 筆正式 API 請求。另外有 2 筆前期預檢,以及 1 次尚未送達供應商便發生的本機 DNS 錯誤,均單獨記錄,沒有納入正式測試分母。
第一組:工具選用驗收(96 筆)
這組測試觀察模型能否根據使用者需求,正確決定要使用哪支工具。每個「場景 × 語言」組合安排六道題目,涵蓋正常讀取、使用者已確認的寫入、缺少必要資料,以及超出工具能力的請求。測試準備了兩種工具定義:一種讓兩支工具的描述高度重疊,另一種則清楚標示各自的用途與限制。同時,每道題都調換兩支工具的排列順序,降低候選順序對結果的干擾。測試因此形成每種條件各 48 筆、合計 96 筆請求。評分不只看模型有沒有選對工具。對於應該呼叫的任務,首選工具與參數必須完全正確;如果需要追問或停止,模型則必須輸出預先規定的標記。
第二組:結果判讀驗收(56 筆)
第二組不再測試工具選擇,而是固定查詢工具與參數,觀察模型能否正確理解後端回傳的狀態碼。每個場景與語言組合都測試三種合法狀態,各使用兩組數字代碼,再加入一個越界錯誤碼,形成每組七筆請求。兩個條件接收相同的數字,差別只在工具定義是否附上狀態碼說明。有提供碼義時,模型應依照定義解讀;沒有提供碼義時,面對無法確認的合法代碼,則應回報「無法判定」,而非自行猜測。兩個條件各 28 筆,合計 56 筆。整體而言,這 152 筆請求測量的是模型的呼叫決策與回傳判讀,沒有真的執行付款或訂位。
實驗結果:清楚的能力邊界,降低錯誤呼叫
先看工具選用的結果。當兩支工具的描述含糊重疊時,在 32 筆不應執行寫入的請求裡,模型有 12 筆提議呼叫寫入工具。改寫工具定義、明確區分唯讀與寫入用途後,同類錯誤降至 0 筆。換句話說,描述重疊的風險不只是選錯工具,而是直接跨過唯讀與寫入的界線。這也是為什麼能力邊界必須在工具定義裡先說清楚,而不能留給模型從上下文猜測。
整體選用驗收的通過數,也從原本的 28/48 提升至 46/48。這個改善不是因為模型忽然更聰明,而是工具定義把「該不該呼叫」與「該呼叫哪一支」寫得更清楚;換句話說,契約先把決策邊界固定下來,模型才有穩定判斷的依據。後續仍要拆開看哪些題型受益、哪些題型退步,才能知道下一個要修的是描述、參數,還是缺少資料時的處理規則。
查看完整數據:表一|四個場景與語言組合的兩路驗收
| 測試場景 | 選用驗收:描述重疊 → 用途明確 | 結果判讀:無碼義 → 有碼義 |
|---|---|---|
| 餐廳/繁中 | 8/12 → 11/12 | 3/7 → 7/7 |
| 餐廳/英文 | 8/12 → 12/12 | 3/7 → 7/7 |
| 發票/繁中 | 6/12 → 11/12 | 3/7 → 7/7 |
| 發票/英文 | 6/12 → 12/12 | 3/7 → 7/7 |
| 合計 | 28/48 → 46/48 | 12/28 → 28/28 |
在 48 組配對測試中,有 20 組改善、26 組維持相同結果,另外 2 組退步。這兩筆失分都發生在缺少必要資訊的題目。其中一筆是使用者沒有提供餐廳分店,模型卻自行填入「總店」;另一筆則是模型以繁體中文詢問發票編號,語意雖然正確,卻沒有輸出測試協定要求的 CLARIFY 標記。這顯示,工具契約除了說明什麼情況不能直接執行,也需要定義缺少資訊時該如何處理。不過,第二筆更接近協定格式錯誤,而非完全不理解使用者意圖。這也是 TCC 將驗收條件事先固定的原因:不同類型的失敗應分開記錄,才能知道真正需要改善的是哪一部分。
補上狀態碼定義,判讀通過數從 12 筆提高到 28 筆
在結果判讀測試中,兩個條件的差距更加明顯。沒有提供狀態碼說明時,28 筆測試只有 12 筆通過;補上碼義後,同一批條件下的 28 筆全部通過。這表示同一組狀態碼只要缺少語意,模型就可能把不確定誤判成確定;回傳格式不是工程細節,而是模型能否正確交差的語意介面。因此,補上碼義不只是增加文字,而是把「不確定」從模型的自由猜測,轉換成可被驗收的狀態判斷。
其中一個例子來自餐廳英文題。工具回傳狀態碼 17,實際定義為連線逾時,但模型在沒有相關說明時,直接回答使用者「還有空位」。這不是單純的措辭問題,而是模型把無法確認的系統狀態,解讀成了肯定的查詢結果。當工具定義補上 17 的正確語意後,模型才依照契約回報逾時狀態。從這兩組結果可以看出,工具描述的改善不只是增加文字量,而是讓模型取得原本缺少的判斷依據。能力邊界影響模型該不該呼叫、該選哪支工具;回傳語意則影響它如何理解工具執行後的狀態。但本次改寫同時調整了工具名稱、描述及相關結構,並沒有單獨隔離每個欄位的效果。因此,結果支持的是整組工具定義改寫帶來的改善,尚不能判定某一個欄位的影響最大。
實務示範:重新設計一支查詢餐廳空位的工具
研究結果要如何應用到實際開發?以餐廳訂位為例,一支工具如果只被描述為「提供餐廳訂位相關服務」,模型很難知道它究竟是查詢空位、查詢既有訂單,還是直接建立訂位。比較好的做法,是讓名稱、描述、輸入與輸出互相對應,減少模型需要自行推測的部分。因此,這一節不是文案示範,而是把同一支工具的能力、輸入與輸出重新寫成模型可以判讀的規格。
| 欄位 | 改寫前(Before) | 改寫後(After) |
|---|---|---|
| 名稱 | restaurant_service |
find_available_tables |
| 描述 | 提供餐廳訂位相關服務。 | 依分店、用餐日期與人數查詢可訂時段。僅提供唯讀查詢,不建立或修改訂位。 |
| 輸入 | query 接受一段文字。 |
restaurant_branch:分店全名;dining_date:分店當地日期,格式為 YYYY-MM-DD;party_size:含兒童的正整數人數。三欄必填,缺少分店資訊時須先詢問。 |
| 輸出 | 未交代回傳格式。 | 成功時回傳時區與可訂時段清單;available 表示至少有一筆時段,no_slots 表示查詢成功但沒有空位;上游逾時應以工具錯誤回報。 |
改寫後,模型不需要再從模糊的「訂位相關服務」推測工具功能,而能直接從定義辨識它是唯讀查詢,以及呼叫前必須取得哪些資訊。實際導入時,還有兩件事值得注意。首先,工具名稱與參數結構可能已經形成既有客戶端的相容性約定。如果工具已經對外提供服務,直接改名或拆分欄位,可能造成舊版客戶端無法正常呼叫。較穩妥的方式,是在新版本提供更完整的工具定義,同時保留必要的相容入口,讓客戶端逐步遷移。其次,回傳結果應盡量採用明確的結構,而不是要求模型從自然語言或不明代碼自行推斷。
以 MCP 2025-11-25 規格為例,開發者可透過 outputSchema 定義結構化輸出的格式。對於上游連線逾時等執行錯誤,也應明確使用工具錯誤機制,例如 isError: true,避免與「查詢成功但沒有空位」混為一談。需要特別強調的是,工具說明並不能取代後端驗證。輸入格式、使用者權限及實際寫入範圍,仍然必須由伺服器檢查。TCC 的作用,是讓模型與開發者對正確行為有一致的判定依據,而不是把系統安全完全交給模型決定。
上線之前,先替工具建立一張 TCC 題卡
對已經有工具服務的開發者來說,不一定要重新設計整套 API 才能開始測試。比較實際的做法,是從現有的使用情境挑出一個具體任務,先建立題卡,確認模型能否按照預期操作。例如,使用者提出以下要求:「海風餐室信義店 2027 年 1 月 15 日四位有空位嗎?」這句話看似簡單,卻包含了分店、日期與人數三個必須正確傳遞的資訊。如果模型選對工具,卻把分店填成其他地點,仍然應該判定為參數錯誤。若後端查詢逾時,模型也不應自行回答有位子。一張基本的 TCC 題卡,可以先記錄以下資訊。
| 題卡欄位 | 預先定義的內容 |
|---|---|
| 能力證據 | 附上工具確實只有讀取權限的程式碼或測試紀錄,並標記已核對、未知或與描述矛盾。 |
| 任務與環境 | 保留完整題目、語系、模型及客戶端版本、工具定義、候選順序,以及測試用的授權與模擬資料。 |
| 預期選用 | 只呼叫 find_available_tables 一次,不得建立訂位。 |
| 預期參數 | 分店為「海風餐室信義店」,日期為 2027-01-15,人數為整數 4。 |
| 預期判讀 | 若模擬結果顯示當地時間 18:30 有空位,模型必須正確回報該時段;若逾時則不得宣稱有位。 |
| 預期狀態 | 查詢前後的訂位資料不得改變,並以後台紀錄確認。缺少證據的項目標記為「未測」。 |
如果要測試使用者忘記提供分店的情況,就另外建立一張題卡,將預期行為設為先詢問分店,並要求工具呼叫次數為零。這樣做的好處,是能把不同錯誤分開觀察,而不會把所有失敗都歸因於「模型沒有理解需求」。換句話說,題卡不是多寫一份文件,而是把預期行為、容許誤差與失敗分類先固定下來,避免跑完才回頭解釋結果。這樣同一張題卡才能在不同版本與不同模型之間重複比較。
可複製的 TCC JSON 模板
展開 JSON 題卡、觀測範例與比對指令
以下提供一份通用題卡,以查詢記錄 DEMO-001 為例。
開跑前先填入 expected,固定正確行為,再將模型的實際呼叫與後端觀測結果另外存檔。這樣才能比較預期與實際結果,避免測試完成後才依照模型的表現調整評分標準。
{
  "tcc_version": "0.1",
  "case_id": "example-read-record",
  "locale": "zh-TW",
  "task": "查詢記錄 DEMO-001 的狀態。",
  "context": {
    "client": "填寫客戶端與版本",
    "model": "填寫模型與設定版本",
    "tool_set_ref": "填寫工具定義版本或 SHA-256",
    "fixture_ref": "填寫凍結的測試資料、授權、回傳與前後狀態",
    "mode": "fixture"
  },
  "evidence_gate": [
    {
      "claim": "查詢工具只讀取記錄。",
      "evidence_ref": null,
      "status": "unknown"
    }
  ],
  "checks": [
    {
      "id": "tool-choice",
      "axis": "task_fit",
      "condition": "只查詢指定記錄",
      "expected": {
        "decision": "read",
        "call_count": 1
      }
    },
    {
      "id": "arguments",
      "axis": "call_result",
      "condition": "固定查詢工具",
      "expected": {
        "arguments": {
          "record_id": "DEMO-001"
        }
      }
    },
    {
      "id": "result",
      "axis": "call_result",
      "condition": "查詢逾時,無法確認狀態",
      "expected": {
        "label": "TIMEOUT"
      }
    },
    {
      "id": "state",
      "axis": "call_result",
      "condition": "比對執行前後的寫入紀錄",
      "expected": {
        "write_count": 0
      }
    }
  ]
}
實測產生的觀測 JSON,可以使用檢查項目 ID 作為鍵值,例如:
{
  "tool-choice": {
    "decision": "read",
    "call_count": 1
  }
}
在 LS-Labs 研究工作區中,可以使用 Node.js 24 執行以下指令,比對題卡與實際觀測結果:
node research/tool-metadata-framework-2026-11-05/tcc/replay-tcc.mjs --compare my-card.json observations.json
比對程式會將沒有取得觀測資料的項目標為「未測」,而不是直接算作通過。工具實際執行與否、後台是否產生狀態變更,也需要各自提供證據。
將 TCC 納入工具上線檢查
除了個別題卡,LS-Labs 建議開發者在工具上線或改版前,至少檢查四個面向。以下四項檢查的順序,是先降低誤觸風險,再處理缺資料、例外狀態與版本比較。如果只測正常成功案例,很容易高估工具定義的完整度,也看不出模型在邊界情境下會怎麼出錯;因此,這四項應該一起跑,而不是挑其中一項當作上線前的最後檢查。換句話說,檢查清單不是上線前的形式檢查,而是把工具契約從文件帶進可重跑的測試流程。
將容易混淆的工具一起測試。讓唯讀查詢與修改寫入工具同時出現在候選清單中,涵蓋正常操作、缺少必要資料及超出能力的請求,確認模型能否辨識差異。
驗證後端是否能拒絕不合法操作。在測試環境確認伺服器能擋下缺少欄位、參數格式錯誤及未授權的寫入。即使模型提供的參數格式合法,也要核對它是否符合使用者原本的要求。
分開測試成功、無資料與執行失敗。例如餐廳查詢應分別模擬有空位、沒有空位與連線逾時,觀察模型能否正確區分。涉及寫入的任務,還要核對執行前後的後台狀態。
維持改版前後的測試條件一致。固定題目、模型設定、工具候選順序與測試資料,保存原始請求、模型回應及後台紀錄。選用、參數、判讀與任務完成應分開計分,避免單一成功率掩蓋不同類型的問題。
如果任務涉及訂位、付款或修改資料,驗收條件還需要更加嚴格。至少必須確認使用者已授權相關操作、後端狀態符合預期,以及 AI 對使用者的回報與實際狀態一致。任何一項缺少證據,都不應直接判定為完成。這也是為什麼 TCC 要把「未測」保留為獨立狀態,而不是把沒有證據的項目算成通過。只要缺少後端狀態或授權紀錄,就不能用模型的流暢回覆替代驗收。
讓 AI 找到工具,只是任務的開始
回到最初那張發票。使用者要作廢發票,AI 卻提議送出付款,背後反映的是工具能力邊界不夠明確。模型不知道目前有哪些操作被允許,也無法確認哪一支工具真正符合使用者的目的。當工具定義清楚區分唯讀與寫入,並交代缺少資料時應如何處理,模型就能減少不必要的推測。當回傳狀態也具有明確語意,AI 才能更可靠地向使用者說明事情究竟辦到了哪一步。在這次測試中,工具選用的通過數從 28/48 提升至 46/48,結果判讀則從 12/28 提升至 28/28。它們並不能保證正式環境中的任務一定成功,但至少證明,許多表面上像是模型判斷失誤的問題,能透過改善工具定義獲得緩解。
隨著 AI 開始透過工具處理更多實際任務,開發者需要關注的,也不再只是如何讓模型找到自己的服務。TSO 用來研究 AI 如何選擇工具;TCC 則進一步確認,模型選中的工具是否被正確使用,以及任務結果能否被驗證。工具被選中是一個起點。真正值得驗收的,是使用者交付的事情有沒有被正確處理。若流程還包含網頁操作、委託授權與交易確認,可接著看從可供性理解 AX 的訂位實驗,檢查工具呼叫之外的完成條件。
主題閱讀:TSO 閱讀指南 · 首頁 AI 搜尋地球
研究資料與來源
- LS-Labs(2026-11-05)。餐廳與發票的雙語缺陷挑戰。審稿用紀錄含樣本、分組結果與限制。研究 ID 為
tool-metadata-transfer-2026-11-05。 - Anthropic。Claude 工具搜尋文件。用於說明延後載入的工具在何時提供給模型。
- LS-Labs(2026-11-05)。任務呼叫契約 v0.1。詞條、模板與四張題卡的審稿用紀錄。
- LS-Labs(2026-11-05)。工具描述等長對照。研究 ID 為
tool-description-length-control-2026-11-05。 - Hasan 等人(2026)。Model Context Protocol (MCP) Tool Descriptions Are Smelly!。arXiv 預印本,表 7 列出任務成功率差異。
- Model Context Protocol(2025-11-25)。Tools 規格。參照輸出 Schema、工具錯誤及伺服器驗證。