文章目錄文章開頭0%
週五晚上的訂位,AI 挑了別家
週五下班前,你對手機裡的 AI 助理說:「幫我查一下大安區的晴丘小館,這週五晚上七點、四個人還有沒有位子?」AI 很快答應幫忙,接著卻打開了另一家訂位服務,或者乾脆回覆「目前沒有找到合適工具」。對使用者來說,這只是一次不太順利的使用體驗。但站在工具開發者的角度,事情就沒那麼簡單了。API 健康檢查正常,工具也確實存在於安裝清單中,連功能描述都寫得清清楚楚,模型卻沒有發出任何呼叫。後台沒有錯誤訊息,也沒有失敗的請求紀錄,因為這支工具根本沒有得到被執行的機會。
在 AI 應用逐漸具備自主使用工具的能力後,這類問題值得重新檢視。過去開發者通常關注 API 能否正常運作、參數是否正確,如今還多了一個前置條件:模型是否願意選擇你的工具?工具名稱、功能描述與參數結構,都可能影響模型對工具能力的判斷。其中,Tool Description 是開發者相對容易調整的欄位,也因此成為一個值得驗證的切入點。LS-Labs 以此設計了一組控制實驗,試圖回答:在工具功能與參數結構不變的情況下,只修改 Tool Description,能不能改變 AI 的工具選擇?
結果相當明顯。在一組等長描述對照中,兩段文字同樣只有 22 個中文字,明確寫出任務輸入的版本,在 96 次適用題測試中被首選 71 次;內容較為空泛的版本則只有 41 次,相差 31.25 個百分點。不過,模型最終有沒有呼叫工具,其實是多個階段共同作用的結果。如果不先釐清工具是在哪個環節失去機會,單靠修改 Description,未必能解決問題。
工具沒被呼叫,不代表模型不喜歡它
一支工具從接入系統到真正被執行,中間可能經過數次篩選。假設 AI 應用接入了數十支甚至上百支工具,系統未必會在每次對話時,都把所有工具的完整定義交給模型。有些應用採取直接載入的方式,讓模型從固定清單中挑選;另一些則會先根據使用者需求搜尋工具目錄,只載入少數相關候選。這種分流不只影響工具能否被看見,也決定開發者該先修檢索、描述,還是後端的執行流程。
這使得「沒有呼叫」至少存在兩種解釋。第一種是工具沒有進入本輪候選清單,模型根本不知道它可以使用。第二種則是工具已經被載入,但模型比較了幾個選項後,選擇呼叫其他工具。前者涉及候選召回,後者才是模型選擇。兩者的差異,可以借用資訊檢索的概念理解。搜尋引擎必須先找出可能相關的網頁,才能進一步排序;同樣地,一支工具如果沒有被納入候選,後續描述寫得再完整,也沒有機會影響這次決策。因此,本文將工具呼叫前後的過程,拆成四個便於觀察的階段。
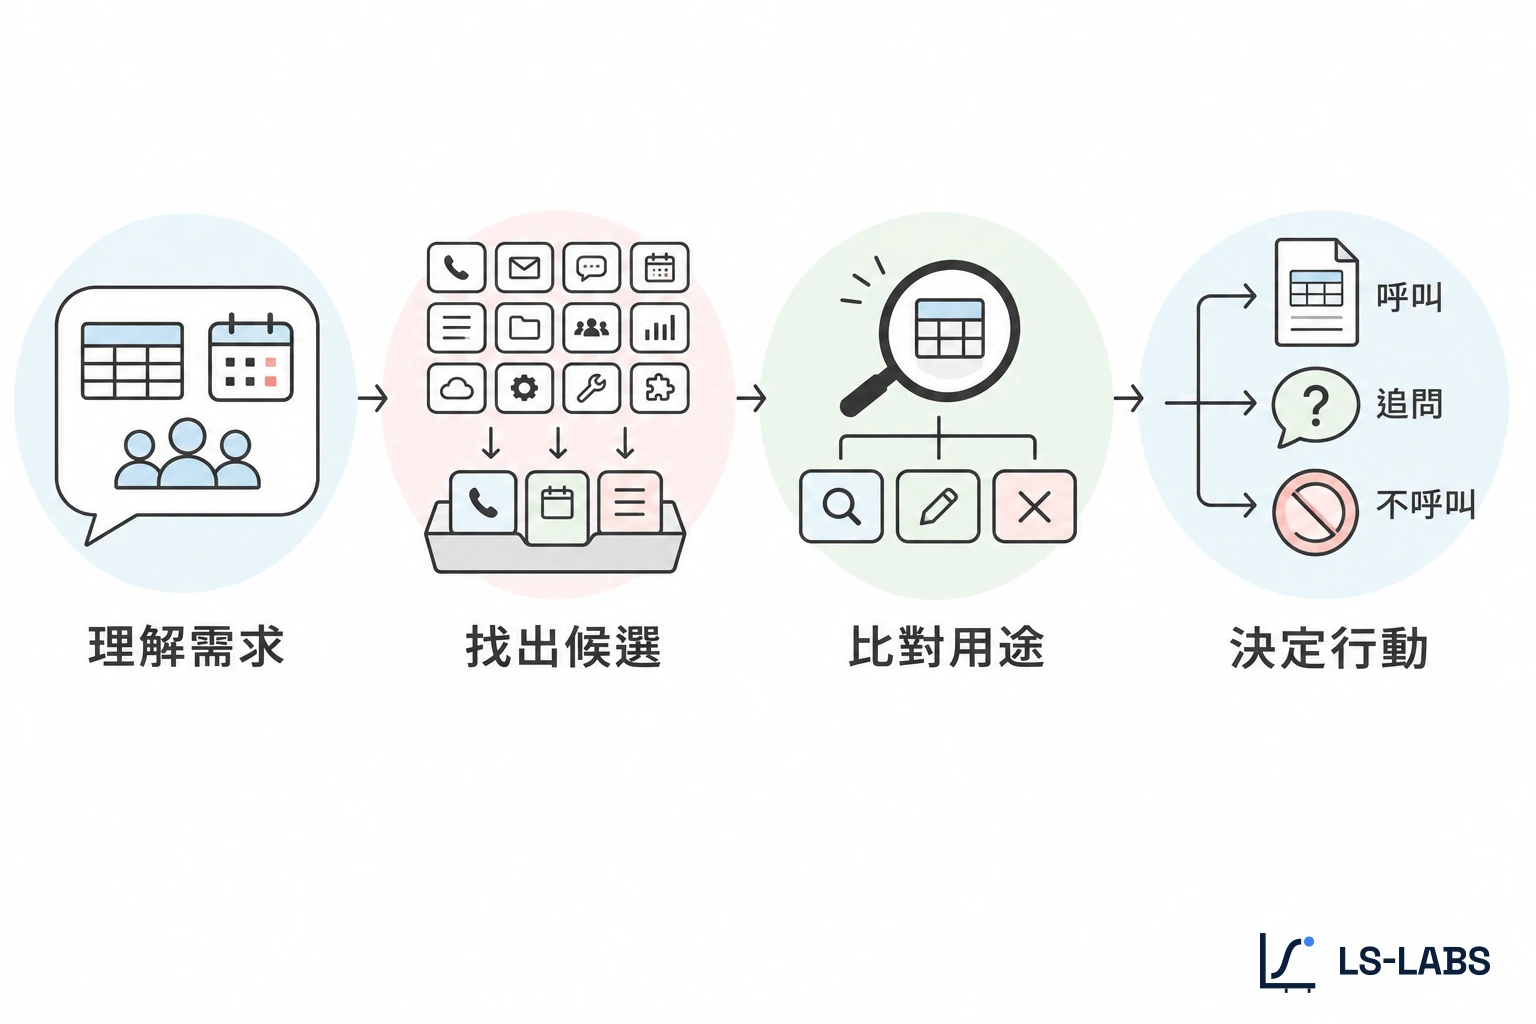
首先是需求表示。使用者說「今晚四個人還有沒有位子」,模型需要理解這是查詢空位;如果改成「取消我原本訂的那桌」,任務就變成修改既有訂位。兩句話雖然都與餐廳有關,對應的操作卻截然不同。接著是候選召回。系統根據可用工具清單與當前需求,決定哪些工具有機會進入模型的工作範圍。這個步驟可以由外部檢索器完成,也可能根本不存在獨立的檢索流程。當候選工具確實出現在模型上下文中,才進入這份研究關注的語意匹配。模型需要從名稱、Description 與參數 Schema 等資訊,理解每支工具的用途與使用條件。
例如,同樣是餐廳服務,party_size 暗示工具需要用餐人數,reservation_id 則通常代表操作對象是一筆已經存在的訂位紀錄。最後是最終決策。模型依照任務與候選資訊,決定是否提出工具呼叫,以及選擇哪支工具、填入哪些參數。真正的權限驗證、API 執行與結果回傳,仍由外部系統負責。這四個階段不是所有 AI 平台都會明確切分的執行流程,而是用來定位問題的分析框架。
對照 LS-Labs 的 TSO 四環節,候選召回大致屬於「候選曝光」;語意匹配與最終挑選則涉及「模型選擇」。模型提出工具呼叫後,才會進一步涉及參數填寫、呼叫驗證與實際執行。如果沒有先確認工具在哪一關失去機會,就很容易把曝光不足誤判成描述不夠吸引人;反過來,也可能花了大量時間改文案,卻沒有處理真正擋住工具的檢索條件。
Tool Calling、App 與 MCP,分別影響哪個環節?
這裡還有一個經常被混淆的問題:工具接入方式,不等於工具選擇機制。Tool Calling 通常指模型透過既定格式提出函式呼叫,由應用程式接手執行的能力。開發者可以直接提供工具定義,讓模型從中選擇,也可以搭配其他工具檢索機制。Plugin 或 App 則偏向產品層。使用者可能透過安裝、連結、授權或直接指定某個應用,改變模型可使用的服務範圍。但即使使用者已經連結某個 App,也不代表該 App 底下的每一項功能都會在每輪對話中載入。
至於 MCP(Model Context Protocol),主要解決的是 AI 應用如何與外部工具伺服器溝通。它定義了工具描述、參數 Schema、工具列表與呼叫等介面,卻沒有規定模型必須如何排序候選工具。換句話說,MCP 可以讓宿主取得工具清單,但宿主是否進一步篩選、何時載入工具,以及模型最終如何選擇,都可能取決於應用程式的設計。例如,同一套餐廳查空位服務,同時接入兩個 AI 應用。甲每輪都直接提供完整工具定義;乙則先搜尋工具目錄,再將符合需求的候選載入模型。
即使兩邊使用完全相同的 Description,一旦沒有發生呼叫,原因也可能不同。在甲的情況中,工具已經出現在模型面前,應優先調查模型的選擇行為;在乙的情況中,則必須先確認工具有沒有通過前面的檢索程序。這也是本次研究決定將「候選召回」與「模型首選」分開測量的原因。相關平台機制參考 OpenAI Function Calling、ChatGPT Apps 說明及 MCP Tools 規格。文件核對日期為 2026 年 11 月 5 日。
如何測試 Tool Description 的影響?
研究的控制原則很簡單:盡可能不改變工具真正能做的事情,只改變模型與檢索器看到的資訊。實驗分成兩部分。第一部分透過本機檢索器,測試不同 Description 是否影響工具進入候選清單的機會。第二部分則直接把候選工具交給語言模型,觀察它在功能相同的選項中,是否會因為描述不同而改變首選。兩組實驗刻意不串成同一套完整系統,目的是避免把檢索結果與模型偏好混在一起解讀。
先測工具能不能被找到
召回測試使用 60 支繁體中文合成工具,全部以代號命名,並建立 12 道測試題目。目標工具各準備兩種 Description。一種使用明確的任務語言,直接說明工具能處理的操作、對象與條件;另一種則採取偏向宣傳的寫法,強調服務體驗,卻沒有清楚交代實際能力。換句話說,這一階段測的不是 Description 寫得優不優美,而是它能不能在使用者的日常說法裡留下足夠的檢索線索。
檢索器使用本機 BM25,索引內容包含工具名稱、功能描述、參數名稱與參數說明。每次查詢最多取回前五支工具,得分為零的工具不納入候選。以 Recall@5 衡量結果,也就是在測試題中,有多少題成功把目標工具召回前五名。此外,為了觀察中文斷詞的影響,測試分別採用空白與標點切分,以及連續兩字切分。這個實驗不涉及語言模型,單純觀察工具描述在字面檢索時能否與使用者需求建立關聯。
再讓模型從三支工具中做選擇
第二部分使用 Gemini 3.1 Flash-Lite,提供三支功能相同的餐廳查空位工具,並直接將完整定義載入模型,不經過額外的工具搜尋。測試包含八道適合使用工具解決的題目,以及四道超出工具能力範圍的題目。每道題目在六種工具宣告順序下各執行兩輪,因此每個測試條件包含 96 筆適用題觀測與 48 筆超出能力題觀測。三批實驗合計發出 1,440 筆正式 API 請求。三批實驗分別檢驗不同的訊號。第一批比較基本描述、同義改寫,以及補齊任務輸入資訊的版本。
第二批進一步控制描述長度,將具體說明與等長中性描述對照,降低文字長度造成的干擾。第三批則將比較範圍擴展至 Tool Name、參數 Schema 說明與使用範例,觀察不同中繼資料欄位對選擇的影響。所有實驗都記錄模型提出的第一個函式呼叫。如果模型決定不呼叫工具,該次觀測仍保留在分母中。本文所稱的「指定工具首選率」,指的是某個測試條件下,模型第一次選中指定目標工具的比例。它不代表 API 已經成功執行,更不能直接解讀為最終任務成功率。
實驗一:工具描述太空泛,可能連候選名單都進不去
第一組結果顯示,Description 是否包含使用者可能使用的任務詞彙,會直接影響字面檢索結果。在連續兩字切分的設定下,任務語言版本於 12 道日常口語題中成功召回 3 題,口號式版本只有 1 題;換成第二版需求單後,兩者分別提高至 5 題與 2 題。但如果只依照空白與標點切分中文,兩個版本在合計 24 道題中的召回數都是零。
查看完整數據:表 1|BM25 候選召回 Recall@5
| 斷詞方式與題目版本 | 任務語言版 | 口號式版本 |
|---|---|---|
| 空白與標點切分(兩組合計) | 0/24 | 0/24 |
| 連續兩字切分(日常口語) | 3/12 | 1/12 |
| 連續兩字切分(第二版需求單) | 5/12 | 2/12 |
從個別題目可以看得更清楚。Q04 的提問是:「明天一早想從台北回台南,高鐵還買得到票嗎?」任務語言版本寫的是「查詢指定起訖站與日期的高鐵班次及剩餘座位」。因為描述包含「高鐵」,檢索器成功建立字面匹配,讓它排到第一名。另一個版本使用城市漫遊、美好旅程之類的描述,雖然可以讓人聯想到旅遊服務,卻沒有提供足夠的檢索線索。在這道題目中,60 支工具都沒有取得有效匹配分數。這不是模型理解能力不足,而是 BM25 原本就主要依賴詞項匹配。即使兩段文字在人類看來具有相近意涵,字面上沒有建立連結,檢索器也不一定能找到它。
更有意思的是餐廳題。Q01 使用「位子」、「吃飯」等日常說法,目標工具 Description 卻使用「訂位」與「用餐」。在連續兩字切分下,兩種描述都沒有成功召回目標工具。也就是說,Description 即使已經使用正確的專業詞彙,也可能因為與使用者實際用語不同,而錯失檢索機會。反過來,將斷詞切得更細,也可能產生沒有實際語意關聯的匹配。例如宣傳詞中的單一中文字,剛好與使用者提問中的名稱重疊,讓原本不相關的工具意外取得分數。
這顯示,檢索結果不能只看有沒有進入前五名,還需要檢查實際命中的欄位與詞項。不過,這組結果也有明確的適用範圍。它證明的是:在本機 BM25 字面檢索環境中,描述用語與斷詞策略都會影響候選召回。它沒有測量任何商用 AI 平台的實際工具曝光率,也不能直接推論語意檢索器會得到相同比例的改善。但對採用字面檢索或混合檢索的工具目錄而言,這是一個值得注意的問題。工具不只是需要說明自己能做什麼,也需要讓檢索系統有機會從使用者的語言中找到它。
實驗二:三支功能相同的工具,模型會選哪一個?
接下來將候選召回的干擾排除。這次模型每輪都能看到三支功能相同的餐廳查空位工具。三者具備相同的執行能力,差異主要來自實驗刻意調整的名稱、描述或參數資訊。如果模型的選擇分布發生變化,便能更直接地觀察中繼資料對首次工具選擇的影響。三批實驗的結果整理如下。為了讓差異只反映中繼資料,而不是任務或候選數量改變,後續三批實驗都維持相同的題庫、模型設定與三支候選工具。
查看完整數據:表 2|指定工具的首選變化與按題重抽區間
| 改動項目與比較基準 | 首選次數 | 差值(百分點) | 按題重抽的 95% 區間 |
|---|---|---|---|
| 同義改寫 vs 基本描述 | 31/96 vs 30/96 | +1.04 | −3.12 至 +5.21 |
| 補齊三項輸入 vs 基本描述 | 72/96 vs 30/96 | +43.75 | +38.54 至 +51.04 |
| 補齊三項輸入 vs 等長中性描述 | 71/96 vs 41/96 | +31.25 | +25.00 至 +37.50 |
| 動詞式工具名稱 vs 基本命名 | 96/96 vs 32/96 | +66.67 | +63.54 至 +69.79 |
| 補充參數 Schema 說明 vs 基本設定 | 61/96 vs 32/96 | +30.21 | +26.04 至 +34.38 |
| 加入使用範例 vs 基本描述 | 54/96 vs 32/96 | +22.92 | +19.79 至 +25.00 |
註:各列只比較同一批實驗內的條件,不應將不同批次的百分點差值直接當成統一效果排名。
同樣 22 個字,差別不在寫得多,而在說得清不清楚
這份研究最關注的是第二批等長對照。為了避免「描述比較長,所以模型更容易選中」這種解釋,實驗將兩組 Description 控制在相同的 22 個中文字,且每組配對請求的輸入 token 數一致。其中一個版本明確列出「餐廳名稱、用餐日期、人數」三項輸入資訊;另一個版本則使用較為中性的服務介紹,沒有具體交代操作條件。兩者的工具功能、參數結構與測試題目都沒有改變。結果,前者在 96 次適用題觀測中獲得 71 次首選,後者只有 41 次。31.25 個百分點的差距,不能用單純的文字長度解釋。
Description 提供的資訊越具體,模型就越容易將使用者需求與工具能力對上。例如,使用者提到四個人用餐,而描述剛好說明需要提供用餐人數,這兩個訊號之間便形成了直接關聯。相較之下,「提供便捷且優質的餐飲服務」這類文字,即使對人類讀者具有宣傳效果,也不一定能幫助模型判斷這支工具是否適合眼前的任務。這不代表模型一定是在進行某種固定的欄位比對,也無法據此還原它的內部推理過程。
能確認的是,在這組控制條件下,描述是否明確包含任務所需資訊,確實改變了模型的首選分布。同義改寫則沒有帶來相近效果。第一批實驗中,基本描述被首選 30 次,同義改寫版為 31 次,只增加 1.04 個百分點,95% 區間也跨過零。因此,本次結果並不支持「只要換一種說法,就能明顯提高工具首選率」的推論。真正拉開差距的是資訊內容,而非單純潤飾語句。
Tool Name 與參數說明,影響同樣明顯
第三批實驗把範圍擴大到 Description 之外。首先是工具名稱。當一支原本使用 service_a 這類代號的工具,改以 find_available_tables 命名後,在該批 96 次適用題觀測中,指定工具全部獲得首選;基本條件下則只有 32 次。這是本次訊號實驗中幅度最大的變化。這也是後續診斷要把名稱、描述、參數與範例分開觀察的原因。
不過,這裡需要特別注意:三支工具原本都使用代號命名,改成動詞式名稱,不僅增加了語意,也讓它在候選清單中顯得更加突出。因此,實驗尚不能確定首選增加有多少來自名稱與任務的語意匹配,又有多少來自模型對特殊命名形式的偏好。參數 Schema 的效果則比較容易理解。原本只提供 date、party_size 等欄位名稱;加入「用餐日期,YYYY-MM-DD」及「用餐人數,含兒童」等說明後,指定工具首選從 32/96 提高至 61/96。
工具功能並未改變,但輸入欄位的意義與使用方式變得更明確。使用範例也產生了影響。在 Description 結尾加入「例如:查詢某餐廳某日四人可訂的時段」,首選由 32/96 增加至 54/96。綜合三批實驗可以看到,模型並不是只憑工具名稱或單一描述做決策。名稱、Description、Schema 說明與使用範例,都可能成為判斷工具適用性的線索。這也解釋了為什麼工具能力完全相同,模型依然可能表現出明顯偏好。對模型而言,它接觸到的不是工具背後完整的程式碼,而是應用程式交給它的工具定義。當這些定義發生改變,即使後端服務絲毫未動,模型理解到的能力與適用情境仍可能不同。
首選率上升,不等於任務完成率上升
這組實驗還有一個容易被忽略的地方。在這組測試條件下,所有適用題都產生了符合測試要求的工具呼叫提案;超出工具能力範圍的題目,也沒有發生誤呼叫。因此,表 2 的差距主要反映的是:當多支工具都能完成相同任務時,模型將第一次呼叫交給誰。這與模型是否具備正確判斷工具適用性的能力,是兩個不同問題。因此,首選率只能回答偏好問題,不能回答任務成果。
如果三支工具的功能完全相同,模型從 A 改選 B,並不代表使用者一定獲得更好的結果。只有在真實服務情境下,候選工具的價格、延遲、資料品質、權限或執行能力存在差異時,選擇偏好才可能進一步影響任務成果。此外,實驗沒有連線至真實餐廳系統,也沒有實際完成查詢或訂位。測試檢查的是模型提出的呼叫提案與參數是否符合測試定義,而非外部系統是否成功執行。另一個需要注意的變數是模型既有的選擇偏好。在功能相同的工具之間,代號、宣告順序或命名方式,都可能影響模型的首選。這也是實驗採用多種宣告排列,並讓不同測試條件在相同題目中比較的原因。
如果只挑選少數問題測試,很容易把某個工具剛好被選中的結果,誤認成 Description 優化奏效。更完整的驗證方式,應該在同一組題目與候選配置下反覆比較,並記錄未呼叫、選擇其他工具與選中目標工具等不同結果。只有這樣,才能判斷觀察到的差異究竟來自描述調整,還是原本就存在的模型偏好。呼叫之後的參數與回傳判讀,可接著閱讀TCC 的 152 筆驗收測試;網站如何提供授權與完成憑據,則可對照AX 的本機訂位實驗。
從實驗回到實務,開發者應該先改什麼?
如果只看本次實驗,最容易得出的結論是:把工具描述寫具體一點,並盡量使用語意清楚的名稱與參數說明。這個方向沒有問題,但它仍然少了一個前提。不是每一次沒有呼叫,都適合透過修改 Description 解決。假設開發者發現某支訂位工具幾乎沒有使用紀錄,第一件事應該是確認它有沒有實際進入模型的候選清單。如果工具在檢索階段就被排除,應優先檢查索引內容、檢索用語、召回門檻與工具載入策略。這時候只修改模型看得到的 Description,卻沒有同步更新檢索索引,可能根本不會影響結果。
如果工具已經被載入,卻經常輸給其他功能相近的工具,才適合進一步比較名稱、Description、參數 Schema 與範例。例如,與其描述「整合各式餐飲需求,提供優質用餐體驗」,不如直接說明工具可以「查詢指定餐廳、用餐日期與人數的可訂時段」。但具體不代表把所有關鍵字都塞進 Description。工具真正能處理的任務、必要輸入與限制條件,仍然必須保持一致。尤其是查詢與寫入類操作。
「查詢目前可訂時段」、「建立訂位」和「取消既有訂位」可能涉及同一套後端服務,但代表完全不同的權限與操作風險。若描述沒有交代能力邊界,模型即使選中了工具,也可能在錯誤的情境下提出呼叫。至於工具已經被選中、卻沒有完成使用者需求的情況,問題則可能出在參數解析、授權、外部 API 或執行結果。這些都不是首選率能回答的問題。因此,與其只在後台顯示一個總呼叫次數,不如替工具呼叫流程保留四類紀錄:
- 任務適用性:這道題是否應該使用該工具,還是應先追問或拒絕呼叫?
- 候選曝光:工具是否實際進入這一輪載入給模型的候選清單?
- 模型選擇:第一次呼叫選了哪支工具?是否發生未呼叫或錯選?
- 執行結果:參數是否正確,外部服務是否執行成功,使用者任務是否完成?
這四類資訊可以讓開發者辨認,同樣一筆「沒有成功使用工具」的結果,究竟是哪個環節出了問題。也只有在知道問題發生在哪裡之後,Description 的修改才有明確的驗證目標。換句話說,四欄紀錄不是為了做報表,而是把優化目標從「讓呼叫變多」改成「讓每一個失敗都有可定位的原因」。只有先分清問題層次,Description 的調整才不會變成盲目試錯。
回到那個週五晚上
對準備訂餐廳的使用者來說,他不會知道背後有多少工具參與競爭,也不會在意開發者為了 Description 修改了幾個字。他只在意 AI 能否理解需求,找到正確服務,並確實完成查詢。但對工具開發者而言,這些看不見的選擇過程,可能決定一項服務有沒有機會被使用。本次實驗顯示,即使不修改後端功能,僅調整工具描述中的任務資訊,就能顯著改變模型的首選分布。這並不意味著所有工具都應該立刻重寫 Description。更值得先做的,是確定工具究竟在哪個環節失去了機會。
如果沒有進入候選名單,應處理檢索與曝光;如果進入候選卻沒有被選中,才需要檢查模型如何理解工具定義;如果已經被呼叫,則必須回到參數與實際執行結果。當工具選擇逐漸成為 AI 應用的常態,Tool Description 也不再只是寫給開發者閱讀的 API 文件。它同時是模型理解外部能力、判斷使用時機的一部分。哪怕只是短短幾十個字,都可能改變一支工具被使用的機會。
主題閱讀:TSO 閱讀指南 · 首頁 AI 搜尋地球
研究資料與來源
- LS-Labs(2026-11-05)。繁中工具候選召回模擬。研究 ID:
tool-recall-simulation-2026-11-05;含兩版查詢題與逐題排名。 - LS-Labs(2026-11-05)。工具描述首輪對照實驗。研究 ID:
tool-description-pilot-2026-11-05;比較基本描述、同義改寫與輸入資訊。 - LS-Labs(2026-11-05)。工具描述等長對照。研究 ID:
tool-description-length-control-2026-11-05;含字數、輸入 token 與配對結果。 - LS-Labs(2026-11-05)。工具中繼資料訊號實驗。研究 ID:
tool-metadata-signals-2026-11-05;比較名稱、參數說明與使用範例。上述研究的協定、分析與原始觀測保存在 LS-Labs 研究工作區。 - OpenAI。Function Calling。工具定義、模型呼叫提案與應用程式執行的分工。
- OpenAI。ChatGPT Apps 說明。應用連結與工具可用範圍。
- Model Context Protocol(2026-07-28)。Tools 規格。工具列表、描述、參數 Schema 與呼叫介面;平台文件核對日期為 2026 年 11 月 5 日。