文章目录文章开头0%
要作废发票,AI 却想付款
想象你请 AI 助手帮忙作废一张发票。它看完需求,没有告诉你做不到,而是直接提议调用“提交付款”工具。这个反应显然不太对劲。你要取消一笔账务,AI 却打算新增一笔付款。问题出在哪里?LS-Labs 在测试中发现,当两个工具的说明都写着“处理发票相关需求”,但其中一个只能查询付款状态,另一个却会真正提交付款时,模型就可能混淆两者的用途。
人类阅读完整的 API 文档,通常还能从其他信息判断工具的实际功能。但对模型而言,如果提供的名称、描述与参数没有清楚区分能力,两个工具看起来可能十分相似。在本次测试的四个“作废发票”案例中,模型全部提议使用付款工具。这也是 LS-Labs 提出 TCC(Task–Call Contract,任务调用契约)的起点。这项研究希望检查的,不只是 AI 能不能找到一个看似合适的工具,还包括它是否理解工具的能力边界、能否填入正确参数,以及拿到执行结果后,是否知道任务究竟完成了没有。
在 152 条双语 API 测试中,当工具的只读与写入用途被区分清楚,不当提议写入的次数从 12 次降至 0 次;补上返回状态码的定义后,结果判读的通过数则从 12/28 提升至 28/28。这些结果表明,工具定义的质量,可能直接影响模型的操作判断。不过,本次实验只观察模型提出的调用与结果判读,没有真正执行付款或订座,因此还不能把这些改善视为实际交易成功率的提升。
AI 使用工具,至少要通过五个环节
当用户要求 AI 查询餐厅空位、修改订单或处理发票时,看似只需要一次工具调用,背后却涉及好几个不同的判断。首先,AI 必须能看到合适的工具。接着,它要判断哪个工具符合需求,并把用户提供的信息转换成调用参数。工具执行之后,模型还得理解返回结果,才能决定如何向用户交代。这些环节即使只有一处出错,最后的回答都可能与实际状态不符。
| 检查环节 | 需要确认的问题 |
|---|---|
| 候选可见 | 模型做决定之前,实际拿到了哪些工具定义? |
| 工具选用 | 模型选了哪个工具?是否应该先追问,或根本不该调用? |
| 调用参数 | 分店、日期、人数或发票编号,是否符合用户的要求? |
| 执行与判读 | 后端是否执行成功?模型有没有正确理解成功、查无数据或超时等结果? |
| 任务完成 | 用户的目标是否达成?有没有相应的后台记录可以确认? |
以查询餐厅空位为例,模型即使选对了查询工具,也可能把“信义店”误填为“总店”。假如工具返回连接超时,模型却回答“晚上六点还有空位”,用户得到的仍然是错误信息。更麻烦的是,这类问题未必会在技术层面产生明显错误。工具可能正常响应,模型也生成了一段流畅的文字,却没有正确完成用户交付的任务。因此,工具优化不能只看调用是否成功,还必须检查模型在每个环节做出的判断是否合理。
工具说明不清楚,会出现什么问题?
本次研究刻意在工具定义中留下两类缺口,观察模型会如何反应。第一类发生在调用之前,主要是工具的能力边界不明确。例如,查询付款状态与提交付款是两种截然不同的操作,前者只会读取数据,后者则可能改变账务状态。如果两个工具都被描述成“处理发票相关需求”,模型就得自行推测哪一个更合适。在描述重叠的条件下,餐厅与发票场景合计 16 条只读查询中,有 8 条被提议发往写入工具;反过来,另外 16 条已获用户确认的写入请求,也有 8 条被提议发往读取工具。
这意味着模型不只可能做了不该做的事,也可能因为选错工具,而无法完成原本应该执行的任务。第二类发生在调用之后,问题出在返回结果缺乏明确语义。假设某个工具返回 HOLD_7,但工具定义没有解释这个代码究竟代表暂时保留、操作成功,还是某种失败状态。模型可能根据代码名称猜测,也可能试着从对话上下文推断,再把猜测整理成看似肯定的答案。测试中移除了状态码的定义。在 24 条使用合法状态码的请求里,有 16 条被模型直接推断为某个状态,而不是承认现有信息不足。
对用户而言,这种情况尤其难以察觉。因为系统没有明显报错,AI 也确实给出了一个答案,只是答案缺乏可靠依据。这两类问题指向同一件事:工具说明除了介绍功能,还需要让模型理解使用条件与返回结果。一份完整的工具契约,至少应该交代工具适用于哪些任务、需要哪些前提与参数,以及不同执行结果应该如何解读。换句话说,模型不是只需要知道“怎么调用”,还要知道“调用后看到什么算成功、看到什么该停手”。
从 TSO 到 TCC,建立可验收的工具契约
在先前的 TSO(Tool Selection Optimization,工具选择优化)研究中,关注的是 AI 如何发现工具、理解工具用途,并在候选列表中做出选择。但即使模型选中了正确工具,也不代表用户的任务就能顺利完成。例如,AI 已经选对查询工具,却填错发票编号;或者参数完全正确,但把超时响应误认为查询成功。这些问题都需要在工具选择之外,建立更细致的验收方法。
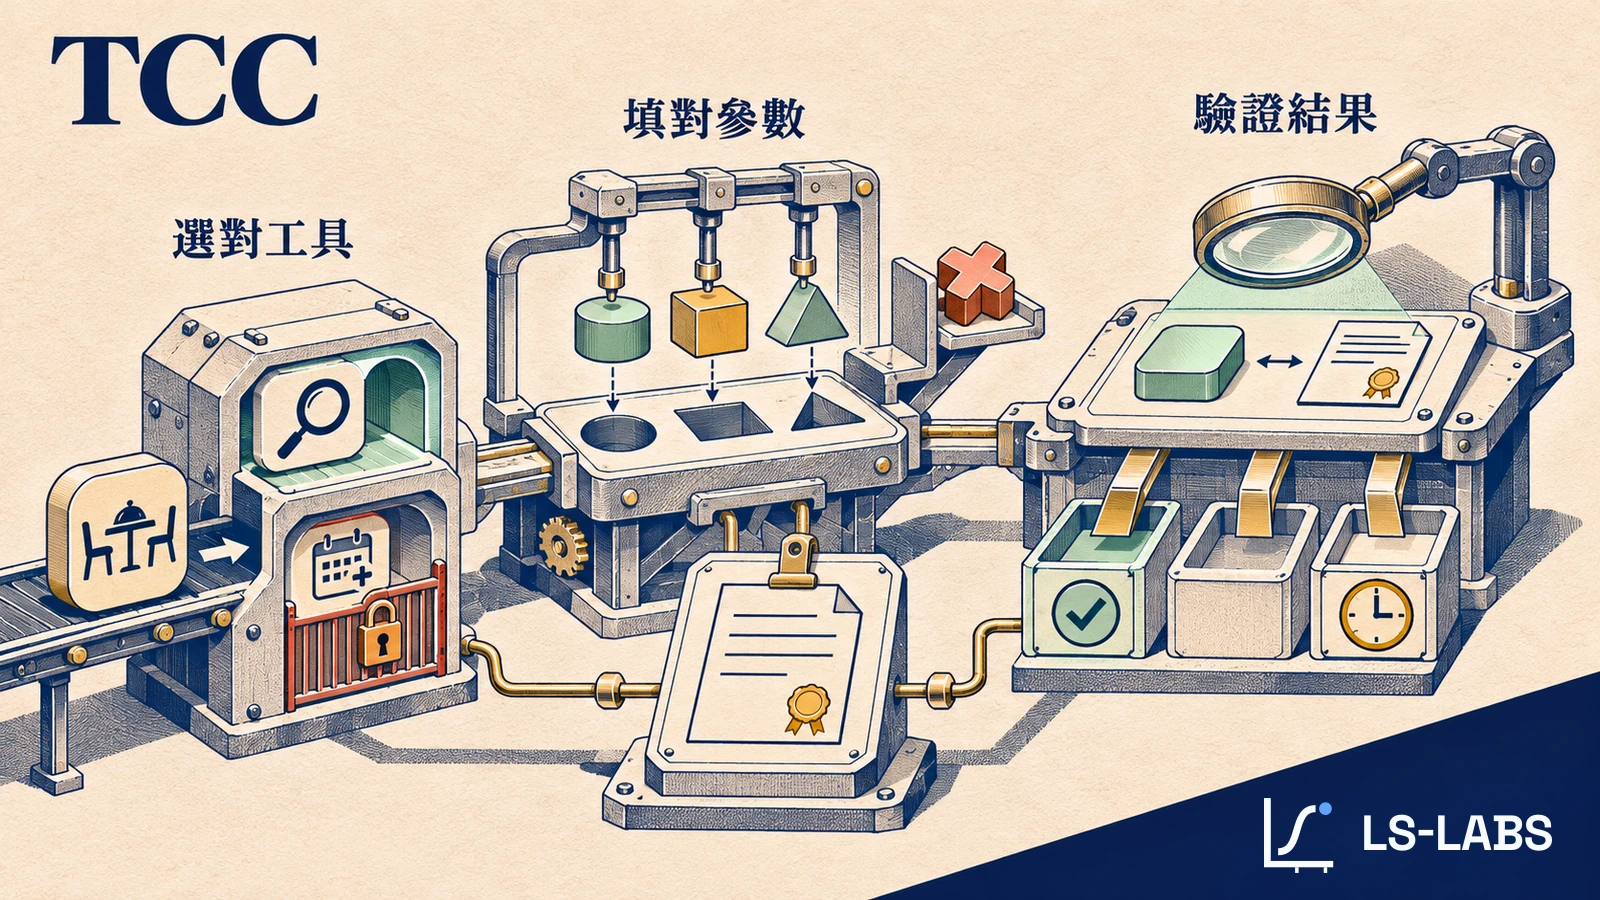
因此,LS-Labs 将 TCC 定义为一套以任务为单位的验收框架,检查模型的工具选用、参数、结果判读与实际完成状态是否符合预期。T 是 Task 任务,第一个 C 是 Call 工具调用,第二个 C 是 Contract 验收契约。契约在测试前定义,用来核对任务、调用与结果之间是否一致。这也让 TCC 能同时容纳模型行为与后端状态,而不是只看单一成功率。
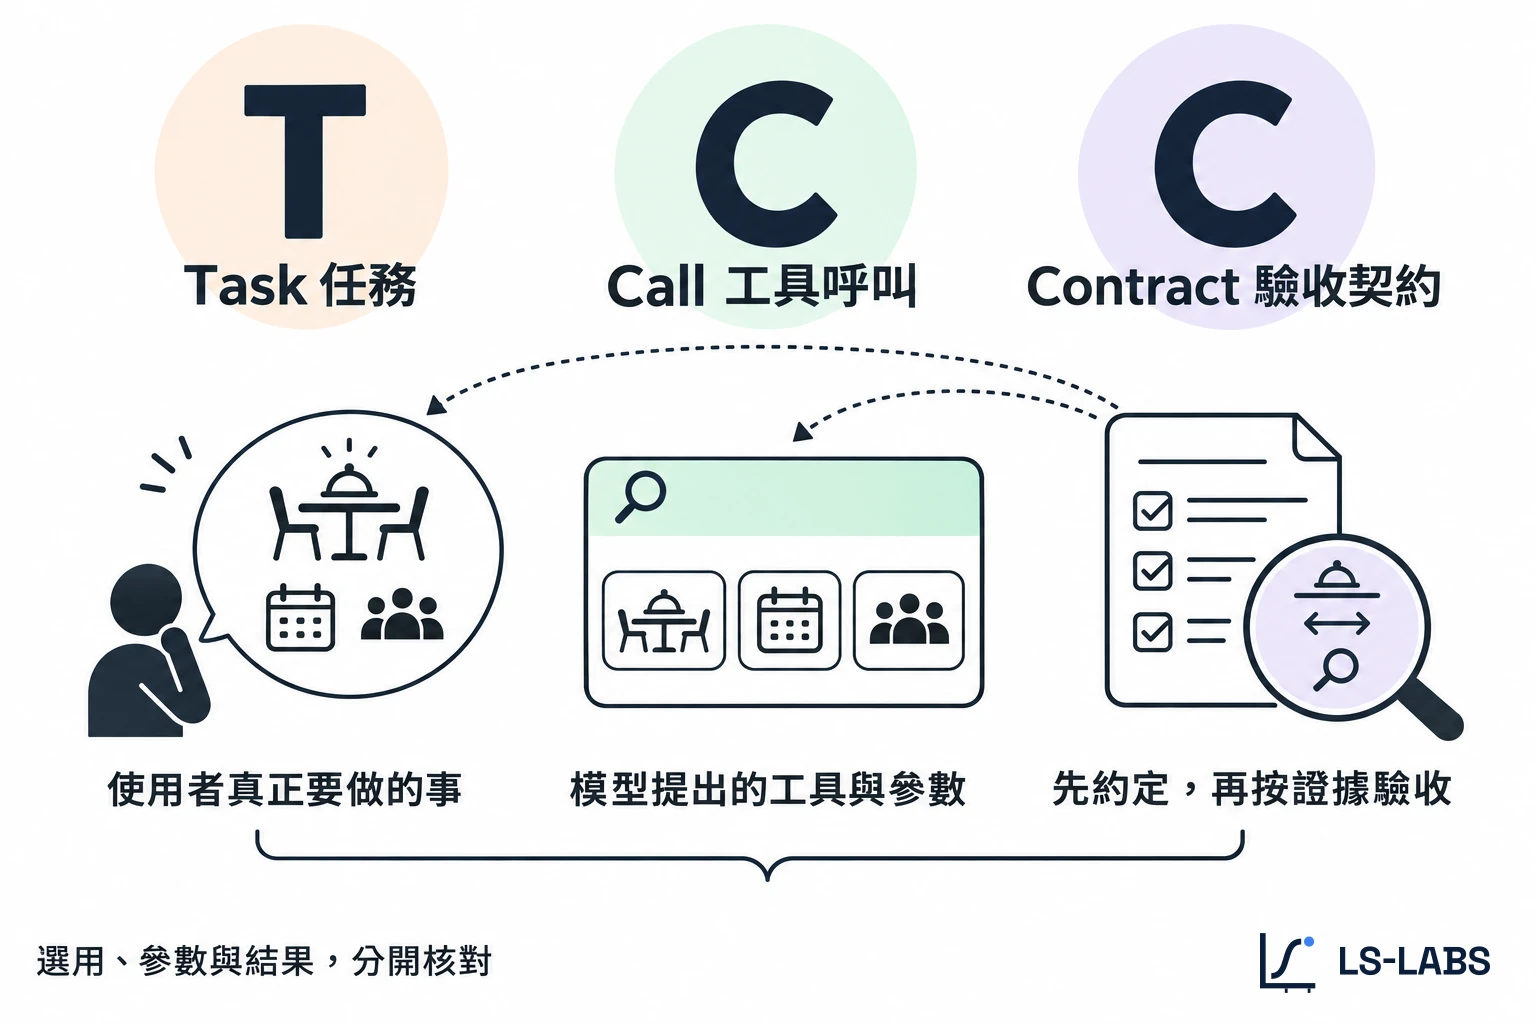
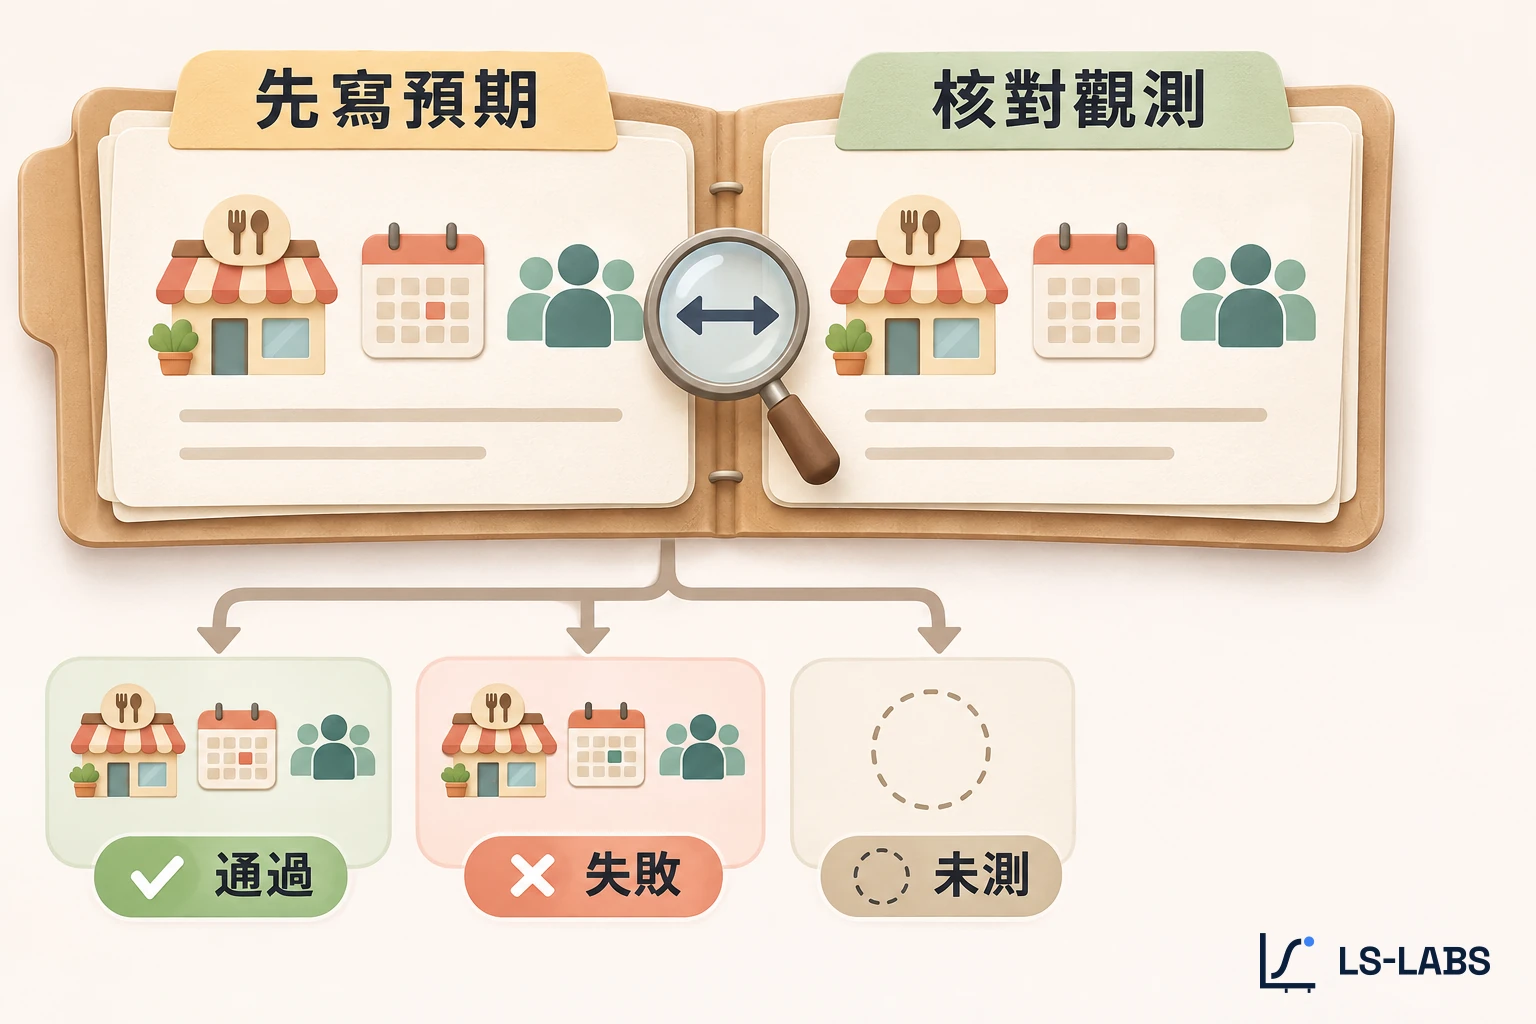
TSO 偏重工具被发现与选用的机制,TCC 则将选用纳入完整任务流程,进一步验证调用与结果是否正确。两者有重叠的观测范围,但处理的问题层次不同。TCC 的操作方式,是在测试开始之前,先为每个任务建立一张题卡。题卡不只记录用户说了什么,还要事先固定模型版本、工具定义、测试环境,以及预期的工具选择、参数与返回结果。测试完成后,再根据实际取得的记录逐项核对。TCC 把验收分成两个主要面向。
| 验收面向 | 开始前需要定义什么? | 测试后如何确认? |
|---|---|---|
| 任务适用性可判定 | 哪个工具适合任务?什么情况应先追问或停止? | 查付款状态应选只读工具;缺少发票编号应追问;要求作废但没有相应能力时,不应调用现有工具。 |
| 调用与结果可验证 | 正确参数、返回语义与后台状态应该是什么? | 核对调用参数、模型判读与执行记录;没有取得后台证据的项目,标记为“未测”。 |
这里有一个重要区别。模型没有选错工具,不等于它真的完成任务;模型声称完成,也不能取代后端的执行记录。因此,TCC 不会把缺乏观测数据的项目推定为成功。能直接验证的部分才列入通过或失败,其余保留“未测”状态。工具描述如何影响召回与首选,可对照只修改 Tool Description 的控制实验,分清工具是否进入候选与模型最后选了谁。
实验设计:152 条请求,检查工具选用与结果判读
这套框架能不能帮助开发者改善工具定义?为了观察实际效果,这项研究设计了两组对照测试,分别检查模型在调用之前如何选择工具,以及取得结果之后如何理解返回语义。相关研究也曾指出工具描述质量的重要性。例如,Hasan 等人的研究分析了 103 个 MCP 服务器、856 个工具的描述,并进一步评估描述质量与任务执行表现之间的关系。不过,对实际开发工具的人而言,除了知道描述质量重要,更需要一套能复现错误、比较改写效果的验收方法。
因此使用合成工具,建立“餐厅订座”与“发票账务”两个场景,分别设计描述含糊的版本,以及能力边界较清楚的版本。实验于 2026 年 11 月 5 日进行,使用 Gemini 3.1 Flash-Lite,并同时测试繁体中文与英文。总计发出 152 条正式 API 请求。另外有 2 条前期预检,以及 1 次尚未送达供应商便发生的本地 DNS 错误,均单独记录,没有纳入正式测试分母。
第一组:工具选用验收(96 条)
这组测试观察模型能否根据用户需求,正确决定要使用哪个工具。每个“场景 × 语言”组合安排六道题目,涵盖正常读取、用户已确认的写入、缺少必要数据,以及超出工具能力的请求。测试准备了两种工具定义:一种让两个工具的描述高度重叠,另一种则清楚标示各自的用途与限制。同时,每道题都调换两个工具的排列顺序,降低候选顺序对结果的干扰。测试因此形成每种条件各 48 条、合计 96 条请求。评分不只看模型有没有选对工具。对于应该调用的任务,首选工具与参数必须完全正确;如果需要追问或停止,模型则必须输出预先规定的标记。
第二组:结果判读验收(56 条)
第二组不再测试工具选择,而是固定查询工具与参数,观察模型能否正确理解后端返回的状态码。每个场景与语言组合都测试三种合法状态,各使用两组数字代码,再加入一个越界错误码,形成每组七条请求。两个条件接收相同的数字,差别只在工具定义是否附上状态码说明。有提供码义时,模型应依照定义解读;没有提供码义时,面对无法确认的合法代码,则应报告“无法判定”,而非自行猜测。两个条件各 28 条,合计 56 条。整体而言,这 152 条请求测量的是模型的调用决策与返回判读,没有真的执行付款或订座。
实验结果:清楚的能力边界,降低错误调用
先看工具选用的结果。当两个工具的描述含糊重叠时,在 32 条不应执行写入的请求里,模型有 12 条提议调用写入工具。改写工具定义、明确区分只读与写入用途后,同类错误降至 0 条。换句话说,描述重叠的风险不只是选错工具,而是直接跨过只读与写入的界线。这也是为什么能力边界必须在工具定义里先说清楚,而不能留给模型从上下文猜测。
整体选用验收的通过数,也从原本的 28/48 提升至 46/48。这个改善不是因为模型忽然更聪明,而是工具定义把“该不该调用”与“该调用哪一个”写得更清楚;换句话说,契约先把决策边界固定下来,模型才有稳定判断的依据。后续仍要拆开看哪些题型受益、哪些题型退步,才能知道下一个要修的是描述、参数,还是缺少数据时的处理规则。
查看完整数据:表一|四个场景与语言组合的两路验收
| 测试场景 | 选用验收:描述重叠 → 用途明确 | 结果判读:无码义 → 有码义 |
|---|---|---|
| 餐厅/繁体中文 | 8/12 → 11/12 | 3/7 → 7/7 |
| 餐厅/英文 | 8/12 → 12/12 | 3/7 → 7/7 |
| 发票/繁体中文 | 6/12 → 11/12 | 3/7 → 7/7 |
| 发票/英文 | 6/12 → 12/12 | 3/7 → 7/7 |
| 合计 | 28/48 → 46/48 | 12/28 → 28/28 |
在 48 组配对测试中,有 20 组改善、26 组维持相同结果,另外 2 组退步。这两次失分都发生在缺少必要信息的题目。其中一次是用户没有提供餐厅分店,模型却自行填入“总店”;另一次则是模型以繁体中文询问发票编号,语义虽然正确,却没有输出测试协议要求的 CLARIFY 标记。这表明,工具契约除了说明什么情况不能直接执行,也需要定义缺少信息时该如何处理。不过,第二次更接近协议格式错误,而非完全不理解用户意图。这也是 TCC 将验收条件事先固定的原因:不同类型的失败应分开记录,才能知道真正需要改善的是哪一部分。
补上状态码定义,判读通过数从 12 条提高到 28 条
在结果判读测试中,两个条件的差距更加明显。没有提供状态码说明时,28 条测试只有 12 条通过;补上码义后,同一批条件下的 28 条全部通过。这表示同一组状态码只要缺少语义,模型就可能把不确定误判成确定;返回格式不是工程细节,而是模型能否正确交差的语义接口。因此,补上码义不只是增加文字,而是把“不确定”从模型的自由猜测,转换成可被验收的状态判断。
其中一个例子来自餐厅英文题。工具返回状态码 17,实际定义为连接超时,但模型在没有相关说明时,直接回答用户“还有空位”。这不是单纯的措辞问题,而是模型把无法确认的系统状态,解读成了肯定的查询结果。当工具定义补上 17 的正确语义后,模型才依照契约报告超时状态。从这两组结果可以看出,工具描述的改善不只是增加文字量,而是让模型取得原本缺少的判断依据。能力边界影响模型该不该调用、该选哪个工具;返回语义则影响它如何理解工具执行后的状态。但本次改写同时调整了工具名称、描述及相关结构,并没有单独隔离每个字段的效果。因此,结果支持的是整组工具定义改写带来的改善,尚不能判定某一个字段的影响最大。
实务示范:重新设计一个查询餐厅空位的工具
研究结果要如何应用到实际开发?以餐厅订座为例,一个工具如果只被描述为“提供餐厅订座相关服务”,模型很难知道它究竟是查询空位、查询既有订单,还是直接创建订座。比较好的做法,是让名称、描述、输入与输出互相对应,减少模型需要自行推测的部分。因此,这一节不是文案示范,而是把同一个工具的能力、输入与输出重新写成模型可以判读的规格。
| 字段 | 改写前(Before) | 改写后(After) |
|---|---|---|
| 名称 | restaurant_service |
find_available_tables |
| 描述 | 提供餐厅订座相关服务。 | 按分店、用餐日期与人数查询可订时段。仅提供只读查询,不创建或修改订座。 |
| 输入 | query 接受一段文本。 |
restaurant_branch:分店全名;dining_date:分店当地日期,格式为 YYYY-MM-DD;party_size:含儿童的正整数人数。三个字段必填,缺少分店信息时须先询问。 |
| 输出 | 未交代返回格式。 | 成功时返回时区与可订时段列表;available 表示至少有一个时段,no_slots 表示查询成功但没有空位;上游超时应以工具错误报告。 |
改写后,模型不需要再从模糊的“订座相关服务”推测工具功能,而能直接从定义识别它是只读查询,以及调用前必须取得哪些信息。实际导入时,还有两件事值得注意。首先,工具名称与参数结构可能已经形成既有客户端的兼容性约定。如果工具已经对外提供服务,直接改名或拆分字段,可能造成旧版客户端无法正常调用。较稳妥的方式,是在新版本提供更完整的工具定义,同时保留必要的兼容入口,让客户端逐步迁移。其次,返回结果应尽量采用明确的结构,而不是要求模型从自然语言或不明代码自行推断。
以 MCP 2025-11-25 规范为例,开发者可通过 outputSchema 定义结构化输出的格式。对于上游连接超时等执行错误,也应明确使用工具错误机制,例如 isError: true,避免与“查询成功但没有空位”混为一谈。需要特别强调的是,工具说明并不能取代后端验证。输入格式、用户权限及实际写入范围,仍然必须由服务器检查。TCC 的作用,是让模型与开发者对正确行为有一致的判定依据,而不是把系统安全完全交给模型决定。
上线之前,先为工具建立一张 TCC 题卡
对已经有工具服务的开发者来说,不一定要重新设计整套 API 才能开始测试。比较实际的做法,是从现有的使用场景挑出一个具体任务,先建立题卡,确认模型能否按照预期操作。例如,用户提出以下要求:“海风餐室信义店 2027 年 1 月 15 日四位有空位吗?”这句话看似简单,却包含了分店、日期与人数三个必须正确传递的信息。如果模型选对工具,却把分店填成其他地点,仍然应该判定为参数错误。若后端查询超时,模型也不应自行回答有位子。一张基本的 TCC 题卡,可以先记录以下信息。
| 题卡字段 | 预先定义的内容 |
|---|---|
| 能力证据 | 附上工具确实只有读取权限的代码或测试记录,并标记已核对、未知或与描述矛盾。 |
| 任务与环境 | 保留完整题目、语言区域、模型及客户端版本、工具定义、候选顺序,以及测试用的授权与模拟数据。 |
| 预期选用 | 只调用 find_available_tables 一次,不得创建订座。 |
| 预期参数 | 分店为“海风餐室信义店”,日期为 2027-01-15,人数为整数 4。 |
| 预期判读 | 若模拟结果显示当地时间 18:30 有空位,模型必须正确报告该时段;若超时则不得声称有位。 |
| 预期状态 | 查询前后的订座数据不得改变,并以后台记录确认。缺少证据的项目标记为“未测”。 |
如果要测试用户忘记提供分店的情况,就另外建立一张题卡,将预期行为设为先询问分店,并要求工具调用次数为零。这样做的好处,是能把不同错误分开观察,而不会把所有失败都归因于“模型没有理解需求”。换句话说,题卡不是多写一份文档,而是把预期行为、容许误差与失败分类先固定下来,避免跑完才回头解释结果。这样同一张题卡才能在不同版本与不同模型之间重复比较。
可复制的 TCC JSON 模板
展开 JSON 题卡、观测示例与比对命令
以下提供一份通用题卡,以查询记录 DEMO-001 为例。
开跑前先填入 expected,固定正确行为,再将模型的实际调用与后端观测结果另外存档。这样才能比较预期与实际结果,避免测试完成后才依照模型的表现调整评分标准。
{
  "tcc_version": "0.1",
  "case_id": "example-read-record",
  "locale": "zh-TW",
  "task": "查询记录 DEMO-001 的状态。",
  "context": {
    "client": "填写客户端与版本",
    "model": "填写模型与配置版本",
    "tool_set_ref": "填写工具定义版本或 SHA-256",
    "fixture_ref": "填写冻结的测试数据、授权、返回与前后状态",
    "mode": "fixture"
  },
  "evidence_gate": [
    {
      "claim": "查询工具只读取记录。",
      "evidence_ref": null,
      "status": "unknown"
    }
  ],
  "checks": [
    {
      "id": "tool-choice",
      "axis": "task_fit",
      "condition": "只查询指定记录",
      "expected": {
        "decision": "read",
        "call_count": 1
      }
    },
    {
      "id": "arguments",
      "axis": "call_result",
      "condition": "固定查询工具",
      "expected": {
        "arguments": {
          "record_id": "DEMO-001"
        }
      }
    },
    {
      "id": "result",
      "axis": "call_result",
      "condition": "查询超时,无法确认状态",
      "expected": {
        "label": "TIMEOUT"
      }
    },
    {
      "id": "state",
      "axis": "call_result",
      "condition": "比对执行前后的写入记录",
      "expected": {
        "write_count": 0
      }
    }
  ]
}
实测产生的观测 JSON,可以使用检查项目 ID 作为键值,例如:
{
  "tool-choice": {
    "decision": "read",
    "call_count": 1
  }
}
在 LS-Labs 研究工作区中,可以使用 Node.js 24 执行以下命令,比对题卡与实际观测结果:
node research/tool-metadata-framework-2026-11-05/tcc/replay-tcc.mjs --compare my-card.json observations.json
比对程序会将没有取得观测数据的项目标为“未测”,而不是直接算作通过。工具实际执行与否、后台是否产生状态变更,也需要各自提供证据。
将 TCC 纳入工具上线检查
除了个别题卡,LS-Labs 建议开发者在工具上线或改版前,至少检查四个面向。以下四项检查的顺序,是先降低误触风险,再处理缺数据、异常状态与版本比较。如果只测正常成功案例,很容易高估工具定义的完整度,也看不出模型在边界场景下会怎么出错;因此,这四项应该一起跑,而不是挑其中一项当作上线前的最后检查。换句话说,检查清单不是上线前的形式检查,而是把工具契约从文档带进可重跑的测试流程。
将容易混淆的工具一起测试。让只读查询与修改写入工具同时出现在候选列表中,涵盖正常操作、缺少必要数据及超出能力的请求,确认模型能否识别差异。
验证后端是否能拒绝不合法操作。在测试环境确认服务器能挡下缺少字段、参数格式错误及未授权的写入。即使模型提供的参数格式合法,也要核对它是否符合用户原本的要求。
分开测试成功、无数据与执行失败。例如餐厅查询应分别模拟有空位、没有空位与连接超时,观察模型能否正确区分。涉及写入的任务,还要核对执行前后的后台状态。
保持改版前后的测试条件一致。固定题目、模型配置、工具候选顺序与测试数据,保存原始请求、模型响应及后台记录。选用、参数、判读与任务完成应分开计分,避免单一成功率掩盖不同类型的问题。
如果任务涉及订座、付款或修改数据,验收条件还需要更加严格。至少必须确认用户已授权相关操作、后端状态符合预期,以及 AI 对用户的报告与实际状态一致。任何一项缺少证据,都不应直接判定为完成。这也是为什么 TCC 要把“未测”保留为独立状态,而不是把没有证据的项目算成通过。只要缺少后端状态或授权记录,就不能用模型的流畅回复替代验收。
让 AI 找到工具,只是任务的开始
回到最初那张发票。用户要作废发票,AI 却提议提交付款,背后反映的是工具能力边界不够明确。模型不知道目前有哪些操作被允许,也无法确认哪个工具真正符合用户的目的。当工具定义清楚区分只读与写入,并交代缺少数据时应如何处理,模型就能减少不必要的推测。当返回状态也具有明确语义,AI 才能更可靠地向用户说明事情究竟办到了哪一步。在这次测试中,工具选用的通过数从 28/48 提升至 46/48,结果判读则从 12/28 提升至 28/28。它们并不能保证正式环境中的任务一定成功,但至少证明,许多表面上像是模型判断失误的问题,能通过改善工具定义得到缓解。
随着 AI 开始通过工具处理更多实际任务,开发者需要关注的,也不再只是如何让模型找到自己的服务。TSO 用来研究 AI 如何选择工具;TCC 则进一步确认,模型选中的工具是否被正确使用,以及任务结果能否被验证。工具被选中是一个起点。真正值得验收的,是用户交付的事情有没有被正确处理。若流程还包含网页操作、委托授权与交易确认,可接着看从可供性理解 AX 的订座实验,检查工具调用之外的完成条件。
主题阅读:TSO 阅读指南 · 首页 AI 搜索地球
研究资料与来源
- LS-Labs(2026-11-05)。餐厅与发票的双语缺陷挑战。审稿用记录含样本、分组结果与限制。研究 ID 为
tool-metadata-transfer-2026-11-05。 - Anthropic。Claude 工具搜索文档。用于说明延后加载的工具在何时提供给模型。
- LS-Labs(2026-11-05)。任务调用契约 v0.1。词条、模板与四张题卡的审稿用记录。
- LS-Labs(2026-11-05)。工具描述等长对照。研究 ID 为
tool-description-length-control-2026-11-05。 - Hasan 等人(2026)。Model Context Protocol (MCP) Tool Descriptions Are Smelly!。arXiv 预印本,表 7 列出任务成功率差异。
- Model Context Protocol(2025-11-25)。Tools 规范。参照输出 Schema、工具错误及服务器验证。