文章目錄文章開頭0%
一、兩段沒有相同關鍵字的文字,為什麼可能指向同一件事?
假設有人問 ChatGPT:「我要怎麼提高網站內容被 AI 回答採用的機會?」
網路上有兩段文字。第一段寫著:「生成式引擎最佳化(GEO)著重於改善內容在生成答案中的可見度。」第二段則說:「想讓聊天機器人在回答問題時引用你的文章,除了讓資訊容易被檢索,也要提供足以支撐答案的證據。」
兩段文字幾乎沒有重複的核心字詞,討論的卻是同一個問題。反過來看,另一篇文章就算密集出現「GEO」「ChatGPT」「AI 搜尋」等字眼,內文也可能只是在綜述產業規模,完全沒有回答網站經營者該從何下手。
這正是理解語義檢索(Semantic Retrieval)的起點:一段內容能不能被找出來,除了看它與查詢共享多少字面詞彙,也看檢索系統能否判斷兩者在語義上是否相關。但這並不代表傳統關鍵字檢索已經退場,更不能據此推論所有 AI 搜尋都只靠向量運作。
把問題再往後推一步,真正的落差才會浮現。即使一篇文章順利通過檢索、進入候選名單,它也未必會被放進 AI 的最終回答;就算模型真的採用了文章裡的資訊,回答下方也未必會附上正確的來源連結。本文想拆開的,正是從「語義相近」走到「被引用」之間那段經常被簡化的距離。
二、Embedding 如何把文字轉成向量?
把文字放進一個可計算方向的座標系
在數學上,向量可以理解成一組有順序的數字。文字嵌入模型(Embedding Model)會把句子、段落或整份文件映射成高維度向量,讓模型在特定訓練目標下學到的語義關聯,轉化為座標空間裡的幾何關係。
為了直觀理解,可以先將數百至數千維的向量壓縮成一張二維平面圖:每一段文字都是一支從原點射出的箭頭;當某段內容的箭頭方向與使用者問題越接近,代表在該模型的表徵空間裡,兩者對應的語義關係越緊密。
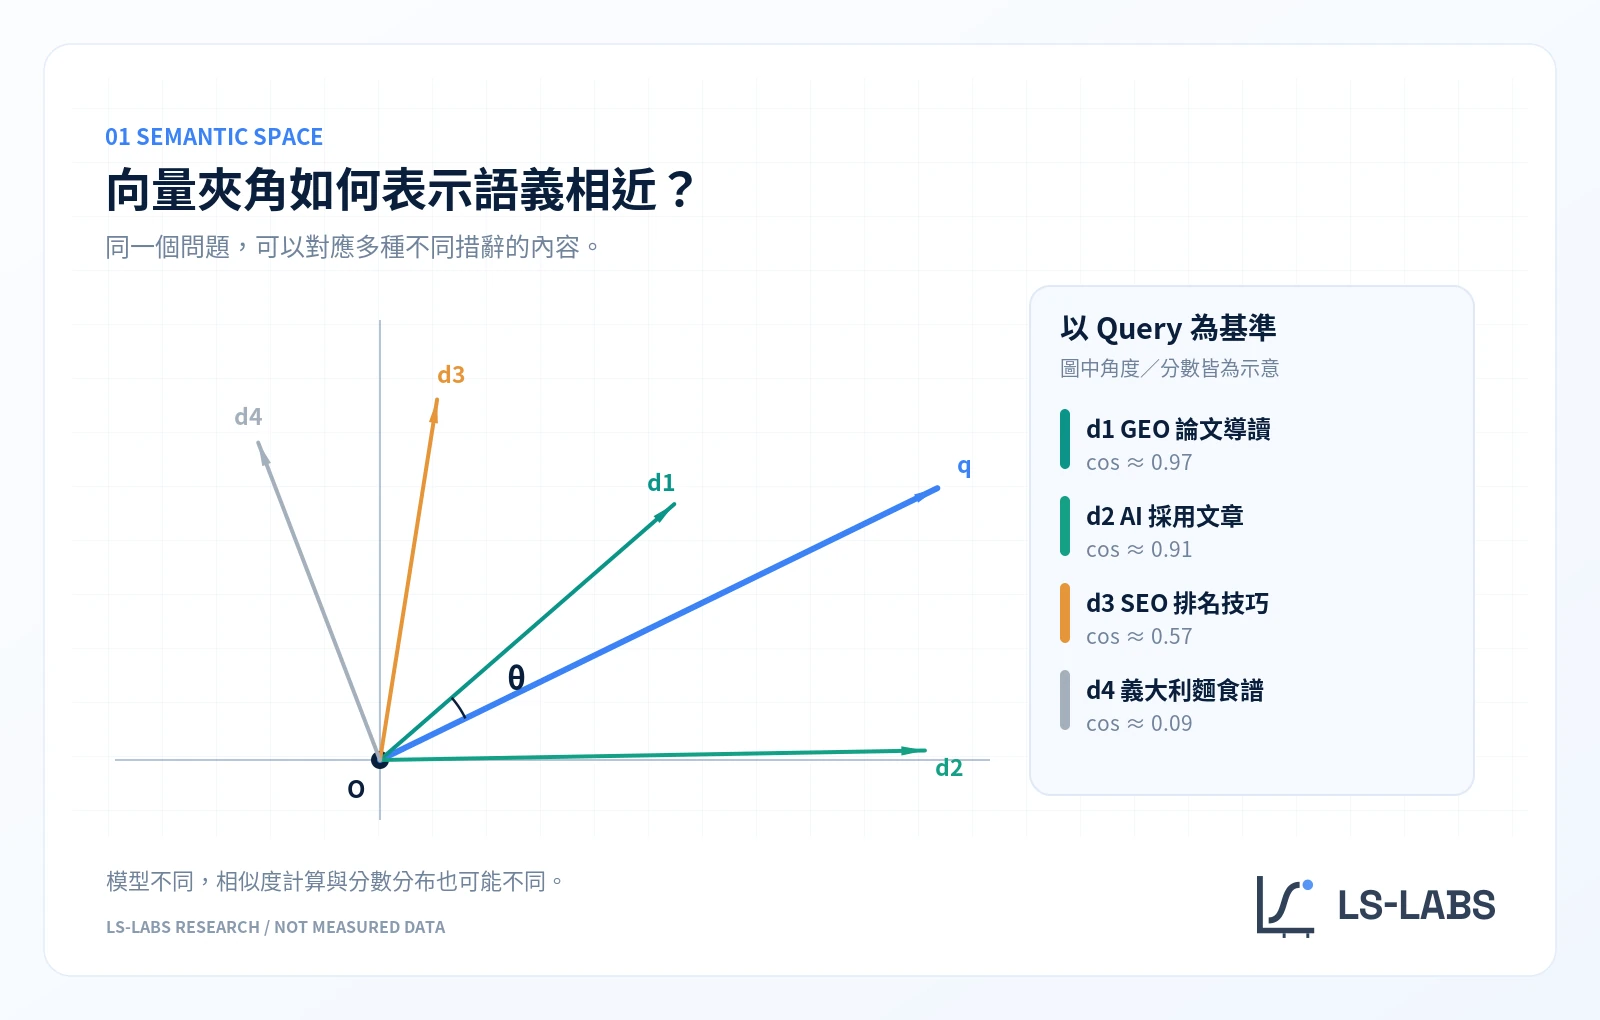
衡量兩支向量方向有多接近,最常見的指標是餘弦相似度(Cosine Similarity):
餘弦相似度公式:cos(θ) = (q · d) / (‖q‖ × ‖d‖)
其中 q 為查詢向量,d 為內容向量,分子 q · d 為兩向量的內積,分母 ‖q‖ × ‖d‖ 為兩向量長度的乘積。夾角 θ 越小,cos(θ) 越接近 1;夾角 90° 時等於 0;方向完全相反(180°)時等於 -1。
閱讀這個公式時要格外小心:它是幾何定義,不能直接翻譯成「1 分代表同義、0 分代表無關、-1 分代表反義」。舉例來說,「這家餐廳很好吃」與「這家餐廳很難吃」評價截然相反,卻同樣圍繞餐廳與餐點體驗,在許多語義嵌入模型裡依然會落在相當接近的位置。語義接近不等於立場一致,更不等於事實正確。
為什麼把文字變成數字,不會自動產生「語義」?
讓向量之間的距離真正反映句子層級的語義相似,本身就是自然語言處理的重要研究課題。2019 年發表於 EMNLP 的 Sentence-BERT(SBERT)論文發現,若直接把未經句向量微調的原生 BERT 輸出拿來取平均或取 [CLS] 向量,在語義相似度基準測試上的表現甚至不如傳統的 GloVe 詞向量。研究團隊因此採用孿生與三元組網路架構重新訓練句向量,讓兩段文字能各自獨立編碼,再以餘弦相似度快速比對(Reimers & Gurevych, 2019)。
該論文提供了一組經典的運算成本對照:在單張 NVIDIA V100 GPU 上,若要從 10,000 個句子中找出最相似的一對,傳統逐對送入 BERT cross-encoder 的做法需要執行 49,995,000 次推論,耗時約 65 小時;改用 Sentence-BERT 預先算出句向量並比對餘弦相似度,總時間縮短到約 5 秒。正是因為文件向量能夠離線預先計算並建立索引,語義比對才得以從昂貴的兩兩推論,走入可規模化的線上檢索。
另一個實務上常被忽略的限制是:向量分數無法跨模型直接比較。不同 Embedding 模型的訓練資料、損失函數與維度分布各異;Ethayarajh(2019)針對 BERT、ELMo 與 GPT-2 的分析更指出,這類上下文表徵往往擠在高維空間的狹窄圓錐區內,呈現高度各向異性(Anisotropy),導致隨機兩個無關詞彙的餘弦相似度也可能遠高於 0。因此,市面上偶爾流傳「只要段落與問題的 cosine 大於 0.8 就容易被 AI 引用」的說法,在科學上並不存在跨平台通用的門檻。
三、語義相近,如何變成一筆搜尋結果?
Dense Retrieval 與關鍵字檢索的互補邊界
在資訊檢索(Information Retrieval)領域,稠密檢索(Dense Retrieval)會將使用者查詢與龐大的文件段落庫映射到同一個向量空間,再透過近似最近鄰搜尋(ANN)快速召回最接近的前 K 個候選段落(Top-K)。
2020 年發表於 EMNLP 的 Dense Passage Retrieval(DPR)是這條路線的代表作(Karpukhin et al., 2020)。DPR 使用雙編碼器分別處理問題與約 2,100 萬個 100 字維基百科段落,並以向量內積(dot product)作為預設相關性函數。只有在所有向量都先正規化為單位長度的前提下,內積才會等同於餘弦相似度;換言之,夾角圖解有助於建立直覺,卻不能當成所有檢索系統唯一的底層公式。
更值得行銷與內容研究者留意的是 DPR 與傳統關鍵字檢索 BM25 的正反對照:在真實搜尋提問構成的 Natural Questions 資料集中,前 20 個召回段落包含答案的比例(Top-20 召回率),DPR 達到 78.4%,明顯高於 BM25 的 59.1%;然而在提問者高度沿用原文詞彙的 SQuAD 資料集上,BM25(68.8%)反而優於未針對該集微調的 DPR(63.2%),結合兩者的混合檢索則進一步拉高整體表現(Karpukhin et al., 2020)。
這組數據直接打破了「有了向量檢索就不再需要關鍵字」的迷思。稠密檢索擅長跨越同義改寫與口語提問,稀疏關鍵字檢索則在專有名詞、品牌名稱、產品型號與法規條號上保有精準優勢。現代搜尋系統普遍結合兩者,談 GEO 並不需要把 SEO 累積至今的字詞與實體基礎推翻。
AI 搜尋面對的往往是一組展開後的子問題
傳統搜尋多半直接拿使用者輸入的字串去比對索引;生成式搜尋則常在檢索前多做一步查詢改寫與拆解。Google Search Central 在說明 AI 摘要(AI Overviews)與 AI 模式(AI Mode)時明確提到查詢擴展(Query fan-out)機制:系統會將複雜提問拆解並同時發出多個相關子查詢,橫跨不同子主題與資料來源取回更廣泛的網頁連結(Google Search Central, n.d.)。OpenAI 對 ChatGPT Search 的技術說明同樣指出,模型會依對話脈絡將使用者問題改寫為一或多個針對性搜尋查詢。
舉例來說,當使用者問「如何衡量 GEO 成效?」,背後展開的檢索方向可能涵蓋「AI 搜尋引用率怎麼計算」、「品牌提及與來源連結有何差別」、「不同模型回答波動如何重複抽樣」。這三個子問題為教學舉例,但足以說明一件事:一篇只反覆堆砌「GEO 成效」四個字、卻未分別解答指標定義與抽樣限制的文章,很難在多路子查詢中同時提供有效支撐。
Chunking 的迷思:不必為了 AI 把文章切得支離破碎
由於向量資料庫實作時常把長文切成固定或語義段落(Chunk)建立索引,坊間一度衍生出「為了做 GEO,每段文字都必須寫成短短幾句的獨立碎片」的教條。這其實把特定開發框架的工程預設,誤當成了所有商用搜尋引擎的寫作規定。
Google 在 2026 年發布的官方文件〈針對 Google 搜尋的生成式 AI 功能進行網站最佳化〉中直接澄清:網站經營者不需要為了迎合生成式 AI 而刻意將內容切成細碎片段(chunking),搜尋系統本來就能理解同一頁面裡涵蓋的多個相關子題(Google Search Central, 2026)。真正兼顧人類閱讀與機器檢索的做法,是讓每個章節具備清楚的小標題、明確的先行結論與完整的上下文脈絡。
四、從提問到引用,中間經過哪五道關卡?
理解了向量與混合檢索,只走到一半。2020 年發表於 NeurIPS 的 Retrieval-Augmented Generation(RAG)論文奠定了「先由檢索器取回外部文件,再交由生成模型綜合產出回答」的經典範式(Lewis et al., 2020)。到了今日的商用 AI 搜尋,系統往往還會疊加多輪查詢、品質訊號篩選與事後引用對齊。下圖整理出五道核心概念關卡,協助定位內容究竟在哪一步流失(各平台的實際工程架構可能合併、反覆迭代或省略部分環節):
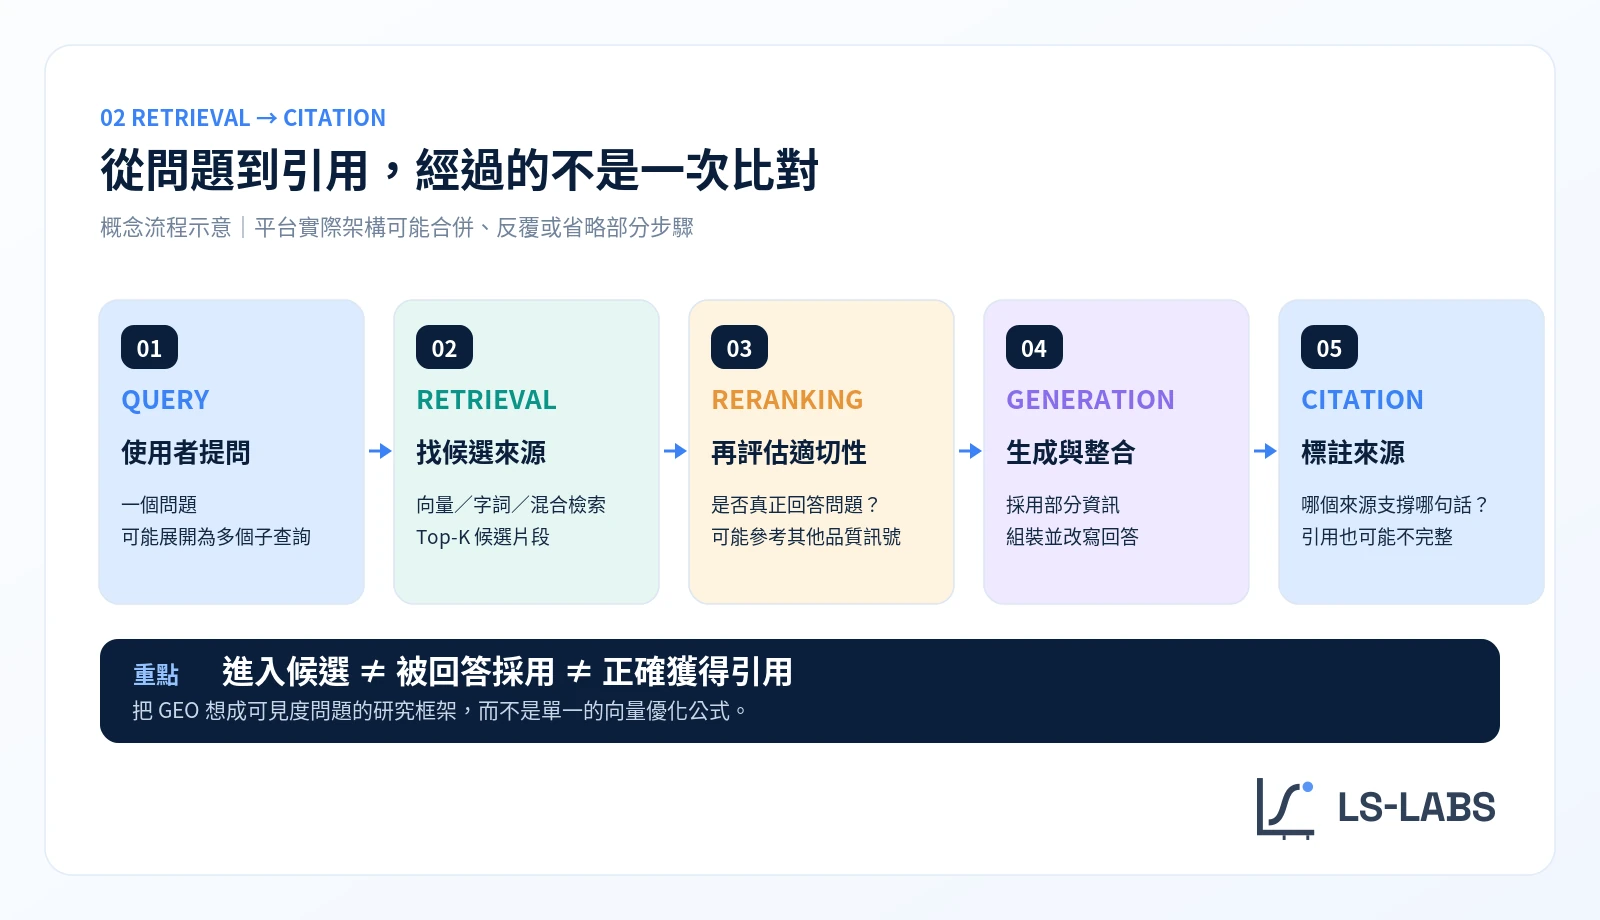
- 查詢展開(Query):系統解析對話意圖,將口語問題改寫或拆解為一至多個搜尋子查詢。若提問本身不需外部即時資料,模型甚至可能不觸發網頁檢索,直接依參數記憶作答。
- 候選檢索(Retrieval):檢索器透過字詞匹配、向量相似度或混合索引,從可存取的網頁庫召回一批 Top-K 候選片段。頁面若遭到封鎖、未被編入索引,或內容與所有子查詢都缺乏關聯,就會在這一關出局。
- 重排序(Re-ranking):第一輪召回追求速度,難免混入「主題擦邊但未正面解答」的段落。資訊檢索系統常在召回後引入精細但運算成本較高的交叉編碼器(Cross-encoder),或採用如 ColBERT 這類保留詞元層級延遲互動(Late Interaction)的模型重新評分(Khattab & Zaharia, 2020),同時也可能納入網站權威度與時效性等訊號。例如面對「GEO 怎麼測量」,一篇詳列指標定義與抽樣設計的文章,通常比泛談「GEO 趨勢有多重要」的概論更有機會在重排序階段勝出。
- 生成與整合(Generation):進入模型上下文視窗的數十個段落,並不會被平均採用。大型語言模型會挑選能直接支撐論點的事實、數據與定義,將多份來源壓縮、改寫並組裝成一段通順的回答。
- 標註來源(Citation):系統在回答句尾或來源欄附上連結。值得注意的是,畫面顯示的引用清單未必與模型生成時實際依賴的段落一一對應;有些句子融合了多處資訊卻只掛上單一連結,有些連結甚至是在回答生成後才配對補上。
把這五道關卡攤開,整篇文章最核心的診斷原則便一目了然:進入檢索候選、被答案實質採用、以及獲得正確的引用標註,是三件必須分開觀察的結果。
五、KDD 2024 的 GEO 論文真正證明了什麼?
既然進入候選池不保證被採用,修改網頁本身的寫法,究竟能不能改變它在生成答案裡的可見度?
普林斯頓大學、印度理工學院德里分校與 Allen AI 等機構學者於 KDD 2024 發表的開創性論文〈GEO: Generative Engine Optimization〉,首次為這個問題建立了系統化的實驗基準(Aggarwal et al., 2024)。研究團隊建構包含 10,000 筆多元查詢的 GEO-bench,先對每道問題固定取回 Google 搜尋前五筆網頁來源,再交由 GPT-3.5-turbo 依據這五份來源生成附帶行內引用的回答;實驗每次僅對其中一份目標來源施加特定的內容改寫策略,藉此比較改寫前後該來源在回答中的能見度變化。
讀懂這項實驗設計的邊界非常關鍵:因為五筆輸入來源已經預先固定,這篇論文測試的是「候選內容在生成與引用階段被採用的程度」,並沒有測試「改寫能否讓網頁在 Google 或檢索器裡排名上升」,更不能直接類推為今日所有商用模型都按固定比例加分。
論文的主觀與客觀評估中,最常被引用的是字數與位置加權指標 Position-Adjusted Word Count(綜合計算引用句占回答字數的比例,並賦予越靠前的句子越高權重)。圖 3 與表 1 整理了論文 arXiv v3 版本表 1 的核心結果:
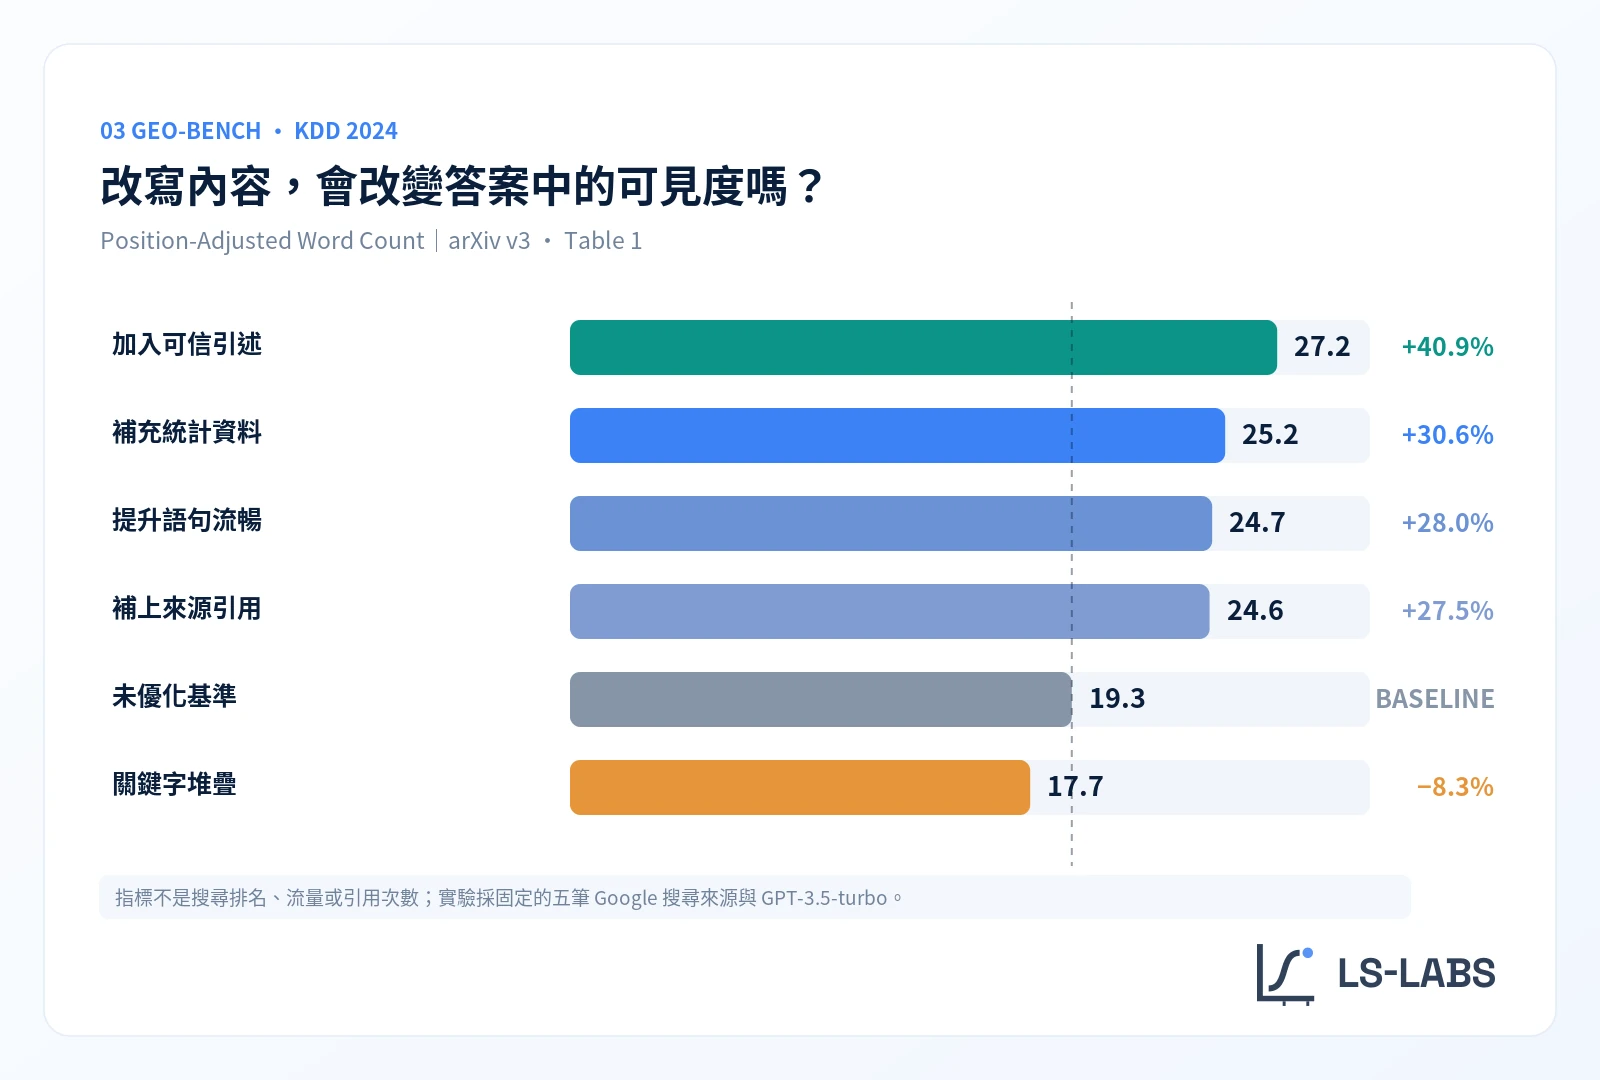
| 內容改寫策略 | 作法摘要 | Position-Adjusted Word Count | 相對基準變化 | Subjective Impression(主觀印象) |
|---|---|---|---|---|
| Quotation Addition(加入可信引述) | 補充與主題直接相關且具名來源的引述 | 27.2 | +40.9% | 26.9 |
| Statistics Addition(補充統計資料) | 將模糊敘述替換或補上具體定量證據 | 25.2 | +30.6% | 24.0 |
| Fluency Optimization(提升語句流暢) | 改善語法結構與段落可讀性 | 24.7 | +28.0% | 24.7 |
| Cite Sources(補上來源引用) | 為文中主張附上可查核的外部出處 | 24.6 | +27.5% | 22.2 |
| Unoptimized(未優化基準) | 維持原始網頁擷取內容不變 | 19.3 | 基準線(0.0%) | 19.3 |
| Keyword Stuffing(關鍵字堆疊) | 比照傳統黑帽作法刻意塞入查詢字詞 | 17.7 | −8.3% | 20.2 |
綜合表 1 與論文後續實驗,可以提煉出四點經得起檢驗的結論與限制:
- 提供具體證據與清晰表達,有助於模型抽取組織答案:在固定候選池中,加入具名引述(27.2)、統計數據(25.2)、流暢化改寫(24.7)與標明出處(24.6)均顯著優於未優化基準(19.3)。相對地,單純把語氣改得更武斷自信(Authoritative)在不同領域表現不一,並未展現同等穩定的提升。
- 關鍵字堆疊無助於字數位置指標,但評估指標本身會影響結論:Keyword Stuffing 在 Position-Adjusted Word Count 降至 17.7(低於基準 8.3%),在論文另一組 200 題 Perplexity.ai 測試中也從 24.1 跌至 21.9;不過在表 1 由 GPT-4 評分的 Subjective Impression 指標上卻微幅升至 20.2。這提醒研究者,單一指標不足以概括所有面向。
- Perplexity 外推實驗仍屬受控環境:研究團隊在 Perplexity.ai 測試時,Quotation Addition 同樣將字數位置指標從 24.1 推升至 29.1(約 +20.7%),Cite Sources 在主觀印象指標提升最高約 37%。但該實驗是以檔案上傳方式指定系統僅從這五份文字作答,與真實使用者在開放網路搜尋、由平台自行決定檢索池的情境仍有距離。
- 低排名來源在生成階段有機會翻盤,惟前提是先擠進候選池:在多來源同時改寫的對抗設定下,原本位居 Google 第 5 名的網頁採用 Cite Sources 後,字數位置指標相對暴增 115.1%,而第 1 名來源反而下滑 30.3%。這說明只要能進入前段候選清單,生成模型更看重段落本身的證據密度;同時也要破除坊間常見的誤傳:誠如本站〈當 AI 開始引用 AI 生成的文章〉所考證,這篇 GEO 論文從頭到尾都沒有測試「新增 FAQ 區塊」,而 Ahrefs 在 2026 年追蹤 1,885 個新增 JSON-LD 結構化資料頁面的研究,同樣未觀察到顯著的 AI 引用成長。
六、從「有關」到「可用」:拆開四層內容工作
將語義檢索機制與 GEO-bench 實驗放在一起看,可以把網站面對生成式搜尋的工作拆解為四個層次,每一層對應的技術機制與證據強度各有不同:
GEO 內容檢視的四個層次
網頁必須允許搜尋爬蟲存取、能被正常渲染與編入索引。若連第一關檢索池都進不去,後續任何語義或證據改寫都不會生效。
標題、小節與內文需明確交代討論對象與適用情境。向量檢索能容納同義改寫,但精確的專有名詞、品牌名與規格描述仍是混合檢索的重要錨點。
與其泛談「企業應重視 GEO」,不如交代觀察週期、測試題組設計、提及率與引用率定義及樣本限制,讓段落本身就具備支撐答案的資訊密度。
保留可回溯的原始論文、官方文件連結與核對日期,讓模型與人類讀者都能分辨哪一句是實證數據、哪一句是合理推論。
在第一層「可被發現」上,網站經營者特別需要區分不同用途的 AI 爬蟲。以 OpenAI 官方文件為例,負責為 ChatGPT 搜尋建立索引與引用的爬蟲是 OAI-SearchBot,而收集模型訓練語料的則是 GPTBot;網站可在 robots.txt 獨立允許搜尋檢索並封鎖模型訓練,但若封鎖了 OAI-SearchBot,網頁內容就不會作為搜尋答案的引用來源出現(OpenAI, n.d.)。各家爬蟲的完整權衡可參考本站〈robots.txt 該不該擋 AI?〉。
同時,也必須正面回應針對 GEO 概念最強烈的反方觀點。Google 在 2026 年的官方指南直言,從 Google 搜尋的運作架構來看,無論外界稱之為 AEO 或 GEO,核心依然建立在既有的 SEO 基礎與原創內容品質之上;網站不需要追逐長尾問題的每一種問法變體,也不需要為 Google 搜尋額外建立 llms.txt(Google Search Central, 2026)。
這份官方立場與「把 GEO 當成取代 SEO 的獨門捷徑」形成鮮明對比。綜合現有證據,最務實的定位是將 GEO 視為觀察並改善內容在生成式回答中可見度與歸因品質的研究框架:檢索入口、重排序權重與最終引用呈現仍由各平台掌控,內容創作者能掌握的則是把可發現性、解題密度與可查證性做好,再透過固定題組反覆觀測實際變化。
七、即使 AI 附上來源,引用就一定支持那句話嗎?
走完前面四層,最後還有一個常被行銷報表忽略的盲點:當 AI 回答真的附上你的網址,或者引用了某篇外部報導來介紹你的品牌,那個引用標記真的能支持回答裡的那句話嗎?
史丹佛大學團隊於 EMNLP Findings 2023 發表的〈Evaluating Verifiability in Generative Search Engines〉,曾透過人工逐句核對當時四款生成式搜尋引擎(Bing Chat、NeevaAI、Perplexity.ai 與 YouChat)的回答與所附來源(Liu et al., 2023)。研究結果相當警醒:平均只有 51.5% 的生成句子獲得所附引用的完整支持(引用召回率),而在系統標出的所有引用連結裡,平均也只有 74.5% 確實支持它所掛載的那項敘述(引用精確率)。
這組數字反映的是 2023 年受測系統的歷史基準,不能直接套用為 2026 年最新模型的準確率;但它揭示的結構性問題至今依然存在:引用率(Citation Rate)與引用忠實度(Citation Faithfulness)是兩把不同的尺。模型可能在整合多篇網頁時發生張冠李戴,也可能把來源裡帶有前提條件的局部數據,改寫成毫無保留的普遍斷言。
這也是為什麼在評估品牌能見度時,單看「品牌被提到幾次」很容易失真:模型主動推薦、列為負面警示案例、附上官網連結卻寫錯價格,表面上都算一次曝光,對品牌的實質影響卻天差地遠。在本站 GEO 主題頁與〈AI 搜尋時代的檢索機制報告〉中,LS-Labs 提出以 MCAC 四項診斷(品牌提及 Mention、來源引用 Citation、資訊正確性 Accuracy、行動承接度 Conversion-readiness)分項記錄、不混加成單一總分,正是為了把「有沒有提到」、「連到哪一頁」、「事實說得對不對」以及「回答有沒有給出下一步」拆開檢驗。
八、結語:從被找到,走向有憑據地被採用
回到文章開頭的問題:為什麼兩篇語義同樣貼近問題的文章,最後只有一篇出現在 AI 的回答裡?
向量與稠密檢索解釋了前半段。Embedding 讓搜尋系統得以跨越字面措辭的差異,在數千萬個段落裡快速召回意思相近的候選內容;但餘弦相似度不會替文章查核事實、不會衡量證據強弱,更無法保證生成模型在改寫答案時把功勞歸給正確的來源。
如果說傳統搜尋讓內容經營者關心「使用者在結果頁上看不看得見這個連結」,生成式搜尋則多出了一道必須追問的課題:「系統從這個頁面取走了哪些資訊、說得對不對,又把引用歸給了誰?」而當使用者的需求從「查資訊」再往前跨到「請 AI 代理人直接訂位、比價或呼叫服務」,競爭場域還會進一步延伸到 TSO(工具選擇優化)與 AX(代理人體驗)。
對網站經營者而言,理解語義檢索絕非放棄 SEO 基本功的理由;對研究者而言,也不該把單一向量公式當成跨平台通吃的萬靈丹。當提問經過改寫展開、候選段落歷經混合檢索與重排序,最後由語言模型重組為答案,唯有同時具備可檢索結構、具體解題密度與一手可查證出處的內容,才更有理由在生成式回答中留下清楚且忠實的引用痕跡。
參考文獻與官方資料
學術論文
- Reimers, N., & Gurevych, I. (2019). Sentence-BERT: Sentence embeddings using Siamese BERT-networks. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP) (pp. 3982–3992). Association for Computational Linguistics. https://aclanthology.org/D19-1410/
- Ethayarajh, K. (2019). How contextual are contextualized word representations? Comparing the geometry of BERT, ELMo, and GPT-2 embeddings. In Proceedings of the 2019 Conference on Empirical Methods in Natural Language Processing and the 9th International Joint Conference on Natural Language Processing (EMNLP-IJCNLP) (pp. 55–65). Association for Computational Linguistics. https://aclanthology.org/D19-1006/
- Karpukhin, V., Oguz, B., Min, S., Lewis, P., Wu, L., Edunov, S., Chen, D., & Yih, W.-t. (2020). Dense passage retrieval for open-domain question answering. In Proceedings of the 2020 Conference on Empirical Methods in Natural Language Processing (EMNLP) (pp. 6769–6781). Association for Computational Linguistics. https://aclanthology.org/2020.emnlp-main.550/
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W.-t., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-augmented generation for knowledge-intensive NLP tasks. In Advances in Neural Information Processing Systems (NeurIPS 2020) (Vol. 33, pp. 9459–9474). https://arxiv.org/abs/2005.11401
- Khattab, O., & Zaharia, M. (2020). ColBERT: Efficient and effective passage search via contextualized late interaction over BERT. In Proceedings of the 43rd International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR '20) (pp. 39–48). ACM. https://doi.org/10.1145/3397271.3401075
- Liu, N. F., Zhang, T., & Liang, P. (2023). Evaluating verifiability in generative search engines. In Findings of the Association for Computational Linguistics: EMNLP 2023 (pp. 7001–7015). Association for Computational Linguistics. https://aclanthology.org/2023.findings-emnlp.467/
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative engine optimization. In Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining (KDD '24) (pp. 5–16). ACM. https://doi.org/10.1145/3637528.3671900(本文表 1 與內文數值核對自 arXiv:2311.09735v3 表 1、表 3、表 5 與附錄)
官方技術文件與產業研究
- Google Search Central. (n.d.). AI 功能與您的網站. Google Developers. https://developers.google.com/search/docs/appearance/ai-features?hl=zh-tw
- Google Search Central. (2026). 針對 Google 搜尋的生成式 AI 功能進行網站最佳化. Google Developers. https://developers.google.com/search/docs/fundamentals/ai-optimization-guide?hl=zh-tw
- OpenAI. (n.d.). Overview of OpenAI crawlers. OpenAI Developer Platform. https://developers.openai.com/api/docs/bots
- Linehan, L., & Guan, X. (2026, May 11). We tracked 1,885 pages adding schema. AI citations barely moved. Ahrefs. https://ahrefs.com/blog/schema-ai-citations/
本文引用文獻與官方文件最後核對日期:2026 年 11 月 4 日。AI 工具用於程式協助與語言編輯。研究設計、驗證、詮釋與最終結論由作者審閱。