文章目錄文章開頭0%
2023 年 12 月,《紐約時報》控告 OpenAI 與微軟,主張自家報導在未經授權下被拿去訓練模型。五個月後,《華爾街日報》的母公司 News Corp 宣布和 OpenAI 簽下多年期內容合作。
9 月 23 日,LS-Labs 抓取 28 家台灣與國際新聞媒體的 robots.txt,取得 26 份可判讀的檔案。最終結果顯示,有的連搜尋用的 bot 都擋,有的只擋訓練,也有的明確放行。
這顯示了當前各網站對於爬蟲不同的應對政策。同一份內容可以用來訓練模型,有的則可以被作為搜尋回答的來源。
- 國際 12 家媒體裡,ClaudeBot 和 PerplexityBot 各有 11 家封鎖。對 OpenAI 的處理則分成兩群。
- 台灣 14 家裡,6 家封鎖 GPTBot 和 ClaudeBot;另外 6 家對表中五個 AI bot 都沒有寫專屬規則。
- 同一家 AI 公司通常有訓練、搜尋、使用者觸發三種爬蟲,網站可以分開設定。
robots.txt 是什麼
robots.txt 顧名思義,便是讓機器人可以讀到的內容。主要放在網站根目錄的一個純文字檔,網址固定是「網域/robots.txt」,例如本網站 lslabs.tw 的 robots.txt 便是 https://lslabs.tw/robots.txt。
這份網站的讀者很簡單,是那些會自動抓取網頁的程式,也就是常說的爬蟲或 bot。而檔案內容是在明確告訴它們:哪些內容可以抓,哪些內容不准抓。
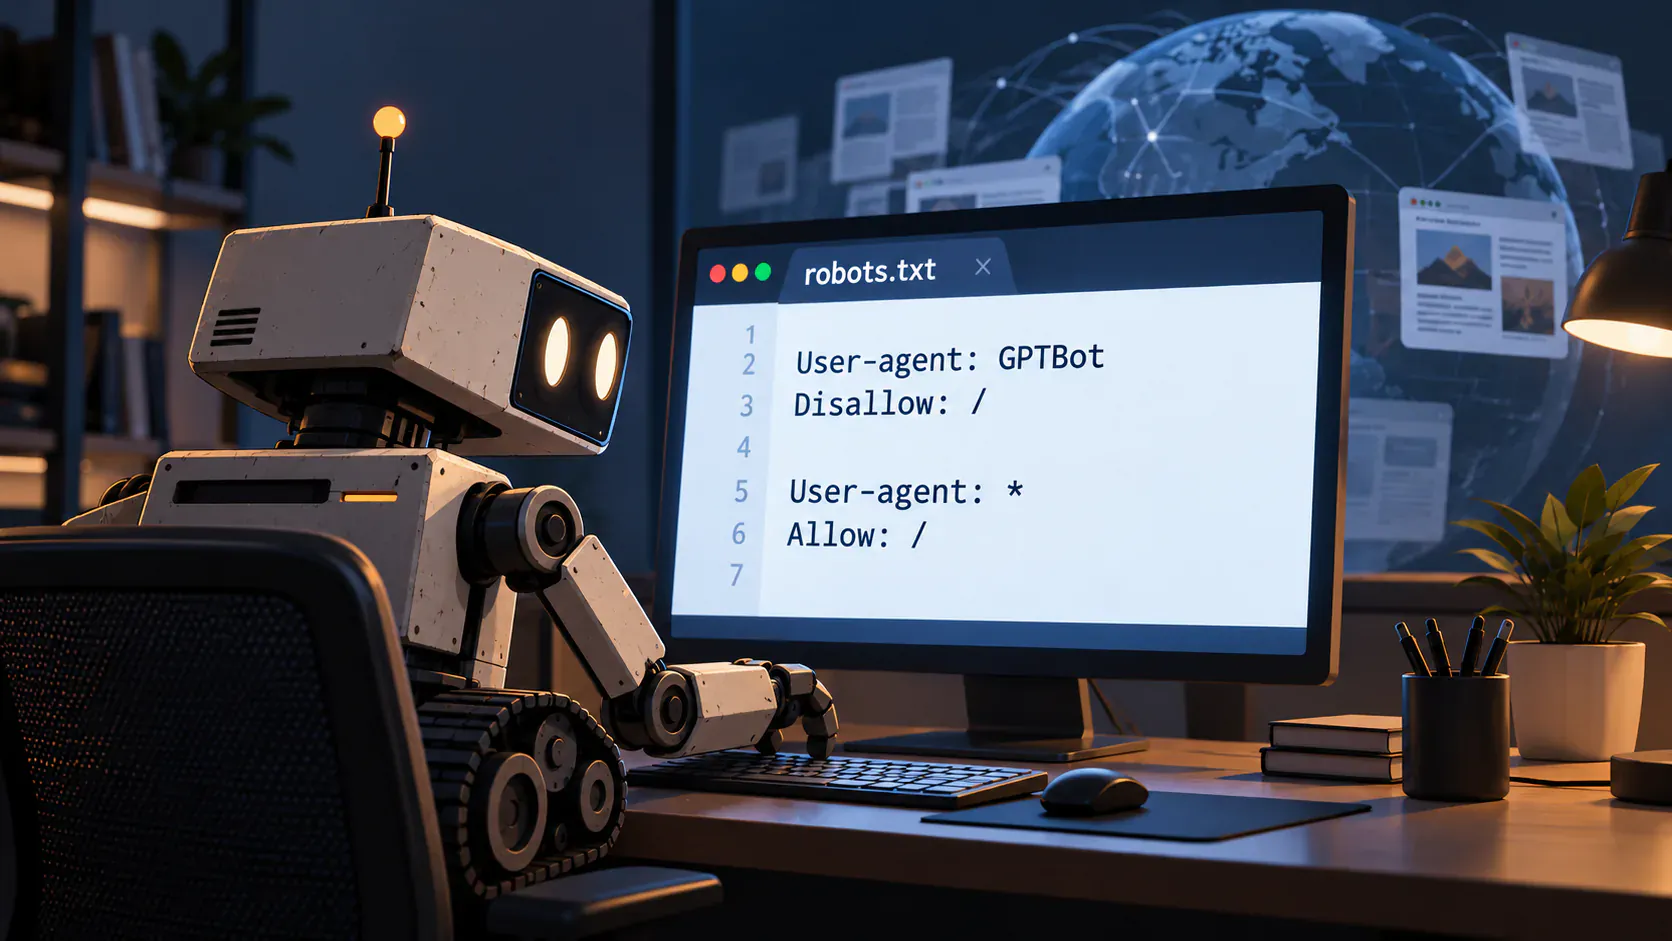
檔案裡寫的,就是一條條「對哪個爬蟲說、准不准抓」的規則。看得懂三個英文字就夠了:User-agent 是「對誰說」,Disallow 是「不准抓」,Allow 是「可以抓」。
舉個例子,左邊是 robots.txt 的原文,右邊翻成白話:
| robots.txt 原文 | 白話意思 |
|---|---|
User-agent: GPTBotDisallow: / | OpenAI 的訓練爬蟲 GPTBot:整個網站都不准抓 |
User-agent: *Disallow: /admin/ | 其他所有爬蟲(* 代表所有):後台頁面不准抓,其他都可以 |
每個爬蟲會先找有沒有點名自己的規則;沒有,就照「所有爬蟲」那條走。這套做法 1994 年就有人用,2022 年才成為正式的國際標準。
不過要記得,robots.txt 比較像貼在門口的告示,不是門鎖。守規矩的爬蟲會照做,不守規矩的照樣進得來。它也只管爬蟲能不能進來抓,不管搜尋結果怎麼顯示;想讓頁面不出現在 Google 搜尋,要另外設定(技術上叫 noindex)。
AI 公司的爬蟲也照這套規則報上名字。讀下面的表,先記住兩個就夠:GPTBot 抓資料給 OpenAI 訓練模型,OAI-SearchBot 抓網頁給 ChatGPT 搜尋用。兩個都屬於 OpenAI,但網站可以分開設定。
26 份檔案中,顯示各媒體對爬蟲與 AI 的不同看法
身為一家媒體,自然是希望報導被越多人看到,但如果當人們逐漸從打開報導的官網,變成只從 AI 那裡獲得想要的消息,那麼自家網站的流量還能維持嗎?
這應該是現在許多主流媒體遇到的兩難。
一來希望自己被 AI 看到,率先搶占 AI 時代的入口;另一方面又擔心開放 AI 讀取後,自家網站沒人看,自然而然獲取不到廣告的收益。
Pew Research Center 2025 年的研究中,出現 AI 摘要的 Google 搜尋頁,只有 1% 的造訪點了摘要裡的引用連結。這也證實了各家媒體對於 robots.txt 是否開放的擔憂。
當大家都只看 AI 給出的摘要,那麼媒體們在數位端的利潤從何而來?
先認識表格裡的五個爬蟲
下面兩張表會出現五個爬蟲的名字,分屬四家公司:
- GPTBot(OpenAI):幫 ChatGPT 背後的模型蒐集訓練資料。擋它,等於說「我的內容不要拿去訓練」。
- OAI-SearchBot(OpenAI):ChatGPT 搜尋用的爬蟲。擋它,網頁就不會出現在 ChatGPT 搜尋的回答裡。
- ClaudeBot(Anthropic):幫 Claude 蒐集訓練資料,角色和 GPTBot 類似。
- PerplexityBot(Perplexity):AI 搜尋引擎 Perplexity 的爬蟲,讓網站出現在它的回答裡並附上連結。官方表示不拿來訓練模型。
- Google-Extended(Google):決定內容能不能拿去訓練 Gemini。它不影響 Google 搜尋,也管不到 Google 的 AI 摘要。
表格裡的「封鎖」是網站明確拒絕這個爬蟲;「放行」是明確歡迎,「放行(限路徑)」則是大致歡迎、只擋部分頁面;「未點名」是網站沒特別提到它,實際上等於沒擋。
以下為實際爬取國際各大媒體官網得出的數據
表格可左右滑動
| 媒體 | GPTBot | OAI-SearchBot | ClaudeBot | PerplexityBot | Google-Extended | OpenAI 合作 |
|---|---|---|---|---|---|---|
| The New York Times | 封鎖 | 封鎖 | 封鎖 | 封鎖 | 封鎖 | (訴訟中) |
| The Guardian | 未點名 | 未點名 | 封鎖 | 封鎖 | 未點名 | — |
| BBC | 封鎖 | 封鎖 | 封鎖 | 封鎖 | 封鎖 | — |
| Reuters | 封鎖* | 放行(限路徑) | 封鎖* | 封鎖* | 封鎖* | — |
| CNN | 封鎖 | 封鎖 | 封鎖 | 封鎖 | 封鎖 | — |
| The Washington Post | 未點名 | 未點名 | 封鎖 | 封鎖 | 未點名 | — |
| The Wall Street Journal | 放行(限路徑) | 放行(限路徑) | 封鎖* | 封鎖* | 封鎖* | 是** |
| Financial Times | 未點名 | 未點名 | 封鎖 | 封鎖 | 封鎖 | 是 |
| AP News | 封鎖 | 未點名 | 封鎖 | 封鎖 | 未點名 | — |
| Bloomberg | 封鎖 | 封鎖 | 封鎖 | 封鎖 | 封鎖 | — |
| Axios | 未點名 | 未點名 | 未點名 | 未點名 | 放行(限路徑) | 是 |
| The Verge | 放行 | 未點名 | 封鎖 | 封鎖 | 封鎖 | 是** |
「未點名」指 robots.txt 沒有該 bot 的專屬規則,且通用規則 User-agent: * 未封鎖根目錄。「封鎖*」指網站採白名單寫法:只放行列名的 bot,其餘一律封鎖。「OpenAI 合作」只列本文已從 OpenAI 官方公告核對的四家,**為經由母公司合作(華爾街日報屬 News Corp,The Verge 屬 Vox Media);標「—」代表本文未核對,不代表確定沒有合作。
12 家裡最一致的規則,是封鎖 ClaudeBot 和 PerplexityBot,各有 11 家。
對 OpenAI 則分成兩群。紐約時報、BBC、CNN、Bloomberg 這幾家媒體連搜尋用的 OAI-SearchBot 也擋;華爾街日報、金融時報、The Verge、Axios 這四家已公開和 OpenAI 合作,因此 GPTBot 在根目錄都沒有被擋。
其中,華爾街日報和路透社用的是白名單:只放行列名的 bot,其他一律擋下。華爾街日報的名單裡有 OpenAI 的三個 bot;路透社列了 OAI-SearchBot 和 ChatGPT-User,沒有列 GPTBot。
以下為實際爬取台灣各大媒體官網得出的數據
表格可左右滑動
| 媒體 | GPTBot | OAI-SearchBot | ClaudeBot | PerplexityBot | Google-Extended |
|---|---|---|---|---|---|
| 聯合新聞網 | 封鎖 | 未點名 | 封鎖 | 未點名 | 未點名 |
| 自由時報 | 封鎖 | 未點名 | 封鎖 | 未點名 | 放行 |
| 中時新聞網 | 封鎖 | 封鎖 | 封鎖 | 封鎖 | 放行 |
| 中央社 | 封鎖 | 未點名 | 封鎖 | 封鎖 | 封鎖 |
| 報導者 | 封鎖 | 放行 | 封鎖 | 未點名 | 封鎖 |
| 關鍵評論網 | 封鎖 | 未點名 | 封鎖 | 未點名 | 未點名 |
| ETtoday | 放行 | 放行 | 放行 | 放行 | 未點名 |
| 三立新聞網 | 放行 | 放行 | 放行 | 放行 | 未點名 |
| TVBS 新聞網 | 未點名 | 未點名 | 未點名 | 未點名 | 未點名 |
| 公視新聞網 | 未點名 | 未點名 | 未點名 | 未點名 | 未點名 |
| 風傳媒 | 未點名 | 未點名 | 未點名 | 未點名 | 未點名 |
| 鏡週刊 | 未點名 | 未點名 | 未點名 | 未點名 | 未點名 |
| 鉅亨網 | 未點名 | 未點名 | 未點名 | 未點名 | 未點名 |
| 數位時代 | 未點名 | 未點名 | 未點名 | 未點名 | 未點名 |
天下雜誌(HTTP 403)與商業周刊(HTTP 404)未取得可判讀的 robots.txt,不列入表中。
數據顯示,台灣的 14 家媒體裡有 6 家封鎖了 GPTBot 和 ClaudeBot。
而碰到搜尋用的 OAI-SearchBot,做法又出現了分歧:聯合新聞網、自由時報、中央社、關鍵評論網沒寫;報導者明確放行;只有中時新聞網連它一起擋。
ETtoday 和三立新聞網走另一個方向,對表中四個爬蟲都明確寫了歡迎抓取。其餘 6 家沒有特別提到這五個爬蟲,也就是都沒擋。為什麼沒寫,檔案本身看不出來。
和國際樣本比,台灣這 14 家沒有一家點名 Anthropic 的搜尋用 bot Claude-SearchBot,封鎖 PerplexityBot 的也只有 2 家。規則大多集中在 GPTBot 和 ClaudeBot 這兩個比較早公開的名字。
為什麼可以擋訓練、留搜尋
主要 AI 公司都把爬蟲按用途拆開。擋哪一個,影響的範圍不一樣。
代理人讀取頁面之後,還可能遇到登入、操作授權與結果確認。這些後續步驟屬於 AX 代理人體驗的檢查範圍,不能只靠 robots.txt 判斷是否可行。
- 訓練用:把公開內容收去當 AI 的教材。擋它,是告訴 AI 公司「別拿我的內容去訓練」,實際怎麼做仍看各家政策。
- 搜尋用:讓 AI 搜尋找得到你的網頁。擋它,網頁就比較難出現在 AI 的回答和引用連結裡。
- 使用者觸發:使用者在對話裡貼網址、要 AI 幫忙看,AI 才去打開那一頁。有些業者表示,這種情況不一定照 robots.txt 走。
表格可左右滑動
| 業者 | 訓練用 | 搜尋用 | 使用者觸發 |
|---|---|---|---|
| OpenAI | GPTBot:擋掉,內容就不該被拿去訓練 | OAI-SearchBot:擋掉,就不會出現在 ChatGPT 搜尋的回答裡 | ChatGPT-User:官方說 robots.txt「可能不適用」 |
| Anthropic | ClaudeBot:擋掉之後,新內容應排除在訓練資料外 | Claude-SearchBot:擋掉,可能較少出現在 Claude 的搜尋結果裡 | Claude-User:擋掉,使用者問 Claude 時它讀不到你的網站 |
| Perplexity | 官方表示 PerplexityBot 不拿來訓練模型 | PerplexityBot:讓網站出現在 Perplexity 的回答裡並附連結 | Perplexity-User:官方說「一般會忽略 robots.txt」 |
| Google-Extended:決定內容能不能拿去訓練 Gemini | 一般的 Googlebot:AI 摘要和 AI 模式算 Google 搜尋的一部分,跟著一般搜尋的設定走 | (本表不列) |
Google 這一列最容易看錯。Google-Extended 管的是內容能不能拿去訓練 Gemini,不影響網頁能不能被 Google 搜尋收錄。
而 AI 摘要和 AI 模式屬於 Google 搜尋本身。媒體如果不想讓報導出現在 AI 摘要裡,就要用 nosnippet 這類片段控制。
除了最簡單的允許與拒絕外,Robots.txt 也有一些特別的規範
是否允許這些 AI 讀取,只是第一步,至於是否允許被抓取來做其他用途,仍各有不同。
表格可左右滑動
| 做法 | 怎麼設定 | 能得到什麼 | 還不知道的 | 本次樣本中的例子 |
|---|---|---|---|---|
| 全部開放 | 什麼都不寫,或逐一寫明歡迎 | 訓練、搜尋都能抓 | 實際有沒有帶來引用和流量 | ETtoday、三立新聞網;未點名的 6 家 |
| 擋訓練、留搜尋 | 擋 GPTBot、ClaudeBot,放行 OAI-SearchBot 等搜尋爬蟲 | 還能出現在 AI 搜尋的回答與引用裡 | 搜尋爬蟲拿走的內容怎麼用,仍看業者政策 | 報導者、聯合新聞網、自由時報、AP News |
| 全部封鎖 | 表中五個爬蟲全擋 | 清楚表態:不准抓 | 實際擋不擋得住、內容會不會從其他管道流出 | 紐約時報、BBC、CNN、Bloomberg |
| 選擇性放行 | 只列出歡迎的爬蟲,其他全擋(白名單) | 指定的爬蟲能抓 | 背後有沒有授權合作、條件是什麼 | 華爾街日報、路透社 |
| 按次收費 | 在 Cloudflare 這類網路服務上設定封鎖或收費 | 向抓取的 AI 公司收費 | 誰會付錢、實際收入多少 | 本次樣本無法從 robots.txt 判斷 |
表格中最後一種較為特殊,其來自基礎設施業者,赫赫有名的 Cloudflare。
Cloudflare 在 2025 年 7 月宣布,新加入的網域會預設詢問是否允許 AI 爬蟲,同時推出讓網站向 AI 爬蟲按次收費的 Pay Per Crawl 測試方案。這類設定只在網路層執行,robots.txt 上看不到。
因此,現在同一家媒體也可以按內容分開處理。即時新聞可能更在意觸及,深度調查和付費內容可能優先談授權。天氣、交通、開票這類資訊被摘要之後,讀者還有沒有理由進站,也值得另外觀察。
媒體以外:電商、社群、品牌官網、在地商家
電商平台:交易入口要不要讓出去
同一天抓到的 Amazon robots.txt,點名了 99 個爬蟲,全部整站拒絕,訓練、搜尋、使用者觸發三類 AI 爬蟲都在裡面。Amazon 同時是商品資料庫、比價頁和結帳入口。外部 AI 讀走商品頁,比較和推薦這一段就移到別人的介面上。LS-Labs 先前整理過 Amazon 封鎖 Meta Muse 代客購物的新聞,方向相同。
Walmart 同一天的 robots.txt 只限制帳號、API、站內搜尋、訂單等功能路徑,沒有 AI bot 的專屬規則。
Shopify 提醒商家的是另一件事:在 robots.txt 擋 AI 爬蟲,只影響商品在開放網路上被找到的機會。商家如果開了 ChatGPT、Microsoft Copilot 這類代理式商店,商品資料仍會經由 Shopify Catalog 同步過去。擋爬蟲和退出 AI 購物,是兩個不同的開關。
社群平台:robots.txt 全擋,資料另走授權
Reddit 的 robots.txt 只寫了一條規則:所有爬蟲,整站都不准抓,並附上它的公開內容政策。但 Reddit 的內容沒有因此從 AI 消失。2024 年 5 月,OpenAI 宣布透過 Reddit 官方的資料介面(Data API)取得即時內容。大門關上了,資料改走授權合作。
台灣的 Dcard 則只擋了一個會員帳號相關的頁面,沒有針對 AI 爬蟲的規則。想知道一個平台怎麼把資料提供給 AI,除了 robots.txt,還要看它和 AI 公司有沒有授權合作。
企業使用社群平台時,也要留意商業條款是否另行要求站外內容授權。Meta 的更新引發了這類爭議:Meta 新商業條款:站外網站抓取與 AI 訓練授權爭議。
品牌官網、B2B、SaaS:多半希望被讀
品牌官網不靠頁面瀏覽賺錢。產品說明、價格、規格、說明文件被 AI 正確引用,對它們通常是好事。這類網站比較該擔心 AI 讀錯:舊價格頁還抓得到、規格只寫在圖片裡、說明文件好幾個版本混在一起。先確認 AI 讀到的內容正確一致,要不要擋可以排在後面。
會員區、後台和測試環境是例外,一定要用登入控管,不能只靠 robots.txt。
在地商家:決定權多半不在自己的網站
餐廳、診所、健身房這類在地商家,AI 回答常引用的是地圖、評論平台和食記。LS-Labs 的〈AI 搜尋時代的檢索機制報告〉整理過沒有官網的商家仍被 AI 回答提到的情形。對這類商家,官網 robots.txt 的影響有限;平台上的營業資訊正不正確,影響更直接。
依網站類型的對照表
表格可左右滑動
| 服務與內容 | 希望 AI 做什麼 | 搜尋用 | 訓練用 | 另外要查 |
|---|---|---|---|---|
| 媒體:即時新聞 | 被引用、帶回讀者 | 多半開放 | 視授權立場 | AI 導流是否足以彌補摘要造成的點擊減少 |
| 媒體:深度、付費內容 | 被引用但不被整篇重製 | 視授權立場 | 多半限制,或另談授權 | 付費牆、搜尋摘要能顯示多長 |
| 電商平台 | 留住比較與交易流程 | 視商業模式 | 多半限制 | 商品 feed、Catalog、代理式商店設定 |
| 電商品牌、獨立商店 | 出現在 AI 購物與比價 | 多半開放 | 視授權立場 | Catalog 與 robots.txt 是否分開管理 |
| 社群與論壇 | 內容以授權方式提供 | 多半限制 | 多半限制 | API 授權條款 |
| 品牌官網、B2B、SaaS | 被正確引用、被推薦 | 開放 | 視授權立場 | 舊頁面、價格與規格是否一致 |
| 會員區、後台、個資 | 完全不被讀取 | 限制 | 限制 | 一定要用登入或存取控制 |
以最常見的「擋訓練、留搜尋」為例,決定好之後,設定內容其實就是下面這張表:
| 爬蟲 | 公司 | 用途 | 設定 |
|---|---|---|---|
| OAI-SearchBot | OpenAI | 搜尋 | 可以抓 |
| Claude-SearchBot | Anthropic | 搜尋 | 可以抓 |
| PerplexityBot | Perplexity | 搜尋 | 可以抓 |
| GPTBot | OpenAI | 訓練 | 不准抓 |
| ClaudeBot | Anthropic | 訓練 | 不准抓 |
| Google-Extended | 訓練 | 不准抓 | |
| 其他沒列到的爬蟲 | — | — | 不受影響 |
把這張表交給工程師或網站管理者就行了。爬蟲名稱會變,設定前請以各家最新公告為準。
給工程師:這張表寫成 robots.txt 的樣子
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /
改規則之前,先知道這四件事
- 只有守規矩的爬蟲會照做。Shopify 寫明不保證所有爬蟲遵守;OpenAI 與 Perplexity 也說明,使用者在對話裡要 AI 打開網頁時,可能不照規則走。真正不能外流的內容,要靠登入來擋。
- 網站的防火牆可能另有一套。Cloudflare 這類 CDN 服務也能擋 AI 爬蟲,設定可能和 robots.txt 寫的不一樣。改完之後,請工程師實際測一次。
- 每個子網域都要各放一份。例如 news.example.com 和 video.example.com 是分開的,規則要各自設定。Anthropic 的說明也特別提醒這點。
- 名單會變。AI 公司會新增或改名爬蟲。沒點名 Claude-SearchBot,可能是刻意不擋,也可能只是還沒更新,光看檔案判斷不了。維護自己的規則時,記下修改日期和原因。
AI 爬蟲也會讀 sitemap 和 RSS。Google 的 John Mueller 在 2026 年 10 月 1 日的 Search Off the Record 節目〈Do sitemaps still matter?〉中提到,AI 訓練爬蟲通常沒有提交 sitemap 的管道,建議沿用預設檔名 sitemap.xml 或提供 RSS;他也在自己的伺服器紀錄中看過 AI 爬蟲讀取 sitemap 和 RSS。想讓 AI 爬蟲讀到新文章,維持 sitemap 正確更新,比另外寫新的檔案更實際。
用 AI 幫自己的網站做決定
看完別人的做法,最後還是要回到自己的網站。這件事可以交給手邊的 ChatGPT、Claude 或 Gemini 先整理一輪,但要給它足夠的背景。只問「我該不該擋 AI 爬蟲?」,得到的多半是兩邊各說一點的通用答案。
AI 需要知道的有四件事:你的網站靠什麼賺錢、有哪幾類內容、希望 AI 拿這些內容做什麼、目前的 robots.txt 長什麼樣子。先把下面這些資料準備好:
| 要填的 | 舉例 |
|---|---|
| 網站網址與類型 | https://example.com,品牌官網 |
| 主要收入 | 商品銷售 |
| 有哪幾類內容 | 商品頁、說明文件、會員區 |
| 希望被 AI 搜尋引用的 | 商品頁、說明文件 |
| 不想被拿去訓練模型的 | 付費教學文章 |
| 完全不能被讀取的 | 會員區 |
| 目前的 robots.txt | 在瀏覽器打開「你的網域/robots.txt」,整份複製 |
把資料填進提示詞、貼給 AI,它會依序回你五樣東西:
- 你的網站目前對各家 AI 爬蟲是擋還是放
- 每一類內容建議開放或限制,以及理由
- 一份建議的 robots.txt,可以直接交給工程師
- robots.txt 做不到、要改用其他方法的事
- 它不確定、需要你再查證的地方
展開完整提示詞(可直接複製)
你是熟悉 robots.txt 與 AI 爬蟲的網站顧問。請幫我決定網站要對哪些 AI 爬蟲開放。

【我的網站】
- 網址:[例如 https://example.com]
- 類型:[新聞媒體/電商平台/品牌官網/SaaS/在地商家/部落格]
- 主要收入:[廣告/訂閱/商品銷售/服務詢問/授權]
- 內容分類:[例如 即時新聞、付費專欄、商品頁、說明文件、會員區]

【我希望 AI 做的事】
- 希望被 AI 搜尋引用的內容:[填寫]
- 不希望被拿去訓練模型的內容:[填寫]
- 完全不能被讀取的內容:[填寫]

【目前的 robots.txt】
[貼上 https://你的網域/robots.txt 的完整內容]

請依序回答:
1. 用一張表列出我目前對 GPTBot、OAI-SearchBot、ChatGPT-User、ClaudeBot、Claude-SearchBot、Claude-User、PerplexityBot、Perplexity-User、Google-Extended 的實際效果(封鎖/放行/未點名)。
2. 依我的內容分類,建議每類對「訓練用」「搜尋用」「使用者觸發」三種爬蟲開放或限制,並各用一句話說明理由。
3. 寫出建議的 robots.txt 全文。
4. 列出 robots.txt 做不到、要改用其他方法的事項(例如登入控管、noindex、nosnippet、CDN 設定)。
5. 標出你不確定、需要我到各家官方文件核對的地方。
拿到答案之後,有三件事要自己把關。
- bot 名稱要對照官方文件。AI 的知識有截止日期,業者新增或改名的 bot 它可能不知道。本文參考資料裡列了四家業者的說明頁。
- 第 1 題的判讀要抽查。網站同時有「給所有爬蟲」和「給特定爬蟲」的規則時,AI 偶爾會看錯。挑一兩個 bot,照本文「robots.txt 是什麼」一節的比對順序自己看一次。
- 建議只是起點。要不要開放,牽涉授權談判、流量與收入,這些 AI 看不到。改了規則之後,記下日期與原因,之後再用流量資料回頭檢查。
robots.txt 與 AI 爬蟲常見問題
robots.txt 是什麼?
robots.txt 是放在網站根目錄的文字檔,用來告訴爬蟲哪些路徑可以抓、哪些不行。它是一種公開的約定,守規矩的爬蟲會遵守,但它不是密碼或防火牆,不能真正阻止存取。
擋 GPTBot,ChatGPT 就搜尋不到我嗎?
不一定。依 OpenAI 的說明,GPTBot 用於訓練,ChatGPT 搜尋用的是 OAI-SearchBot。只擋 GPTBot、放行 OAI-SearchBot,網頁仍可能出現在 ChatGPT 的搜尋回答中。
擋 Google-Extended 會讓網站從 AI 摘要消失嗎?
不會。Google-Extended 只決定內容能不能用在 Gemini 等用途,不影響 Google 搜尋。AI 摘要和 AI 模式屬於 Google 搜尋,跟著一般搜尋的設定走。
Anthropic 有哪些爬蟲?
依 Anthropic 官方說明,ClaudeBot 用於蒐集訓練資料,Claude-SearchBot 用於提升搜尋結果品質,Claude-User 則在使用者向 Claude 提問時讀取網頁。三者可以在 robots.txt 分開設定。
需要另外寫 llms.txt 嗎?
目前主要 AI 搜尋服務都沒有公開承諾會讀取 llms.txt。與其另外維護一份檔案,先確認 robots.txt、sitemap 與頁面內容正確,效果比較確定。
延伸閱讀
放行 AI 搜尋後,是否有帶回訪客?訪客在網站做了什麼,下一篇〈GA4 看得到 ChatGPT 流量,但看不到完整的 AI 影響〉會接著談。
資料與方法
- 2026-09-23 從台灣網路位置,以公開 HTTP GET 取得 16 家台灣與 12 家國際新聞媒體、Amazon、Walmart、Reddit、Dcard 的 robots.txt。天下雜誌回應 403、商業周刊回應 404,未納入。原始檔、擷取時間與 SHA-256 保存於 LS-Labs 工作區。
- 媒體名單依台灣與國際常見新聞網站選取,不是隨機樣本,不代表整體媒體業。
- 判讀只看根目錄
/是否被禁止,依 RFC 9309:先找名稱相符的規則群組,找不到才用User-agent: *;同一路徑以最長相符規則為準。只禁止部分路徑的情形標為「放行(限路徑)」。 - robots.txt 可能依請求地區、時間而不同,本文只描述當次取得的版本;也不代表網站在 CDN 或防火牆層實際允許或阻擋哪些請求。bot 用途以各業者官方文件為準。
- 「與 OpenAI 公開合作」依 OpenAI 官方公告核對 News Corp、Financial Times、Vox Media、Axios 四家;其他媒體未逐一核對。
參考資料
- IETF RFC 9309:Robots Exclusion Protocol(2022 年 9 月)
- Google Search Central:robots.txt 簡介
- Wikipedia:The New York Times v. Microsoft and OpenAI(訴訟時間線,2026-09-23 查閱)
- OpenAI:A landmark multi-year global partnership with News Corp
- OpenAI:We're bringing the Financial Times' world-class journalism to ChatGPT
- OpenAI:A Content and Product Partnership with Vox Media
- OpenAI:Partnering with Axios expands OpenAI's work with the news industry
- OpenAI:OpenAI and Reddit Partnership
- Pew Research Center:Google users are less likely to click on links when an AI summary appears in the results
- Cloudflare:Content Independence Day: no AI crawl without compensation!
- Shopify Help Center:Editing robots.txt.liquid
- Shopify Help Center:Shopify Catalog and product discovery for agentic storefronts
- OpenAI:Overview of OpenAI Crawlers
- Anthropic:Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Perplexity:Perplexity Crawlers
- Google Search Central:Google 的常見檢索器(Google-Extended)
- Google Search Central:AI features and your website
- 各網站 robots.txt:表 1、表 2 所列媒體,以及 Amazon、Walmart、Reddit、Dcard(2026-09-23 取得)