文章目录文章开头0%
2023 年 12 月,《纽约时报》起诉 OpenAI 与微软,主张自家报道在未经授权的情况下被拿去训练模型。五个月后,《华尔街日报》的母公司 News Corp 宣布与 OpenAI 签下多年期内容合作。
9 月 23 日,LS-Labs 抓取了 28 家台湾与国际新闻媒体的 robots.txt,取得 26 份可判读的文件。最终结果显示,有的连搜索用的 bot 都屏蔽,有的只屏蔽训练,也有的明确放行。
这显示了当前各网站对于爬虫的不同应对政策。同一份内容可以用来训练模型,有的则可以被用作搜索回答的来源。
- 在 12 家国际媒体中,ClaudeBot 和 PerplexityBot 各有 11 家封锁。对 OpenAI 的处理则分为两类。
- 在 14 家台湾媒体中,6 家封锁 GPTBot 和 ClaudeBot;另外 6 家对表中五个 AI bot 都没有写专属规则。
- 同一家 AI 公司通常有训练、搜索、用户触发三种爬虫,网站可以分开设置。
robots.txt 是什么
robots.txt 顾名思义,就是让机器人读得到的内容。它是一个放在网站根目录的纯文本文件,网址固定是“域名/robots.txt”,例如本网站 lslabs.tw 的 robots.txt 就是 https://lslabs.tw/zh-cn/robots.txt。
这份文件的读者很简单,就是那些会自动抓取网页的程序,也就是常说的爬虫或 bot。文件内容是在明确告诉它们:哪些内容可以抓,哪些内容不准抓。
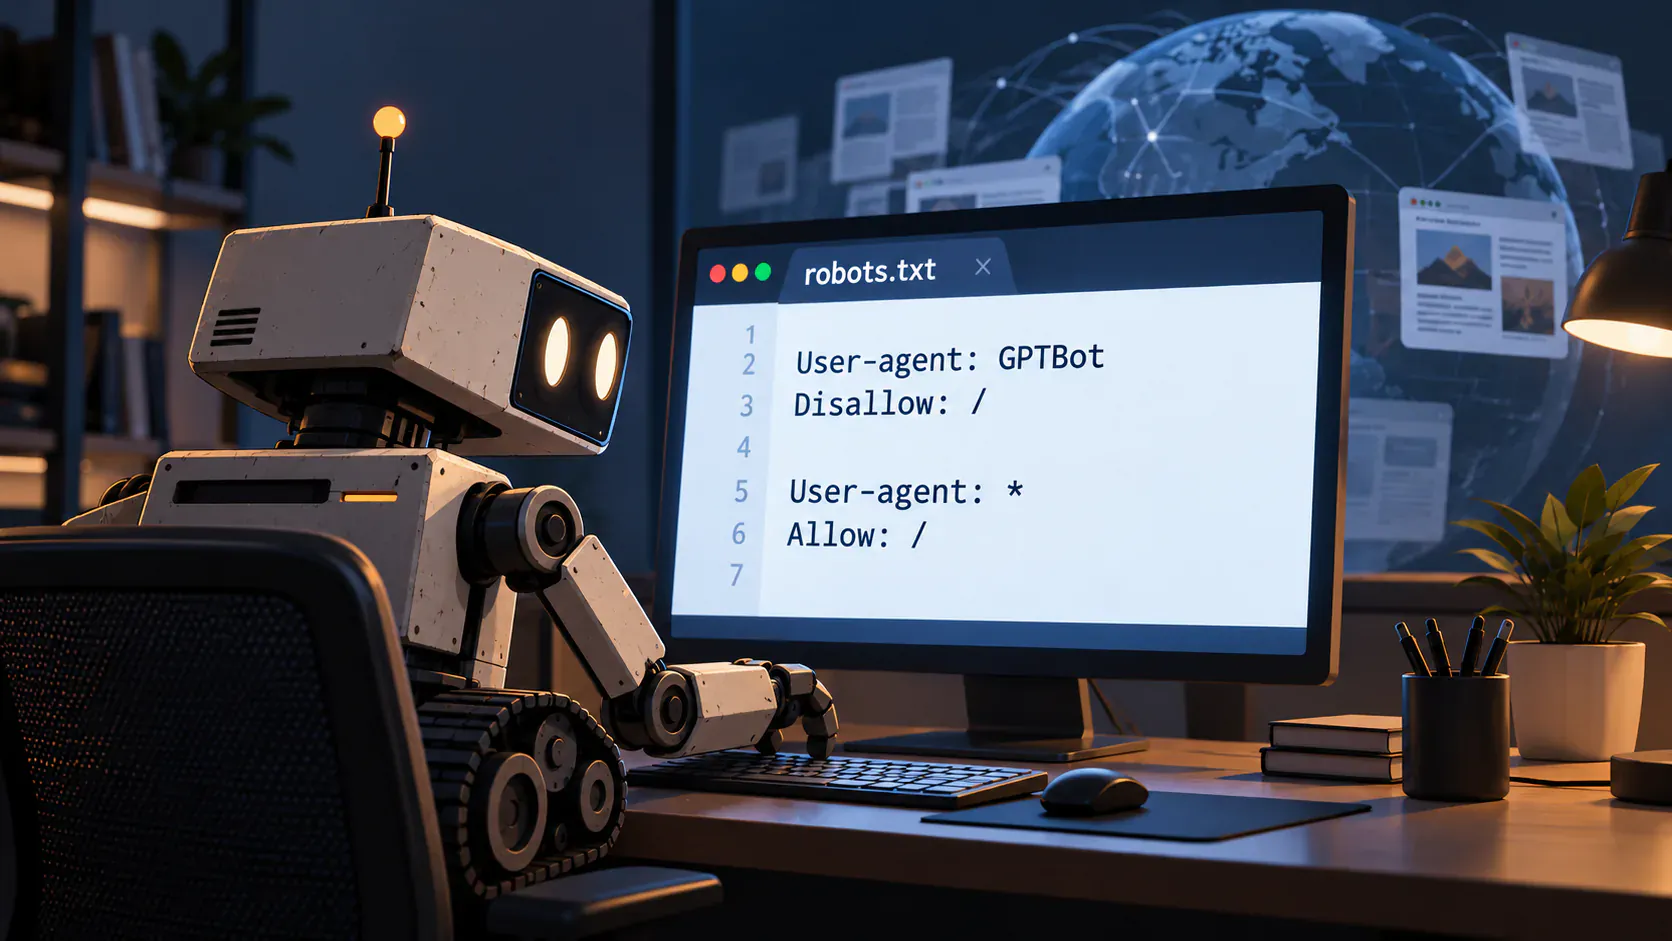
文件里写的,就是一条条“对哪个爬虫说、准不准抓”的规则。看懂三个英文单词就够了:User-agent 是“对谁说”,Disallow 是“不准抓”,Allow 是“可以抓”。
举个例子,左边是 robots.txt 的原文,右边翻译成白话:
| robots.txt 原文 | 白话意思 |
|---|---|
User-agent: GPTBotDisallow: / | OpenAI 的训练爬虫 GPTBot:整个网站都不准抓 |
User-agent: *Disallow: /admin/ | 其他所有爬虫(* 代表所有):后台页面不准抓,其他都可以 |
每个爬虫会先找有没有点名自己的规则;没有,就按“所有爬虫”那条走。这套做法 1994 年就有人用,2022 年才成为正式的国际标准。
不过要记得,robots.txt 更像贴在门口的告示,不是门锁。守规矩的爬虫会照做,不守规矩的照样进得来。它也只管爬虫能不能进来抓,不管搜索结果怎么显示;想让页面不出现在 Google 搜索中,要另外设置(技术上叫 noindex)。
AI 公司的爬虫也按照这套规则报上名字。看下面的表,先记住两个就够了:GPTBot 抓数据给 OpenAI 训练模型,OAI-SearchBot 抓网页供 ChatGPT 搜索使用。两者都属于 OpenAI,但网站可以分开设置。
26 份文件显示各媒体对爬虫与 AI 的不同看法
作为一家媒体,自然希望报道被越多人看到,但如果人们逐渐从打开报道的官网,变成只从 AI 那里获取想要的消息,那么自家网站的流量还能维持吗?
这应该是如今许多主流媒体遇到的两难。
一方面希望自己被 AI 看到,率先抢占 AI 时代的入口;另一方面又担心开放 AI 读取后,自家网站没人看,自然而然得不到广告收益。
在 Pew Research Center 2025 年的研究中,出现 AI 概览的 Google 搜索页面,只有 1% 的访问点击了概览里的引用链接。这也证实了各家媒体对 robots.txt 是否开放的担忧。
当大家都只看 AI 给出的摘要,媒体在数字端的利润又从何而来?
先认识表格里的五个爬虫
下面两张表会出现五个爬虫的名字,分属四家公司:
- GPTBot(OpenAI):帮 ChatGPT 背后的模型收集训练数据。屏蔽它,等于说“我的内容不要拿去训练”。
- OAI-SearchBot(OpenAI):ChatGPT 搜索用的爬虫。屏蔽它,网页就不会出现在 ChatGPT 搜索的回答里。
- ClaudeBot(Anthropic):帮 Claude 收集训练数据,角色和 GPTBot 类似。
- PerplexityBot(Perplexity):AI 搜索引擎 Perplexity 的爬虫,让网站出现在它的回答里并附上链接。官方表示不拿来训练模型。
- Google-Extended(Google):决定内容能不能拿去训练 Gemini。它不影响 Google 搜索,也管不到 Google 的 AI 概览。
表格里的“封锁”是网站明确拒绝这个爬虫;“放行”是明确欢迎,“放行(限路径)”则是大体欢迎、只屏蔽部分页面;“未点名”是网站没特别提到它,实际上等于没屏蔽。
以下为实际爬取国际各大媒体官网得出的数据
表格可左右滑动
| 媒体 | GPTBot | OAI-SearchBot | ClaudeBot | PerplexityBot | Google-Extended | OpenAI 合作 |
|---|---|---|---|---|---|---|
| The New York Times | 封锁 | 封锁 | 封锁 | 封锁 | 封锁 | (诉讼中) |
| The Guardian | 未点名 | 未点名 | 封锁 | 封锁 | 未点名 | — |
| BBC | 封锁 | 封锁 | 封锁 | 封锁 | 封锁 | — |
| Reuters | 封锁* | 放行(限路径) | 封锁* | 封锁* | 封锁* | — |
| CNN | 封锁 | 封锁 | 封锁 | 封锁 | 封锁 | — |
| The Washington Post | 未点名 | 未点名 | 封锁 | 封锁 | 未点名 | — |
| The Wall Street Journal | 放行(限路径) | 放行(限路径) | 封锁* | 封锁* | 封锁* | 是** |
| Financial Times | 未点名 | 未点名 | 封锁 | 封锁 | 封锁 | 是 |
| AP News | 封锁 | 未点名 | 封锁 | 封锁 | 未点名 | — |
| Bloomberg | 封锁 | 封锁 | 封锁 | 封锁 | 封锁 | — |
| Axios | 未点名 | 未点名 | 未点名 | 未点名 | 放行(限路径) | 是 |
| The Verge | 放行 | 未点名 | 封锁 | 封锁 | 封锁 | 是** |
“未点名”指 robots.txt 没有该 bot 的专属规则,且通用规则 User-agent: * 未封锁根目录。“封锁*”指网站采用白名单写法:只放行列名的 bot,其余一律封锁。“OpenAI 合作”只列本文已从 OpenAI 官方公告核对过的四家,**为经由母公司合作(华尔街日报属 News Corp,The Verge 属 Vox Media);标“—”代表本文未核对,不代表确定没有合作。
12 家中最一致的规则,是封锁 ClaudeBot 和 PerplexityBot,各有 11 家。
对 OpenAI 则分为两类。纽约时报、BBC、CNN、Bloomberg 这几家媒体连搜索用的 OAI-SearchBot 也屏蔽;华尔街日报、金融时报、The Verge、Axios 这四家已公开与 OpenAI 合作,因此 GPTBot 在根目录都没有被屏蔽。
其中,华尔街日报和路透社采用的是白名单:只放行列名的 bot,其他一律屏蔽。华尔街日报的名单里有 OpenAI 的三个 bot;路透社列了 OAI-SearchBot 和 ChatGPT-User,没有列 GPTBot。
以下为实际爬取台湾各大媒体官网得出的数据
表格可左右滑动
| 媒体 | GPTBot | OAI-SearchBot | ClaudeBot | PerplexityBot | Google-Extended |
|---|---|---|---|---|---|
| 联合新闻网 | 封锁 | 未点名 | 封锁 | 未点名 | 未点名 |
| 自由时报 | 封锁 | 未点名 | 封锁 | 未点名 | 放行 |
| 中时新闻网 | 封锁 | 封锁 | 封锁 | 封锁 | 放行 |
| 中央社 | 封锁 | 未点名 | 封锁 | 封锁 | 封锁 |
| 报导者 | 封锁 | 放行 | 封锁 | 未点名 | 封锁 |
| 关键评论网 | 封锁 | 未点名 | 封锁 | 未点名 | 未点名 |
| ETtoday | 放行 | 放行 | 放行 | 放行 | 未点名 |
| 三立新闻网 | 放行 | 放行 | 放行 | 放行 | 未点名 |
| TVBS 新闻网 | 未点名 | 未点名 | 未点名 | 未点名 | 未点名 |
| 公视新闻网 | 未点名 | 未点名 | 未点名 | 未点名 | 未点名 |
| 风传媒 | 未点名 | 未点名 | 未点名 | 未点名 | 未点名 |
| 镜周刊 | 未点名 | 未点名 | 未点名 | 未点名 | 未点名 |
| 钜亨网 | 未点名 | 未点名 | 未点名 | 未点名 | 未点名 |
| 数位时代 | 未点名 | 未点名 | 未点名 | 未点名 | 未点名 |
天下杂志(HTTP 403)与商业周刊(HTTP 404)未取得可判读的 robots.txt,不列入表中。
数据显示,台湾的 14 家媒体中有 6 家封锁了 GPTBot 和 ClaudeBot。
而面对搜索用的 OAI-SearchBot,做法又出现了分歧:联合新闻网、自由时报、中央社、关键评论网没有写;报导者明确放行;只有中时新闻网连它一起屏蔽。
ETtoday 和三立新闻网走另一个方向,对表中四个爬虫都明确写了欢迎抓取。其余 6 家没有特别提到这五个爬虫,也就是都没屏蔽。为什么没写,文件本身看不出来。
和国际样本相比,台湾这 14 家没有一家点名 Anthropic 的搜索用 bot Claude-SearchBot,封锁 PerplexityBot 的也只有 2 家。规则大多集中在 GPTBot 和 ClaudeBot 这两个较早公开的名字。
为什么可以屏蔽训练、保留搜索
主要 AI 公司都把爬虫按用途拆分。屏蔽哪一个,影响的范围不一样。
智能体读取页面之后,还可能遇到登录、操作授权与结果确认。这些后续步骤属于 AX 智能体体验的检查范围,不能只靠 robots.txt 判断是否可行。
- 训练用:把公开内容收去当 AI 的教材。屏蔽它,是告诉 AI 公司“别拿我的内容去训练”,实际怎么做仍看各家政策。
- 搜索用:让 AI 搜索找得到你的网页。屏蔽它,网页就比较难出现在 AI 的回答和引用链接里。
- 用户触发:用户在对话里粘贴网址、要 AI 帮忙看,AI 才去打开那一页。有些厂商表示,这种情况不一定按 robots.txt 走。
表格可左右滑动
| 厂商 | 训练用 | 搜索用 | 用户触发 |
|---|---|---|---|
| OpenAI | GPTBot:屏蔽后,内容就不该被拿去训练 | OAI-SearchBot:屏蔽后,就不会出现在 ChatGPT 搜索的回答里 | ChatGPT-User:官方说 robots.txt“可能不适用” |
| Anthropic | ClaudeBot:屏蔽之后,新内容应排除在训练数据之外 | Claude-SearchBot:屏蔽后,可能较少出现在 Claude 的搜索结果里 | Claude-User:屏蔽后,用户问 Claude 时它读不到你的网站 |
| Perplexity | 官方表示 PerplexityBot 不拿来训练模型 | PerplexityBot:让网站出现在 Perplexity 的回答里并附上链接 | Perplexity-User:官方说“一般会忽略 robots.txt” |
| Google-Extended:决定内容能不能拿去训练 Gemini | 一般的 Googlebot:AI 概览和 AI 模式算 Google 搜索的一部分,跟着普通搜索的设置走 | (本表不列) |
Google 这一列最容易看错。Google-Extended 管的是内容能不能拿去训练 Gemini,不影响网页能不能被 Google 搜索收录。
而 AI 概览和 AI 模式属于 Google 搜索本身。媒体如果不想让报道出现在 AI 概览里,就要用 nosnippet 这类片段控制。
除了最简单的允许与拒绝外,Robots.txt 也有一些特别的规范
是否允许这些 AI 读取,只是第一步,至于是否允许被抓取用于其他用途,仍各有不同。
表格可左右滑动
| 做法 | 怎么设置 | 能得到什么 | 还不知道的 | 本次样本中的例子 |
|---|---|---|---|---|
| 全部开放 | 什么都不写,或逐一写明欢迎 | 训练、搜索都能抓 | 实际有没有带来引用和流量 | ETtoday、三立新闻网;未点名的 6 家 |
| 屏蔽训练、保留搜索 | 屏蔽 GPTBot、ClaudeBot,放行 OAI-SearchBot 等搜索爬虫 | 还能出现在 AI 搜索的回答与引用里 | 搜索爬虫拿走的内容怎么用,仍看厂商政策 | 报导者、联合新闻网、自由时报、AP News |
| 全部封锁 | 表中五个爬虫全屏蔽 | 清楚表态:不准抓 | 实际能不能屏蔽住、内容会不会从其他渠道流出 | 纽约时报、BBC、CNN、Bloomberg |
| 选择性放行 | 只列出欢迎的爬虫,其他全部屏蔽(白名单) | 指定的爬虫能抓 | 背后有没有授权合作、条件是什么 | 华尔街日报、路透社 |
| 按次收费 | 在 Cloudflare 这类网络服务上设置封锁或收费 | 向抓取的 AI 公司收费 | 谁会付钱、实际收入多少 | 本次样本无法从 robots.txt 判断 |
表格中最后一种较为特殊,它来自基础设施厂商,也就是赫赫有名的 Cloudflare。
Cloudflare 在 2025 年 7 月宣布,新加入的域名默认会询问是否允许 AI 爬虫,同时推出让网站按次向 AI 爬虫收费的 Pay Per Crawl 测试方案。这类设置只在网络层执行,robots.txt 上看不到。
因此,现在同一家媒体也可以按内容分开处理。即时新闻可能更在意触达,深度调查和付费内容可能优先谈授权。天气、交通、开票这类信息被摘要之后,读者还有没有理由进站,也值得另行观察。
媒体以外:电商、社交平台、品牌官网、本地商家
电商平台:交易入口要不要让出去
同一天抓到的 Amazon robots.txt,点名了 99 个爬虫,全部整站拒绝,训练、搜索、用户触发三类 AI 爬虫都在其中。Amazon 同时是商品数据库、比价页面和结账入口。外部 AI 读取商品页后,比较和推荐这一环节就移到了别人的界面上。LS-Labs 此前整理过 Amazon 封锁 Meta Muse 代客购物的新闻,方向相同。
Walmart 同一天的 robots.txt 只限制账号、API、站内搜索、订单等功能路径,没有 AI bot 的专属规则。
Shopify 提醒商家的是另一件事:在 robots.txt 里屏蔽 AI 爬虫,只影响商品在开放网络上被找到的机会。商家如果开通了 ChatGPT、Microsoft Copilot 这类代理式商店,商品数据仍会经由 Shopify Catalog 同步过去。屏蔽爬虫和退出 AI 购物,是两个不同的开关。
社交平台:robots.txt 全部屏蔽,数据另走授权
Reddit 的 robots.txt 只写了一条规则:所有爬虫,整站都不准抓,并附上它的公开内容政策。但 Reddit 的内容没有因此从 AI 中消失。2024 年 5 月,OpenAI 宣布通过 Reddit 官方的数据接口(Data API)获取实时内容。大门关上了,数据改走授权合作。
台湾的 Dcard 则只屏蔽了一个与会员账号相关的页面,没有针对 AI 爬虫的规则。想知道一个平台怎么把数据提供给 AI,除了 robots.txt,还要看它和 AI 公司有没有授权合作。
企业使用社交平台时,也要留意商业条款是否另行要求站外内容授权。Meta 的更新引发了这类争议:Meta 新商业条款:站外网站抓取与 AI 训练授权争议。
品牌官网、B2B、SaaS:多半希望被读取
品牌官网不靠页面浏览赚钱。产品说明、价格、规格、文档被 AI 正确引用,对它们通常是好事。这类网站更该担心的是 AI 读错:旧价格页还能抓到、规格只写在图片里、文档好几个版本混在一起。先确认 AI 读到的内容正确一致,要不要屏蔽可以放在后面。
会员区、后台和测试环境是例外,一定要用登录管控,不能只靠 robots.txt。
本地商家:决定权多半不在自己的网站
餐厅、诊所、健身房这类本地商家,AI 回答常引用的是地图、评论平台和美食笔记。LS-Labs 的〈AI 搜索时代的检索机制报告〉整理过没有官网的商家仍被 AI 回答提到的情形。对这类商家,官网 robots.txt 的影响有限;平台上的营业信息正确与否,影响更直接。
按网站类型的对照表
表格可左右滑动
| 服务与内容 | 希望 AI 做什么 | 搜索用 | 训练用 | 另外要查 |
|---|---|---|---|---|
| 媒体:即时新闻 | 被引用、带回读者 | 多半开放 | 视授权立场 | AI 导流是否足以弥补摘要造成的点击减少 |
| 媒体:深度、付费内容 | 被引用但不被整篇复制 | 视授权立场 | 多半限制,或另谈授权 | 付费墙、搜索摘要能显示多长 |
| 电商平台 | 留住比较与交易流程 | 视商业模式 | 多半限制 | 商品 feed、Catalog、代理式商店设置 |
| 电商品牌、独立商店 | 出现在 AI 购物与比价 | 多半开放 | 视授权立场 | Catalog 与 robots.txt 是否分开管理 |
| 社交平台与论坛 | 内容以授权方式提供 | 多半限制 | 多半限制 | API 授权条款 |
| 品牌官网、B2B、SaaS | 被正确引用、被推荐 | 开放 | 视授权立场 | 旧页面、价格与规格是否一致 |
| 会员区、后台、个人信息 | 完全不被读取 | 限制 | 限制 | 一定要用登录或访问控制 |
以最常见的“屏蔽训练、保留搜索”为例,决定好之后,设置内容其实就是下面这张表:
| 爬虫 | 公司 | 用途 | 设置 |
|---|---|---|---|
| OAI-SearchBot | OpenAI | 搜索 | 可以抓 |
| Claude-SearchBot | Anthropic | 搜索 | 可以抓 |
| PerplexityBot | Perplexity | 搜索 | 可以抓 |
| GPTBot | OpenAI | 训练 | 不准抓 |
| ClaudeBot | Anthropic | 训练 | 不准抓 |
| Google-Extended | 训练 | 不准抓 | |
| 其他没列到的爬虫 | — | — | 不受影响 |
把这张表交给工程师或网站管理员就行了。爬虫名称会变,设置前请以各家最新公告为准。
给工程师:这张表写成 robots.txt 的样子
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
User-agent: PerplexityBot
Allow: /

User-agent: GPTBot
User-agent: ClaudeBot
User-agent: Google-Extended
Disallow: /
改规则之前,先知道这四件事
- 只有守规矩的爬虫会照做。Shopify 写明不保证所有爬虫遵守;OpenAI 与 Perplexity 也说明,用户在对话里要 AI 打开网页时,可能不按规则走。真正不能外流的内容,要靠登录来屏蔽。
- 网站的防火墙可能另有一套。Cloudflare 这类 CDN 服务也能屏蔽 AI 爬虫,设置可能和 robots.txt 写的不一样。改完之后,请工程师实际测试一次。
- 每个子域名都要各放一份。例如 news.example.com 和 video.example.com 是分开的,规则要各自设置。Anthropic 的说明也特别提醒这一点。
- 名单会变。AI 公司会新增或改名爬虫。没点名 Claude-SearchBot,可能是刻意不屏蔽,也可能只是还没更新,光看文件判断不了。维护自己的规则时,记下修改日期和原因。
AI 爬虫也会读 sitemap 和 RSS。Google 的 John Mueller 在 2026 年 10 月 1 日的 Search Off the Record 节目〈Do sitemaps still matter?〉中提到,AI 训练爬虫通常没有提交 sitemap 的渠道,建议沿用默认文件名 sitemap.xml 或提供 RSS;他也在自己的服务器日志中看到过 AI 爬虫读取 sitemap 和 RSS。想让 AI 爬虫读到新文章,维持 sitemap 正确更新,比另外写新的文件更实际。
用 AI 帮自己的网站做决定
看完别人的做法,最后还是要回到自己的网站。这件事可以交给手边的 ChatGPT、Claude 或 Gemini 先整理一轮,但要给它足够的背景。只问“我该不该屏蔽 AI 爬虫?”,得到的多半是两边各说一点的通用答案。
AI 需要知道的有四件事:你的网站靠什么赚钱、有哪几类内容、希望 AI 拿这些内容做什么、目前的 robots.txt 长什么样。先把下面这些资料准备好:
| 要填的 | 举例 |
|---|---|
| 网站网址与类型 | https://example.com,品牌官网 |
| 主要收入 | 商品销售 |
| 有哪几类内容 | 商品页、文档、会员区 |
| 希望被 AI 搜索引用的 | 商品页、文档 |
| 不想被拿去训练模型的 | 付费教学文章 |
| 完全不能被读取的 | 会员区 |
| 目前的 robots.txt | 在浏览器打开“你的域名/robots.txt”,整份复制 |
把资料填进提示词、粘贴给 AI,它会依次回你五样东西:
- 你的网站目前对各家 AI 爬虫是屏蔽还是放行
- 每一类内容建议开放或限制,以及理由
- 一份建议的 robots.txt,可以直接交给工程师
- robots.txt 做不到、要改用其他方法的事
- 它不确定、需要你再查证的地方
展开完整提示词(可直接复制)
你是熟悉 robots.txt 与 AI 爬虫的网站顾问。请帮我决定网站要对哪些 AI 爬虫开放。

【我的网站】
- 网址:[例如 https://example.com]
- 类型:[新闻媒体/电商平台/品牌官网/SaaS/本地商家/博客]
- 主要收入:[广告/订阅/商品销售/服务咨询/授权]
- 内容分类:[例如 即时新闻、付费专栏、商品页、文档、会员区]

【我希望 AI 做的事】
- 希望被 AI 搜索引用的内容:[填写]
- 不希望被拿去训练模型的内容:[填写]
- 完全不能被读取的内容:[填写]

【目前的 robots.txt】
[粘贴 https://你的域名/robots.txt 的完整内容]

请依次回答:
1. 用一张表列出我目前对 GPTBot、OAI-SearchBot、ChatGPT-User、ClaudeBot、Claude-SearchBot、Claude-User、PerplexityBot、Perplexity-User、Google-Extended 的实际效果(封锁/放行/未点名)。
2. 按我的内容分类,建议每类对“训练用”“搜索用”“用户触发”三种爬虫开放或限制,并各用一句话说明理由。
3. 写出建议的 robots.txt 全文。
4. 列出 robots.txt 做不到、要改用其他方法的事项(例如登录管控、noindex、nosnippet、CDN 设置)。
5. 标出你不确定、需要我到各家官方文档核对的地方。
拿到答案之后,有三件事要自己把关。
- bot 名称要对照官方文档。AI 的知识有截止日期,厂商新增或改名的 bot 它可能不知道。本文参考资料里列了四家厂商的说明页。
- 第 1 题的判读要抽查。网站同时有“给所有爬虫”和“给特定爬虫”的规则时,AI 偶尔会看错。挑一两个 bot,按本文“robots.txt 是什么”一节的比对顺序自己看一次。
- 建议只是起点。要不要开放,涉及授权谈判、流量与收入,这些 AI 看不到。改了规则之后,记下日期与原因,之后再用流量数据回头检查。
robots.txt 与 AI 爬虫常见问题
robots.txt 是什么?
robots.txt 是放在网站根目录的文本文件,用来告诉爬虫哪些路径可以抓、哪些不行。它是一种公开的约定,守规矩的爬虫会遵守,但它不是密码或防火墙,不能真正阻止访问。
屏蔽 GPTBot,ChatGPT 就搜索不到我吗?
不一定。根据 OpenAI 的说明,GPTBot 用于训练,ChatGPT 搜索用的是 OAI-SearchBot。只屏蔽 GPTBot、放行 OAI-SearchBot,网页仍可能出现在 ChatGPT 的搜索回答中。
屏蔽 Google-Extended 会让网站从 AI 概览消失吗?
不会。Google-Extended 只决定内容能不能用于 Gemini 等用途,不影响 Google 搜索。AI 概览和 AI 模式属于 Google 搜索,跟着普通搜索的设置走。
Anthropic 有哪些爬虫?
根据 Anthropic 官方说明,ClaudeBot 用于收集训练数据,Claude-SearchBot 用于提升搜索结果质量,Claude-User 则在用户向 Claude 提问时读取网页。三者可以在 robots.txt 中分开设置。
需要另外写 llms.txt 吗?
目前主要 AI 搜索服务都没有公开承诺会读取 llms.txt。与其另外维护一份文件,不如先确认 robots.txt、sitemap 和页面内容正确,效果更确定。
延伸阅读
放行 AI 搜索后,有没有带回访客?访客在网站上做了什么,下一篇〈GA4 看得到 ChatGPT 流量,但看不到完整的 AI 影响〉会接着谈。
数据与方法
- 2026-09-23 从台湾网络位置,以公开 HTTP GET 获取 16 家台湾与 12 家国际新闻媒体、Amazon、Walmart、Reddit、Dcard 的 robots.txt。天下杂志返回 403、商业周刊返回 404,未纳入。原始文件、抓取时间与 SHA-256 保存于 LS-Labs 工作区。
- 媒体名单按台湾与国际常见新闻网站选取,不是随机样本,不代表整个媒体行业。
- 判读只看根目录
/是否被禁止,按 RFC 9309:先找名称相符的规则群组,找不到才用User-agent: *;同一路径以最长匹配规则为准。只禁止部分路径的情形标为“放行(限路径)”。 - robots.txt 可能因请求地区、时间而不同,本文只描述当次获取的版本;也不代表网站在 CDN 或防火墙层实际允许或拦截哪些请求。bot 用途以各厂商官方文档为准。
- “与 OpenAI 公开合作”按 OpenAI 官方公告核对 News Corp、Financial Times、Vox Media、Axios 四家;其他媒体未逐一核对。
参考资料
- IETF RFC 9309:Robots Exclusion Protocol(2022 年 9 月)
- Google Search Central:robots.txt 简介
- Wikipedia:The New York Times v. Microsoft and OpenAI(诉讼时间线,2026-09-23 查阅)
- OpenAI:A landmark multi-year global partnership with News Corp
- OpenAI:We're bringing the Financial Times' world-class journalism to ChatGPT
- OpenAI:A Content and Product Partnership with Vox Media
- OpenAI:Partnering with Axios expands OpenAI's work with the news industry
- OpenAI:OpenAI and Reddit Partnership
- Pew Research Center:Google users are less likely to click on links when an AI summary appears in the results
- Cloudflare:Content Independence Day: no AI crawl without compensation!
- Shopify Help Center:Editing robots.txt.liquid
- Shopify Help Center:Shopify Catalog and product discovery for agentic storefronts
- OpenAI:Overview of OpenAI Crawlers
- Anthropic:Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Perplexity:Perplexity Crawlers
- Google Search Central:Google 的常见抓取工具(Google-Extended)
- Google Search Central:AI features and your website
- 各网站 robots.txt:表 1、表 2 所列媒体,以及 Amazon、Walmart、Reddit、Dcard(2026-09-23 获取)