文章目錄文章開頭0%
據 Nieman Lab 與 PPC Land 報導,Meta 近期修訂了商業條款(Meta Commercial Terms),預計於 10 月 30 日正式生效。新版條款在第 1 節加入一段自動化軟體授權:凡出於商業目的使用 Meta 產品的企業,皆授權 Meta 派遣網路爬蟲(Web Crawler)進入其產品或服務關聯的外部網站,抓取資料並用於「訓練」旗下產品與模型。
這項條款採消極同意制,且深度綁定了 Facebook 粉絲專頁、Instagram 商業帳號與廣告管理員(Ads Manager)。企業只要在 10 月 30 日後繼續登入投放廣告或維護社群,依 Meta 條款即視為同意授權,合約內並未提供單獨退出爬蟲授權的選項。
10 月 30 日生效的新條款改了什麼?
對比 2024 年 3 月 6 日生效的舊版條款,過去第 1 節僅規範企業「主動上傳、發布或分享至 Meta 平台」的素材(content you share, post or upload on or in connection with the Commercial Products),要求企業確保 Meta 擁有在平台內展示與分發這些素材的權利。然而在 10 月 30 日生效的新版條款中,第 1 節標題從「授權(Licences)」改為「你提供給 Meta 的授權與權利(Licences and rights you provide Meta)」,授權標的直接延伸至站外的獨立網域。
根據新版條款原文,企業授權 Meta(或代表 Meta 的任何實體)使用網路刮取工具、機器人、蜘蛛、爬蟲與使用者代理程式(web scrapers, bots, spiders, crawlers, user agents),並建立「測試憑證(test credentials)」,定期存取、索引、快取、分析、收集與爬取「與你的產品或服務相關」或「透過使用 Meta 產品而提供」的網域與網址。條款載明,Meta 得使用這些網域中的任何內容(any content),來提供、開發、改進、研究、訓練(train)及維護 Meta 旗下產品與服務。
合約邊界的根本轉移:過去平台商業合約的管轄範圍,停留在企業「主動上傳至平台內部」的圖文素材;新版條款則將合約效力延伸到企業自有的獨立網域,將相關站外內容納入 Meta 可能主張的模型訓練與產品研發授權範圍。
在適用對象方面,新版條款擴大了「商業用途」的認定範圍。除了傳統的投放廣告、銷售商品、開發應用程式與管理粉絲專頁外,明確列入「發送行銷訊息」、「建立或使用產品目錄」,以及「使用任何商業產品,例如 Ads Manager 或 Meta Business Suite」。第 7 節則規定,只要在收到更新通知後繼續出於商業目的存取或使用 Meta 產品,即代表同意受新條款約束。若企業不同意授權,唯一的途徑是全面停用所有 Meta 商業工具。
Meta 官方說法與合約文字的落差
針對外界質疑新條款等同讓 Meta 免費爬取新聞媒體與品牌內容網站,Meta 發言人 Andy Stone 於 10 月 16 日在 X 上回應稱報導「不實」。他表示 Meta 使用網路爬蟲的方式並未改變,網站擁有者依然可以透過 robots.txt 標示偏好;此次更新的目的是確保 Meta 在平台內進行廣告與內容推薦時,能從第三方網站抓取準確的待售商品資訊,而非為了抓取新聞網站。Meta 公關部門回覆 Nieman Lab 時也補充,相關爬蟲條文過去分散在生成式 AI 廣告等不同條款中,本次僅是將其整合至同一處。
對照 Meta 的產品佈局,官方解釋確實呼應了近期的電商整合需求。Meta 於 9 月 29 日將旗下 AI 代理人 Muse 擴展至小型企業,讓其存取廣告帳戶與 15 項商業工具(延伸閱讀:Meta Muse 是什麼?Amazon 為何封鎖 Meta 的 AI 代理人?);隨後又計畫於廣告系統中導入站內商品即時瀏覽功能。無論是動態廣告推薦或 AI 代理人代客比價,都高度依賴即時且準確的站外商品規格與庫存資料。
然而,發言人的公開說明描述的是 Meta「目前的商業意圖」,商業條款寫下的則是「Meta 要求企業接受的授權範圍」。三位應 Nieman Lab 之邀審閱條款的法律專家指出,依條款文字,Meta 可能據此主張已取得爬取新聞與原創內容、並用於訓練 AI 的契約授權。條款並未將爬取標的限制在「待售商品頁面」或「產品目錄」,而是涵蓋與產品或服務相關網址上的「任何內容」,且白紙黑字包含了「訓練」一詞。康乃爾大學法學院教授 James Grimmelmann 直言,對以新聞報導為核心產品的媒體,或擁有大量專欄文章與研究報告的品牌網站而言,整座網站都落在「與產品或服務相關」的定義中。
| 比較維度 | 官方對外說法(Andy Stone / 公關) | 新版商業條款原文(10/30 生效) | 實質法律與營運意涵 |
|---|---|---|---|
| 爬取目的 | 抓取第三方待售商品資訊,用於廣告推薦與商品展示 | 提供、開發、改進、研究、訓練(train)與維護 Meta 產品與服務 | 條文明確納入 AI 模型訓練授權,範圍超越廣告導購索引 |
| 涵蓋範圍 | 強調「不是為了爬取新聞網站」 | 與產品或服務相關之網域中的任何內容(any content) | 新聞媒體或品牌專欄皆屬於「與產品或服務相關」的標的 |
| 技術阻擋 | 網站經營者仍可透過 robots.txt 管理爬蟲偏好 | 全文未提 robots.txt,無任何技術排除保障 | Meta 可能主張契約授權優先;是否成立仍有解釋與適用爭議 |
| 存取權限 | 未正面回應是否會繞過付費牆 | 得建立測試憑證(test credentials)進行存取與爬取 | 引發以自動化帳號存取註冊牆(Registration Wall)後內容的疑慮 |
條款中允許建立「測試憑證」以存取網域的文字,更引發法律界對註冊牆與會員專區的疑慮。Grimmelmann 指出,這在技術上等於授權 Meta 以自動化方式註冊帳號,藉此繞過網站的註冊限制。條款未對測試憑證的使用邊界做出限縮,Meta 也拒絕回應 Nieman Lab 關於該憑證是否會用於繞過付費牆或付費內容的詢問。
當商業契約遇上 robots.txt,技術阻擋還有效嗎?
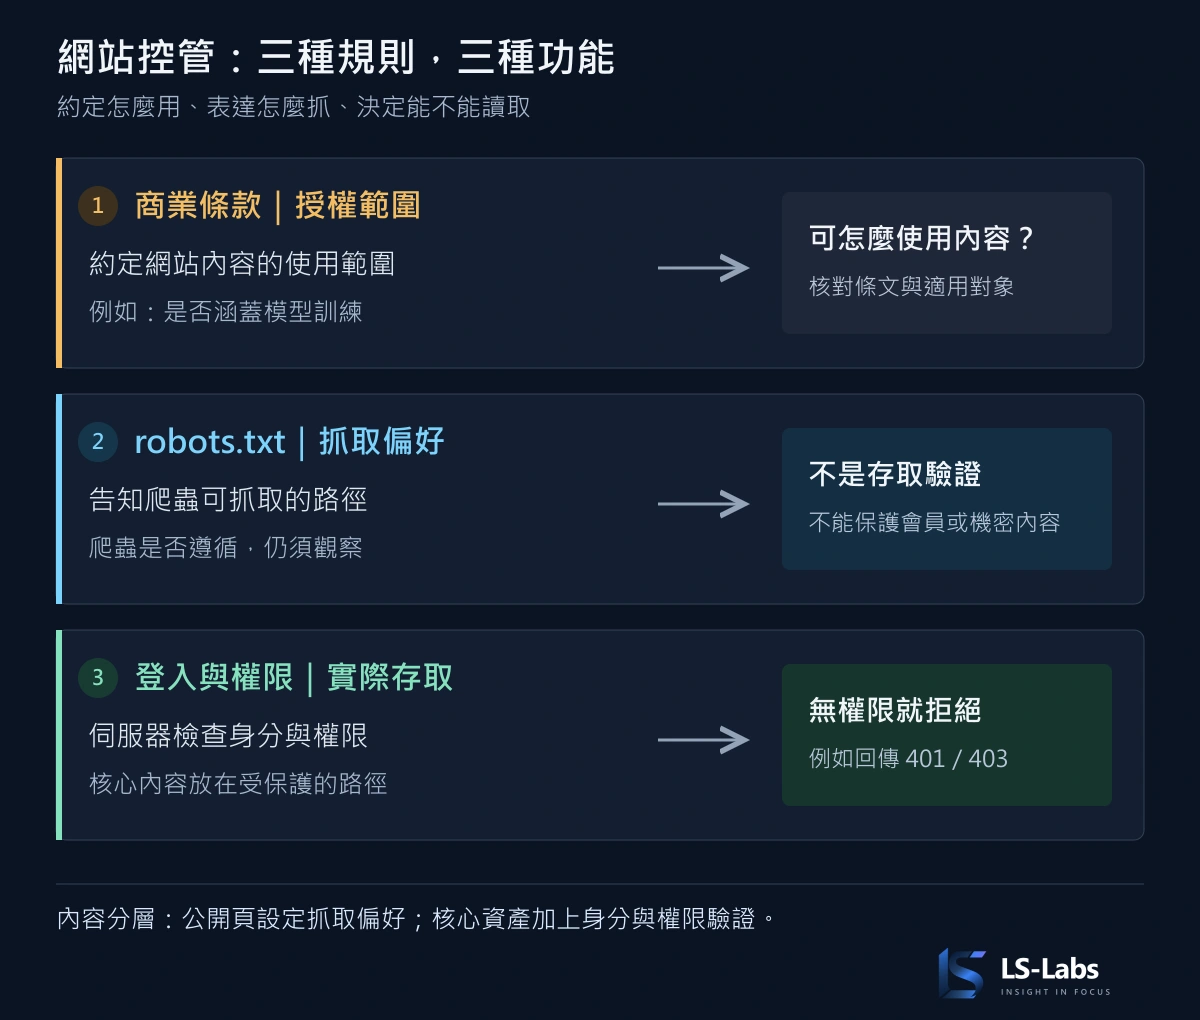
這起爭議對網站技術與營運團隊的核心衝擊,在於「技術規範」與「商業契約」的位階衝突。LS-Labs 在〈robots.txt 該不該擋 AI?〉中曾分析過,各大 AI 開發商通常將爬蟲拆分為訓練用與檢索用,讓網站透過 robots.txt 表達意願。然而 robots.txt 依循 RFC 9309 規範,本質上是供爬蟲遵循的公開抓取規範,不是存取授權或安全控制機制;商業條款則是企業與平台簽署的雙邊契約。
儘管 Andy Stone 強調網站仍可配置 robots.txt,但新版商業條款全文隻字未提 robots.txt,既未將其列為排除條件,亦未約定技術指令具備優先效力。受訪法律學者提醒,若未來衍生資料爬取爭議,Meta 的法務團隊完全可以主張:企業已在商業條款中授權抓取,網站單方面的 robots.txt 指令不應推翻該授權。這是受訪專家指出的法律風險,並非已有法院確認的效力排序。
威斯康辛大學法學教授 Benjamin Sobel 從反壟斷法的「搭售(tying)」架構剖析了這項條款。當大型社群平台與廣告後台已成為企業營運不可或缺的數位基礎設施,Meta 將「商業工具使用權」與「全站 AI 訓練爬取權」綁定,實質上消除了企業的協商空間。這與 Google 過去將傳統搜尋索引與 Google AI Overviews(AIO)綁定的邏輯相似;不同之處在於,Google 隨後開放了獨立退出選項,Meta 的新條款則維持「全盤接受否則停用」的單向條件。
品牌與內容網站的實務檢視
面對即將生效的條款,不同商業模式的網站面臨截然不同的利害關係。對於以實體商品銷售為主的電商與 D2C 品牌而言,讓 Meta 爬蟲即時抓取產品規格、售價與庫存,確實有助於動態廣告與 AI 導購的投放成效。但對於仰賴原創內容、產業調查、深度研究報告或付費會員機制的出版商與專業品牌,全站內容被無償納入大模型訓練語料,將直接衝擊資產價值。
在無法全面退出 Meta 商業生態系的前提下,網站團隊應從三個具體層面建立防護措施:
1. 伺服器端硬性存取控管:不把安全寄託於 robots.txt
條款明確提及建立測試憑證與存取關聯網域。對於內部未公開測試環境、會員付費專區或機密資料庫,絕不能僅依靠 robots.txt 的 Disallow 規則。爬蟲只要知曉路徑即可直接發出請求。必須在伺服器端與網路層(例如 CDN 服務的防火牆)強制部署身分驗證機制(例如 OAuth 2.0、JWT 驗證或 Cloudflare Zero Trust),確保未授權存取一律回傳 401 或 403 狀態碼。
2. 盤點日誌並分流爬蟲:區隔廣告審核與模型訓練
Meta 官方爬蟲文件列出不同職責的 User-Agent(請求中用來識別軟體的名稱)。網站應主動監控伺服器存取日誌(Access Logs),針對爬蟲行為進行分流控管:
meta-externalads:用於改善廣告及其他商業相關產品和服務。封鎖前應確認對廣告與到達網頁(Landing Page)的影響。meta-externalagent:用於大型語言模型訓練與通用數據蒐集的爬蟲。meta-webindexer:用於 Meta AI 即時搜尋索引的檢索爬蟲。facebookexternalhit:抓取分享連結的內容、標題與圖片以產生預覽;執行安全或誠信檢查時可能略過 robots.txt。meta-externalfetcher:應使用者要求擷取個別連結,並支援代理 AI 功能;官方說明其可能略過 robots.txt 規則。
即使合約效力存在爭議,在 robots.txt 中針對 meta-externalagent 明確配置禁止規則,仍能明確表達拒絕偏好;搭配保存設定版本與存取日誌,才有助於後續核對爬蟲是否遵循。
3. 內容資產分層架構:區隔公開引流與核心資產
當平台業者藉由服務條款將資料授權擴展至全網公開網頁,文字資產的防禦必須回歸架構設計:
- 公開引流層:品牌快訊、官方規格、新聞通訊與通用問答,維持開放以爭取在 AI 搜尋與代理人推薦中的可見性。
- 核心資產層:高密度研究白皮書、獨家統計資料集、付費專題或專利技術文獻,改採會員登入、伺服器端權限驗證或受保護的 API 提供,避免在未獲授權與分潤的情況下遭到批次爬取。
使用平台,不該連站外內容都得讓渡
Meta 已坐擁逾 30 億人的使用規模。依其 2026 年第 2 季財報,旗下產品 6 月的平均每日活躍人數達 36 億,而 Facebook 與 Instagram 的公開貼文也早已是訓練 AI 模型的資料來源。Meta 雖然同時強調親友間的私人訊息不在訓練範圍內,除非有人主動將訊息分享給 AI,但這條界線針對的是個人對話,並沒有排除站外企業網站的內容授權。
在我看來,這次更新延續了 Meta 一貫把外部資料視為自身商業資產的思維。它憑藉龐大的平台規模,已經坐享海量公開貼文帶來的訓練資源,如今又透過商業條款,把資料取得範圍延伸到企業自己的網站。企業花預算投廣告、投入人力經營社群,原本是付費向平台購買流量與曝光,現在連從未上傳到 Meta 的官網內容也得一併納入授權,這樣的交換並不公平。
Meta 若認為這些站外內容對訓練 AI 與改善推薦系統有價值,就應提供獨立的授權機制與拒絕選項,讓內容提供者有議價空間,而不是把爬蟲與訓練授權綁進商業工具的使用權裡。把企業對平台的依賴當成取得更多資料的籌碼,是我無法認同的商業做法。
這紙在 10 月 30 日生效的條款,也改寫了企業與社群平台之間的關係。過去品牌把官網視為自己能完全控制的數位資產,社群與廣告只是引流的工具,就算不想讓 AI 抓取網站內容,也能透過 robots.txt 向遵循規範的爬蟲表達拒絕。現在 Meta 改從商業合約下手,依條款文字,只要企業還需要靠粉專接觸受眾、靠廣告系統導流,就得接受相關的爬取授權。當拒絕授權的代價是放棄整個行銷通路,未來網站經營者要面對的就不再只是怎麼寫好一行阻擋指令,而是在高度依賴少數平台流量的現實下,企業還能為自己的內容資產保留多少主導權,這正是 AI 時代非常值得去思考的問題。