文章目录文章开头0%
过去二十年的数字营销,大多建立在一个单纯的线性路径之上:用户输入关键词、搜索引擎提供链接、用户点击链接进入网站,最终流量在官方或第三方网站中完成转化。
然而,生成式 AI 的崛起,正在改写这条路径。Google AI Overviews(AIO)、ChatGPT、Perplexity 等产品,让人们习惯直接在搜索页或对话框中完成信息的获取,这就导致原先的线性路径正在被截断。
本报告聚焦于当前生成式检索的运作机制中的直觉迷思:如果许多没有独立官网的老店,仍然能出现在 AI 的推荐名单里,那品牌为什么还需要官网?
基于这个矛盾出发,本报告结合综合公开研究、平台文件与台北六家牛肉面商家的 Perplexity Sonar API 实测,得出以下结论。
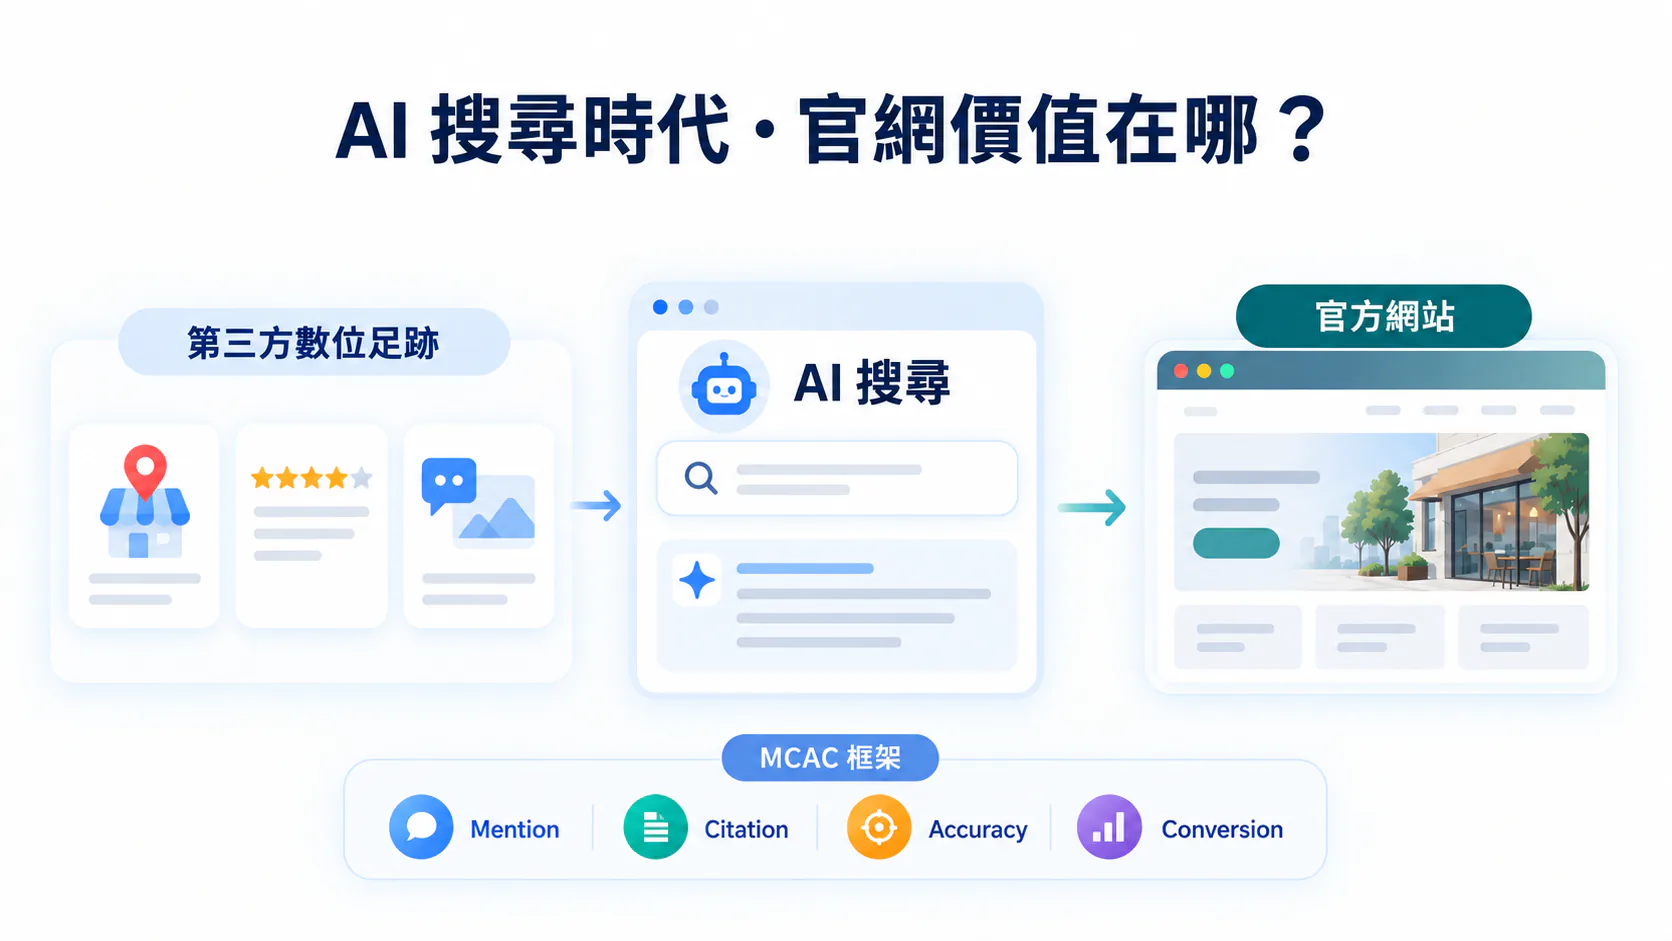
MCAC 框架:Mention、Citation、Accuracy、Conversion-readiness。
目标是分别回答四个问题:固定提问下,AI 是否提到品牌?答案列出哪些来源?可核对的信息是否正确?回答是否提供用户可采取的下一步?
MCAC 用于区分品牌在能见度、引用来源、信息质量与行动入口上的缺口;本次数据没有测量转化率。
一、绪论
1.1 研究背景
过去二十年的搜索引擎生态,核心逻辑是一条线性的路径,用户产生信息需求、搜索引擎通过算法排序网页链接、用户点击进入官方或第三方网站,在网站内完成理解与转化。
在这个单一的线性架构下,网站既是流量的终点,也是所有营销转化发生的核心场域,所有的搜索意图都被收敛在单一网站当中。
然而,随着 Google AI Overviews、ChatGPT 与 Perplexity 等 AI 应用产品普及,搜索引擎正在从“目录导流系统”转变成“信息整合系统”。
品牌可以在用户从未访问官方网站的情况下,被 AI 摘要、推荐,甚至直接给出电话、地址等转化入口。对营销人员而言,这意味着过去用“排名 → 点击 → 网站 → 转化”描述搜索价值的方式,开始出现断裂。
1.2 研究问题与目的
讨论 AI 搜索与 GEO 时,常见的假设是:“品牌必须做好官网与结构化数据,AI 才能读懂并推荐。”本研究检查这个假设在小型样本中的观测结果。
但只要实际通过 AI 应用或 SERP 中的 AIO 查询台湾各地的在地名店,就会发现一个明显的矛盾:许多只有 Google 商家资料、Facebook 粉丝专页,甚至连粉丝专页都没有更新的老字号小吃店,依然频繁出现在 AI 的推荐清单中,且地址、招牌菜与营业信息往往十分准确。
这引出了一个核心问题:如果没有官网也能被 AI 推荐,那官网到底为品牌增加了什么价值?在 AI 搜索时代,应该如何重新定义并量测这种价值?
二、AI 搜索如何改变曝光与获客
2.1 流量漏斗的转变:蓝色链接的失效与 SERP 闭环
传统的搜索主要通过蓝色链接导流与监测成效,因为用户必须前往外部网站才能获取完整的信息,得到确切的答案。但在生成式 AI 普及的当下,这条路径从单一的线性,变成了多分支,甚至是圆形的路径闭环。除了传统的 SERP 被 AIO 截获外,AI 应用本身也是一种 SERP,用户向 GPT 提问 → GPT 直接提供答案 → 用户完成信息的获取,实际上用户在这条路径中,从未去接触蓝色链接,也就是网站本身。
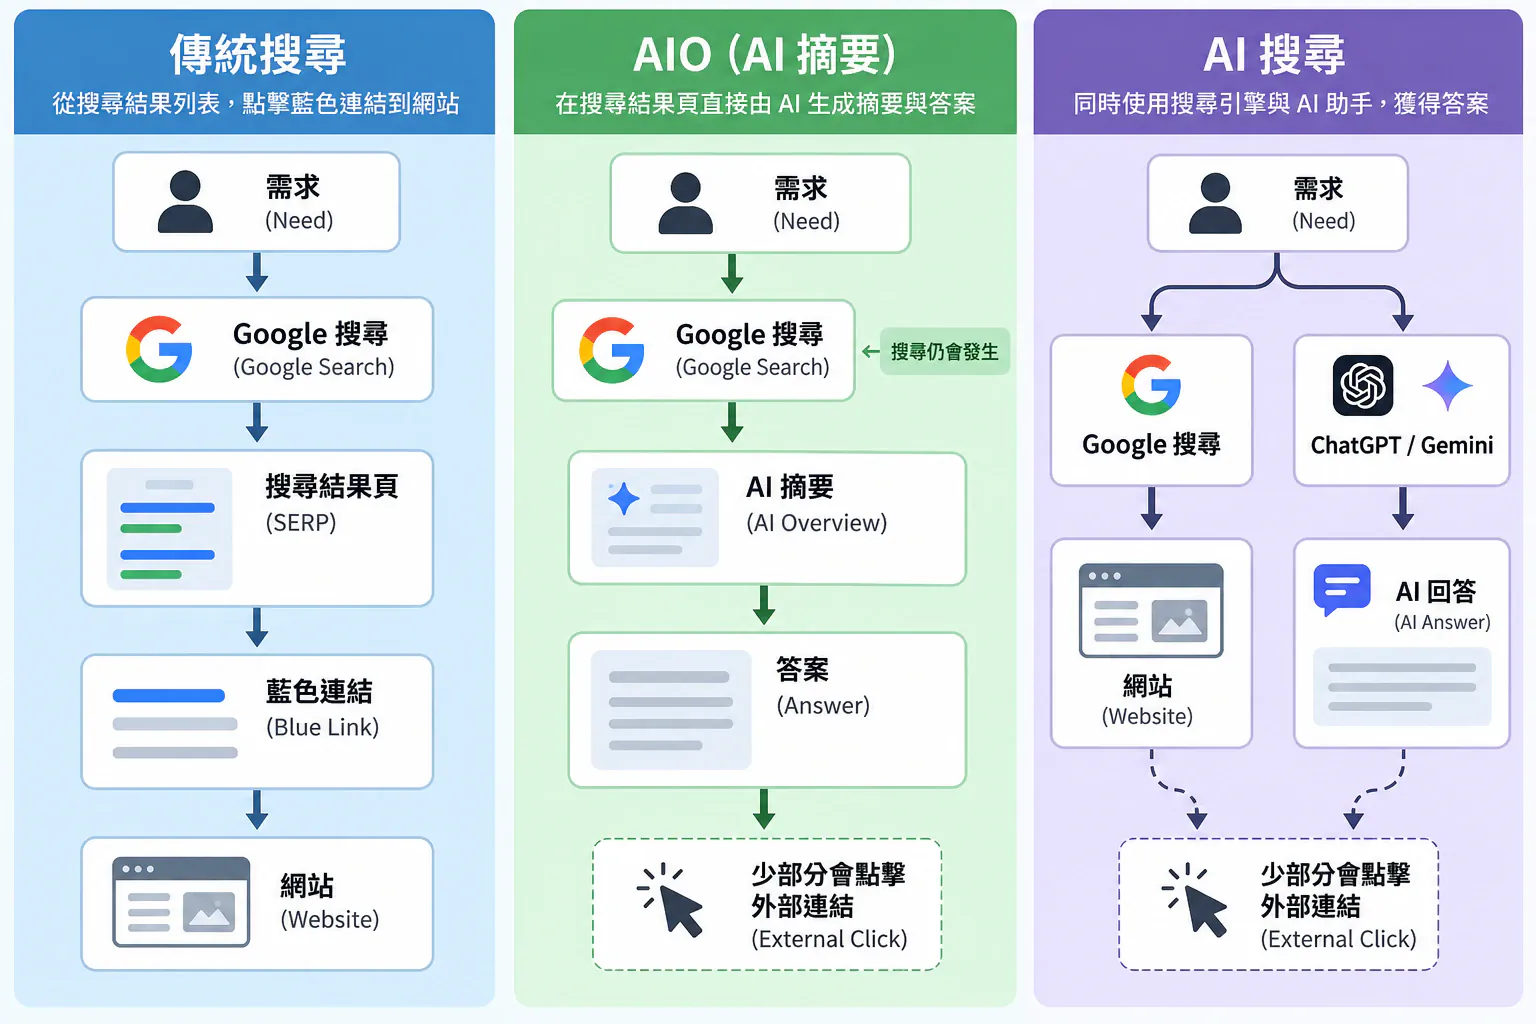
根据 Pew Research Center 追踪 900 名美国成人的浏览记录显示:在出现 Google AI 概览的搜索中,仅约 8% 会点击传统搜索结果;在未出现 AI 概览时,点击率则为 15%;用户点击概览内来源链接的比例约为 1%。这些观测显示,取得答案后不一定会点进网站。
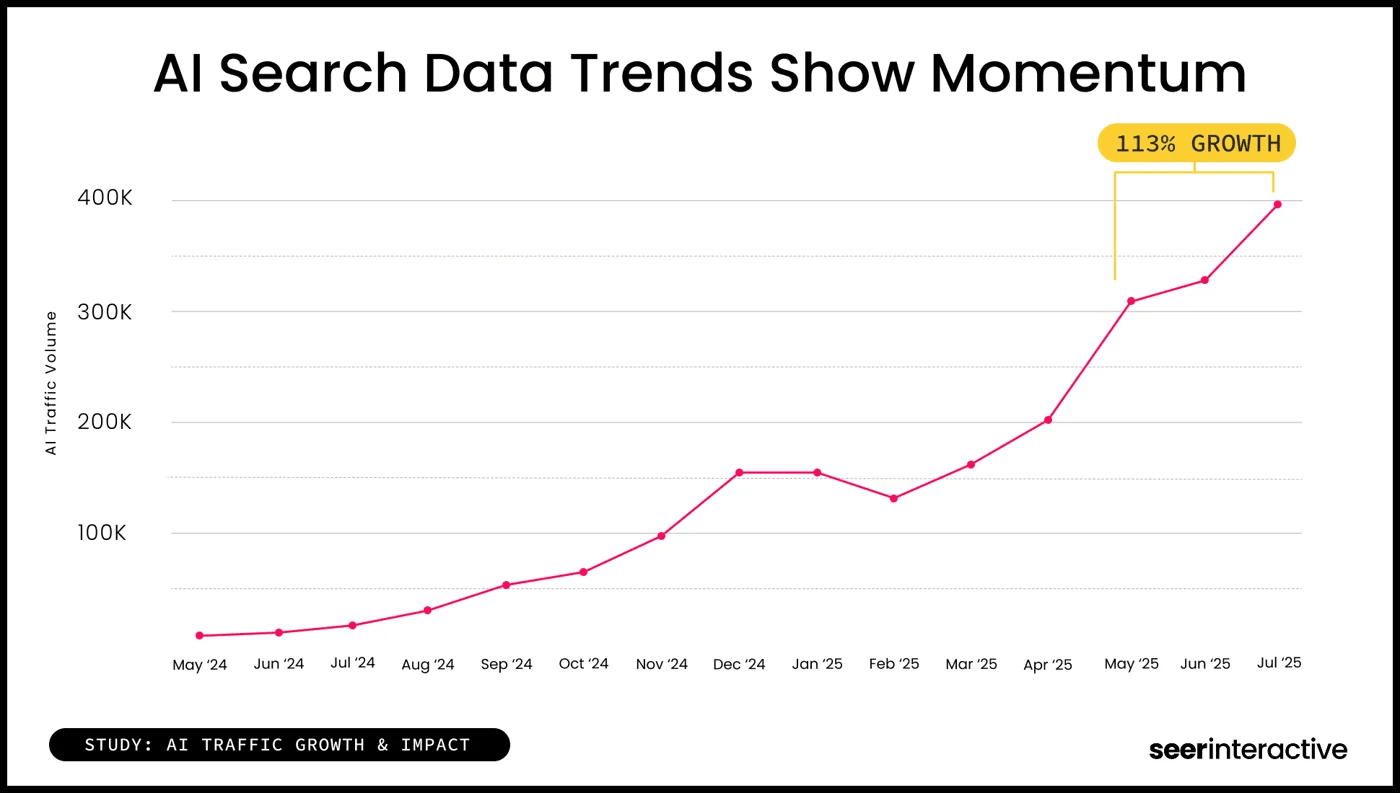
另一方面,Seer Interactive 的客户数据也显示,2025 年 5–7 月的 AI 导流相较此前三个月增长 113%。随着生成式 AI 的普及,AI 已经全方位压缩传统点击,同时正在形成新的、较高意图的导流来源和路径。
2.2 零点击常态化
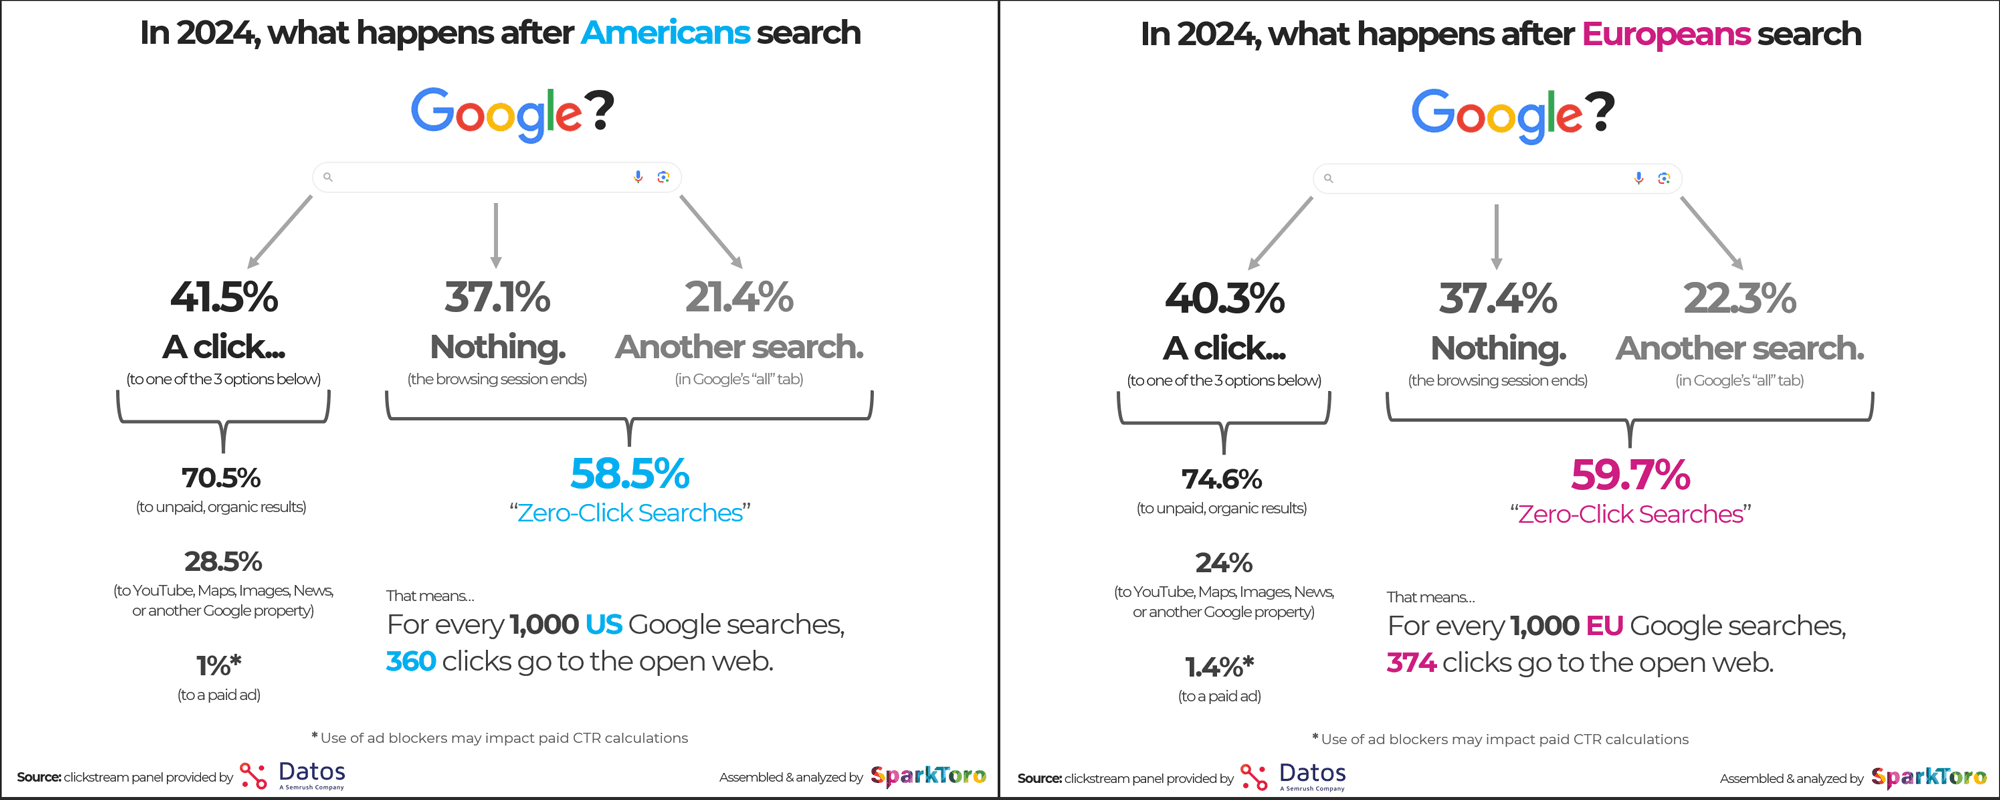
零点击其实并非生成式 AI 出现后才出现的现象。过去 Google 早已通过知识图谱、精选摘要等功能,让用户对信息的需求能直接在 SERP 被满足。
2024 年 SparkToro 与 Datos 的研究显示,美国约有 58.5% 的 Google 搜索没有产生任何点击,显示在生成式 AI 冲击搜索路径前,零点击早已是一种现象。
不过虽然精选摘要截断了搜索意图,但仍然会导流至蓝色链接当中,人们依旧能使用营销手段争夺第 0 位;但当搜索决策链从 SERP 转向 AI 应用内部的 AI SERP 后,传统的 SEO、SEM 等优化手段的价值或会受到冲击与价值重估。
伴随着 Google 于 2024 年 5 月在美国正式推出 AIO(AI Overviews),并于同年 10 月开始大规模向全球市场扩张,使“搜索 → 点击网站”不再是取得信息的必要路径
到了 2026 年,SparkToro 结合 Similarweb 数据更估计,美国 Google 搜索的零点击比例已升至 68.01%。这显示人们在 AIO 普及后,更加依赖生成式 AI 提供的信息,而非主动去深挖信息来源。当用户在 SERP 就获取到了想要的信息,进而直接结束搜索意图,于是促进了零点击增长曲线的上升。
2.3 AI Overviews 与 AI 搜索的路径差异
生成式 AI 对传统搜索决策链的影响,除了搜索结果页内嵌的 AI Overviews,还有对话式 AI 搜索的普及。
对话式 AI 搜索让用户可以持续追问;传统搜索结果页与对话界面因此有不同的站外点击路径。
AI Overviews:流量拦截
用户依然在 Google 搜索,但可能直接在概览中取得答案。
AI 搜索:入口替代
用户直接在对话界面提问,搜索引擎不再是唯一的起点。
Shi、Zhu 与 Gu(2026)实际分析 ChatGPT Search 上线前后的行为,发现人们在与 ChatGPT 的对话中仅 5.2% 产生可识别的站外推荐;同时,在人们获得 ChatGPT Search 权限后,传统搜索使用量平均下降了 9.4%,且 20 周后降幅更是估计扩大至 17.0%。
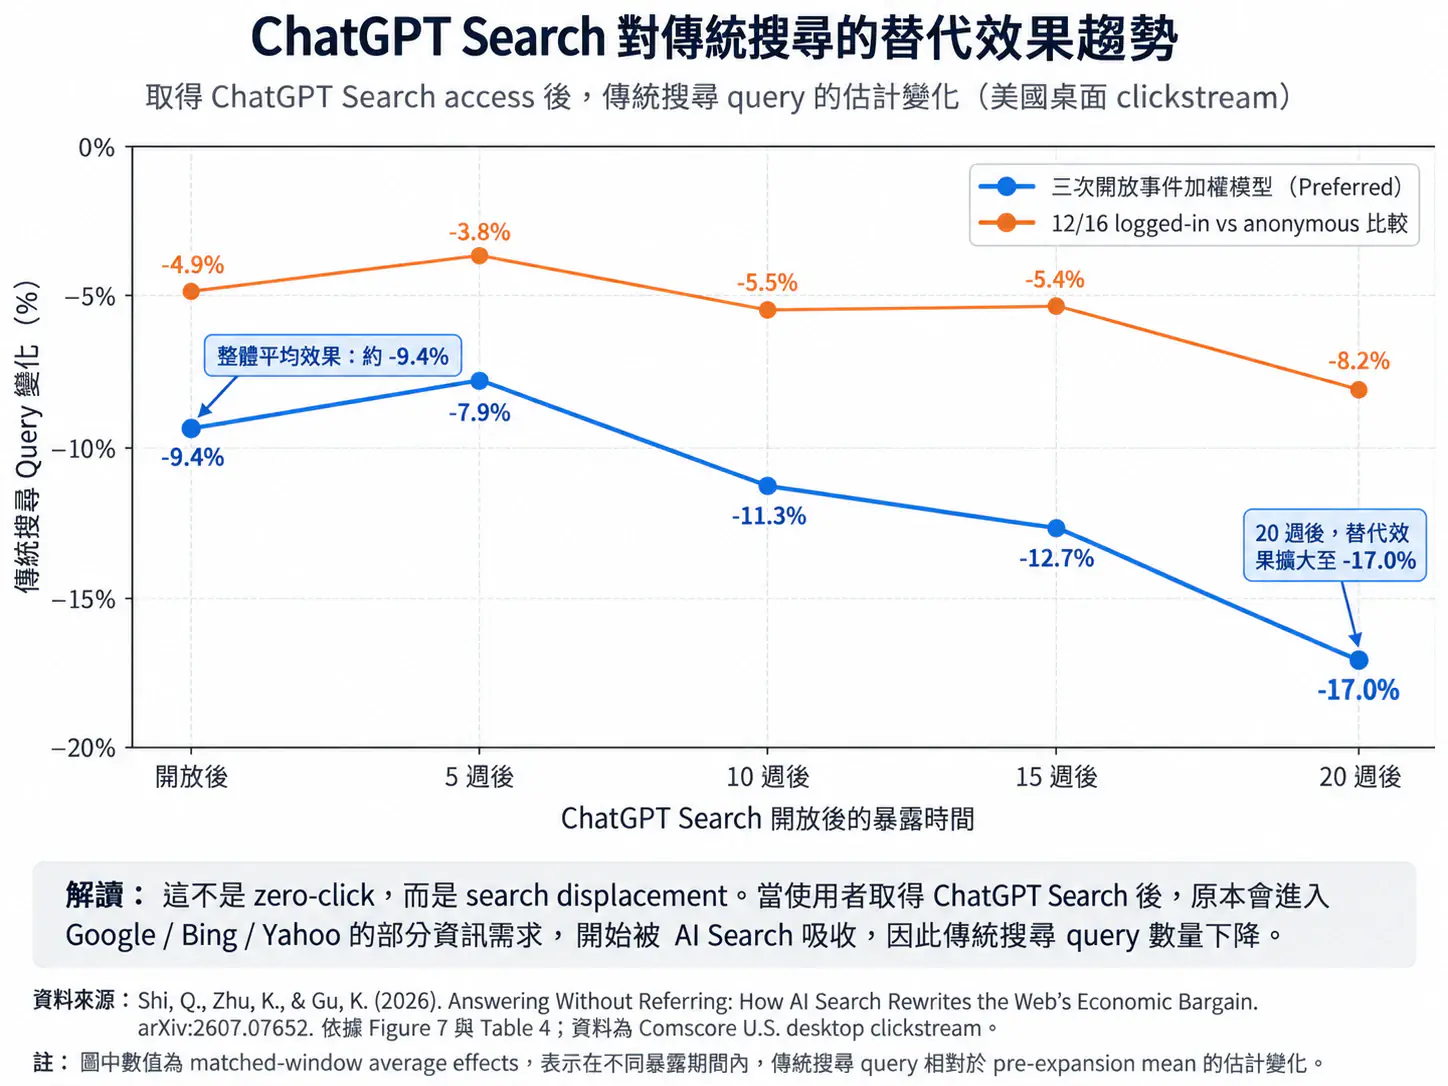
这些研究观察的是不同平台、不同分母下的行为,不能据此推算用户转向 AI 搜索的整体比例。
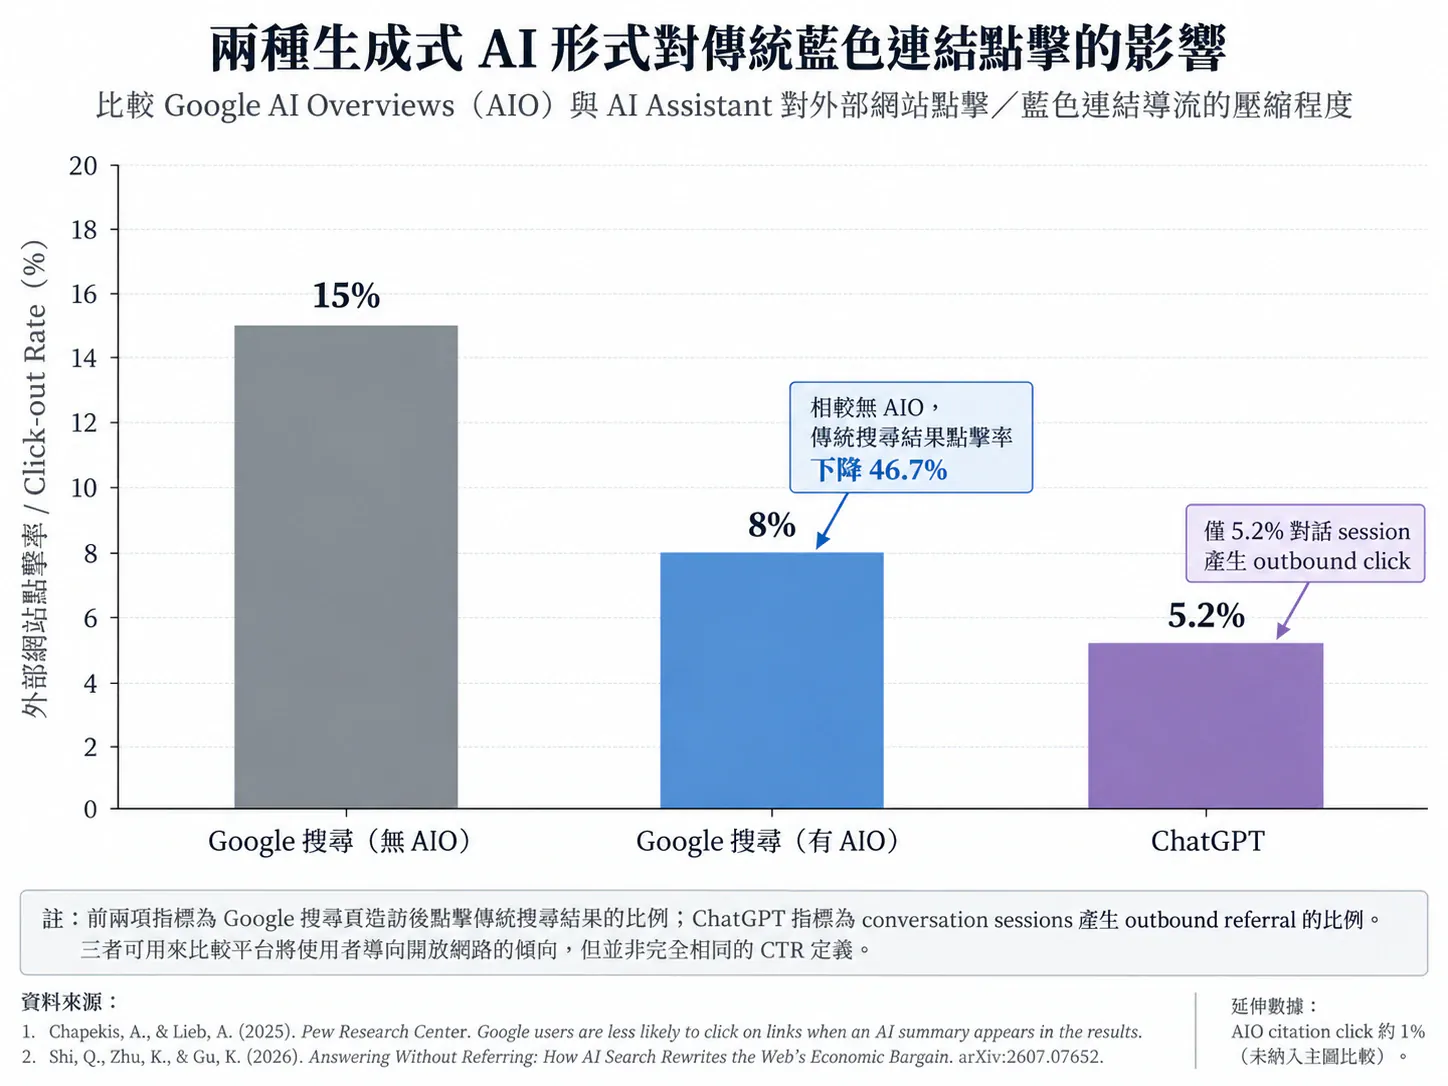
从搜索意图来看,AIO 是在既有搜索版图内进行“流量拦截(Traffic Interception)”,而 AI 应用则是更根本的“入口替代(Substitution Effect)”。
2.4 决策智能体化的影响预测
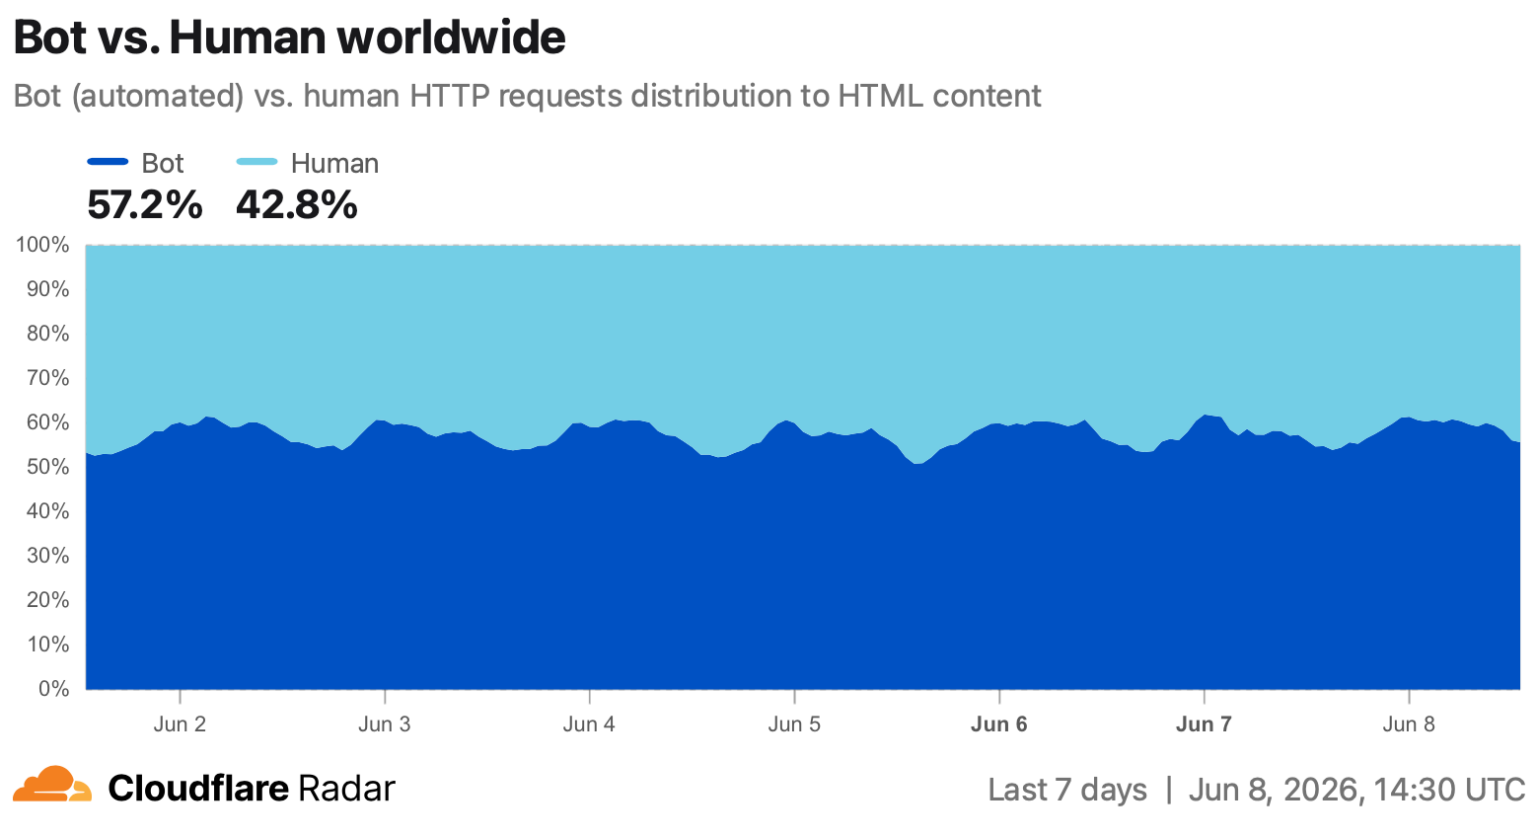
根据 CDN 服务商 Cloudflare 的 Radar 2026 年 6 月 8 日 HTML 请求图表,Bot 占 57.2%、Human 占 42.8%,机器人请求已超过人类。Cloudflare 首席执行官 Matthew Prince 于 6 月 3 日指出,这是机器人流量首次超越人类。
伴随着 AI Agent(AI 智能体)的技术逐渐完善,可预期的是人们将会把搜索决策链进一步简化为直接向智能体下达指令。届时 AI 不再只是回答用户的提问,而是会自主拆解复杂任务、跨平台调用工具、主动去访问网页。
HUMAN Security 2026 年的报告亦证实,由 AI 智能体与智能体浏览器产生的网络流量年增长率高达 7,851%,且高度集中于零售电商、视频媒体与旅游住宿等具有强交易属性的产业。
未来“用户是否亲自访问网站”与“品牌是否完成一次交易或联系”可能越来越分离,也迫使着企业与商家需重新评估网站的价值,因为对 AI 智能体来说,第一手信息来源,意味着高信任的数字锚点。
当搜索行为进一步演进,“决策智能体化”势必会让网站所扮演的角色出现变化。
三、AI 如何认识一家商家?官网的价值解析
前面的 2.4 节中提到,随着 AI 智能体的技术逐渐成熟,搜索决策链很可能再度被简化。因此,如何让 AI 准确地引用到官方网站,甚至直接从中提取信息作为答案的来源,便成为了重中之重。
3.1 AI 眼中的“数字实体”
在本文的分析框架中,一家餐厅不只对应一个 URL;名称、地址、电话、菜单、评论、新闻与社交平台页面等公开信息,共同构成可供核对的“数字实体”。
Google Business Profile(GBP)的官方说明即指出,商家信息可能来自公开网站、第三方授权数据、用户内容、商家提供内容,以及 Google 与该地点互动后取得的信息。
因此,没有独立官网不等于没有可被 AI 使用的数据。对一家经营多年的老店而言,大量探店笔记、媒体报道、地图评论与社交平台帖子,本身就可能形成非常厚的数字足迹。
当 AI 在回答“台北有什么老字号牛肉面?”时,便可利用这些数字足迹完成实体识别、特征整理,并进一步给出信息。
这也是“无官网商家仍会被 AI 提到”最重要的机制解释:它们不是没有数据,而是品牌数据分散在整个公开网络。
3.2 “数字锚点”的价值解析
前一节提到,一家店即使没有官网,也能通过第三方聚合留下足够多的数字足迹,让 AI 识别出数字实体。但这些数据毕竟分散在不同网站,菜单更新了,博主必然不会去做修改;分店搬迁了,Google 评论里仍可能留着旧地址。
商家可以更正部分平台数据,却无法统一维护所有人的描述,这也会造成数字足迹的紊乱。因此,“网络上有这家店的数据”与“这家店有一份自己能持续维护的官方说明”仍然是两回事。
LS-Labs 在本文将“官网”这种第一手信息来源称为“数字锚点”,指商家可自行更新、供外界核对信息的官方节点。
官网的价值并非否定数字足迹的价值,也非保证 AI 一定会采用官方提供的信息,而是让品牌有一个可持续更新的锚点作为来源。而这个锚点的用途,又可被分成三个层面。
品牌可以自行维护价格、分店、服务、菜单、FAQ、公告与品牌描述,让公开网络上存在一个能被追溯的官方版本。至少品牌拥有一个可更新、可核对、可长期维护的第一方节点。
电话与地图同样能承接消费者,但官网可以进一步打通订位、订购、询价、会员、CRM、分店选择与其他自有流程。对多分店、复杂服务、需要留资或线上交易的品牌而言价值极高。
品牌可以通过清晰的页面架构、LocalBusiness Schema、FAQ、产品数据与一致的实体命名,让信息更容易被搜索系统解析;同时,也能把站内事件、来源与后续转化回传到分析系统。这让品牌拥有更完整的“可读、可管、可量”数字资产。
3.3 为何要分开量测提及、引用与信息质量?
前两节说明了第三方数字足迹能让没有确认官网的商家进入 AI 回答;官网则提供商家可维护的数字锚点。但如果只统计“店名出现几次”,实际上无法分辨当前 AI 眼中的商家到底是什么样子。
AI 可能在某句回答中提到一家店时,引用探店笔记的比例大过官网;也可能虽列出了官网,但回答中附带的地址或电话却采用了第三方的过时来源。
这也是单一“GEO 分数”的局限:它可以概括能见度,却很难指出品牌是否有 AI 幻觉或信息来源的污染。
Semrush 2026 年针对多个 AI 搜索界面的研究,也观察到“引用”与“品牌提及”并不是同一事件:在其 3,981 次域名出现事件中,61.7% 为有来源链接但未提及品牌(幽灵引用),25.1% 为提及品牌但未附来源链接,只有 13.2% 同时出现品牌提及与来源链接。
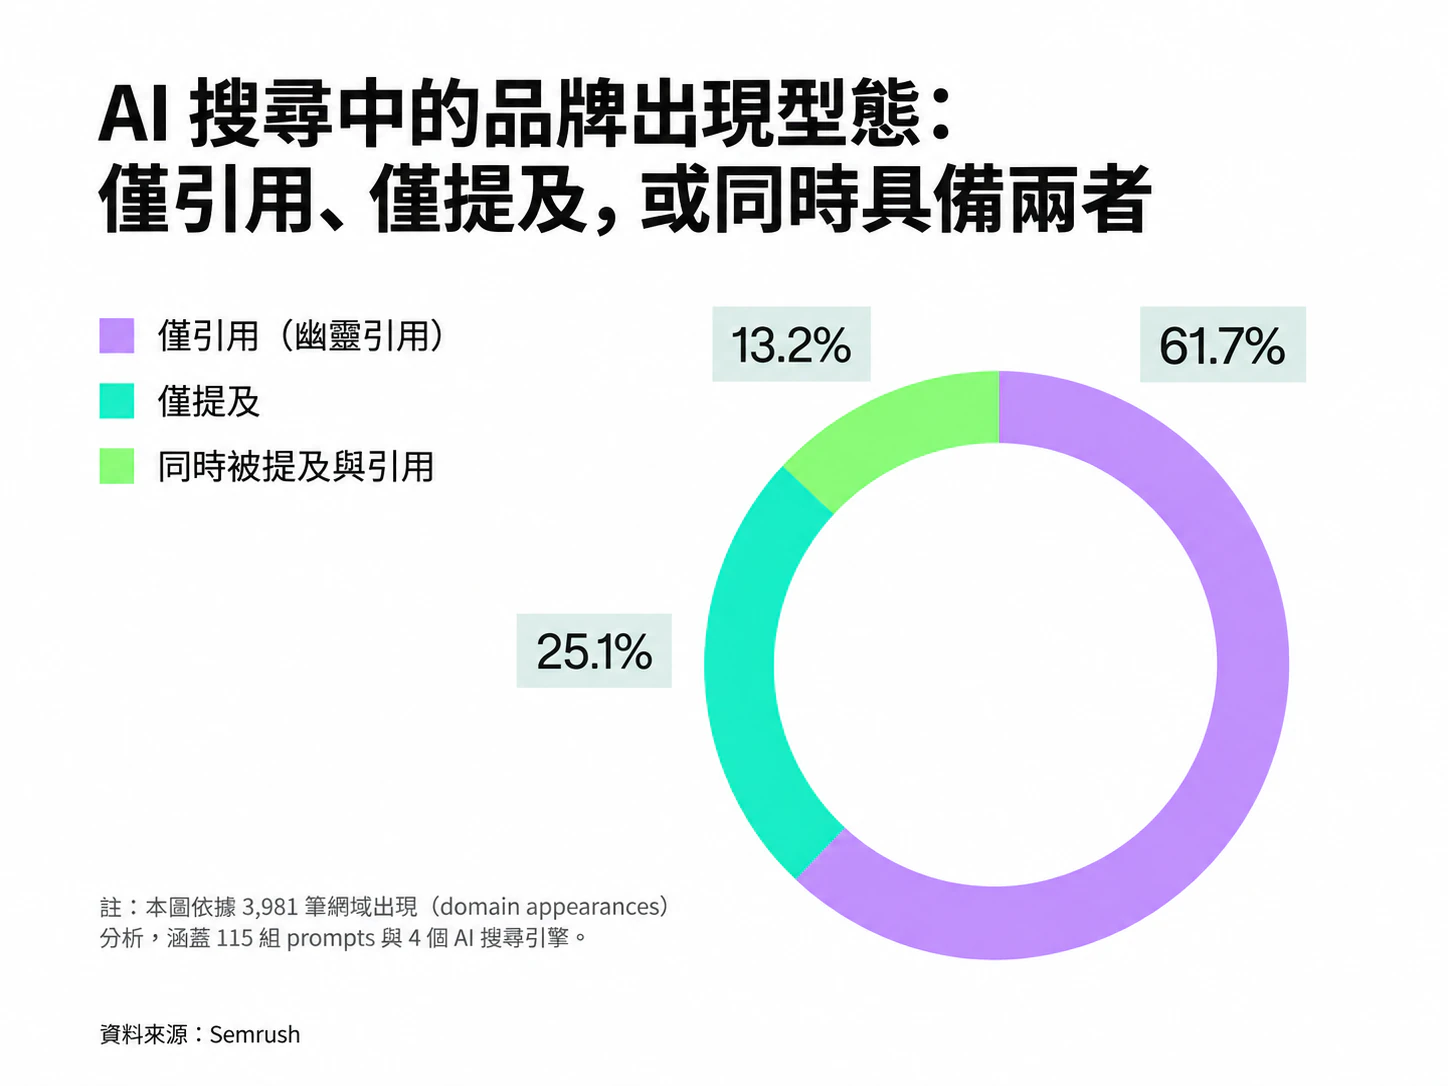
品牌被提及与网站被列为来源并非同一件事。
对本报告而言,更重要的是厘清:AI 到底有没有提到商家?用了哪些来源?基本信息是否与参照数据一致?回答是否提供了转化路径?
若这些信息,最后都只被压缩成一个单纯的“GEO Score”,品牌其实很难知道下一步该做内容、做 PR、修数据,还是改善 CTR。
为此,LS-Labs 将这个问题拆成 MCAC 模型,作为自我检测的框架。
四、LS-Labs 的 AI 搜索量测框架:MCAC 模型
4.1 MCAC:分开检查 AI 搜索中的品牌表现
本研究以 MCAC(Mention、Citation、Accuracy、Conversion-readiness)作为操作性框架,分别观察品牌提及、引用来源、信息正确性与回答提供的行动入口。原始观测将第四项记为 Actionability;公开框架改称 Conversion-readiness 以对应 MCAC 缩写,量测内容仍是回答提供的行动信息。实际转化仍需另行验证。
这四项诊断在 GEO 主题页以同一则餐厅回答示范,结合本报告的样本与方法,可以区分观察到的现象与尚待验证的改善假设。
Mention
是否在回答中被提及?在固定问题下,品牌是否进入 AI 回答正文与候选集合。
Citation
引用的来源为何?回答列出或使用哪些来源,来源由谁控制(第一方 vs 第三方)。
Accuracy
回答是否准确?可核对事实(地址、电话、价格等)是否与真值表一致。
Conversion-readiness
是否具备转化路径?回答是否能提供电话、网址、地址等能形成实际转化的路径。
表格可左右滚动,比较完整字段
| 维度 | 本文定义 | 核心问题 | 对品牌的意义 |
|---|---|---|---|
| M — Mention | 在固定问题下,品牌是否出现在 AI 回答中 | 是否在回答中被提及? | 衡量候选能见度与被召回能力 |
| C — Citation | 回答列出或使用哪些来源,来源由谁控制 | 引用的来源为何? | 看第一方、平台与第三方声量如何共同构成品牌叙事 |
| A — Accuracy | 可核对事实是否与品牌真值表一致 | 回答是否准确? | 找出地址、电话、分店、价格等信息漂移 |
| C — Conversion-readiness | 回答是否能提供电话、网址、地址等能形成实际转化的路径 | 是否具备转化路径? | 衡量曝光能否被承接为联系、导航、订位或交易 |
MCAC 的用途,在于让检查方向更具体:Mention 低,可检查主题关联;Citation 过度依赖第三方,可检查第一方信息是否可见;Accuracy 出错,须核对数据;Conversion-readiness 弱,表示回答缺少可采取的下一步。
4.2 实测设计:六家台北牛肉面店 × 四类问题
本研究于 2026 年 9 月 16 日,以台北市牛肉面商家进行小型目的性抽样。三家可确认自有官网,三家在本次查核中未确认独立自有域名。
表格可左右滚动,比较完整字段
| 分组 | 商家名称 | 分组依据 |
|---|---|---|
| 有确认自有官网 | 洪师父冠军牛肉面-建北店、天下三绝面食馆、牛店精炖牛肉面 | 可确认品牌控制的独立域名或正式门店页 |
| 未确认自有域名 | 林东芳牛肉面、富宏牛肉面、刘山东小吃店 | 本次查核仅确认 Google 商家、Facebook 或第三方页面 |
实测方法
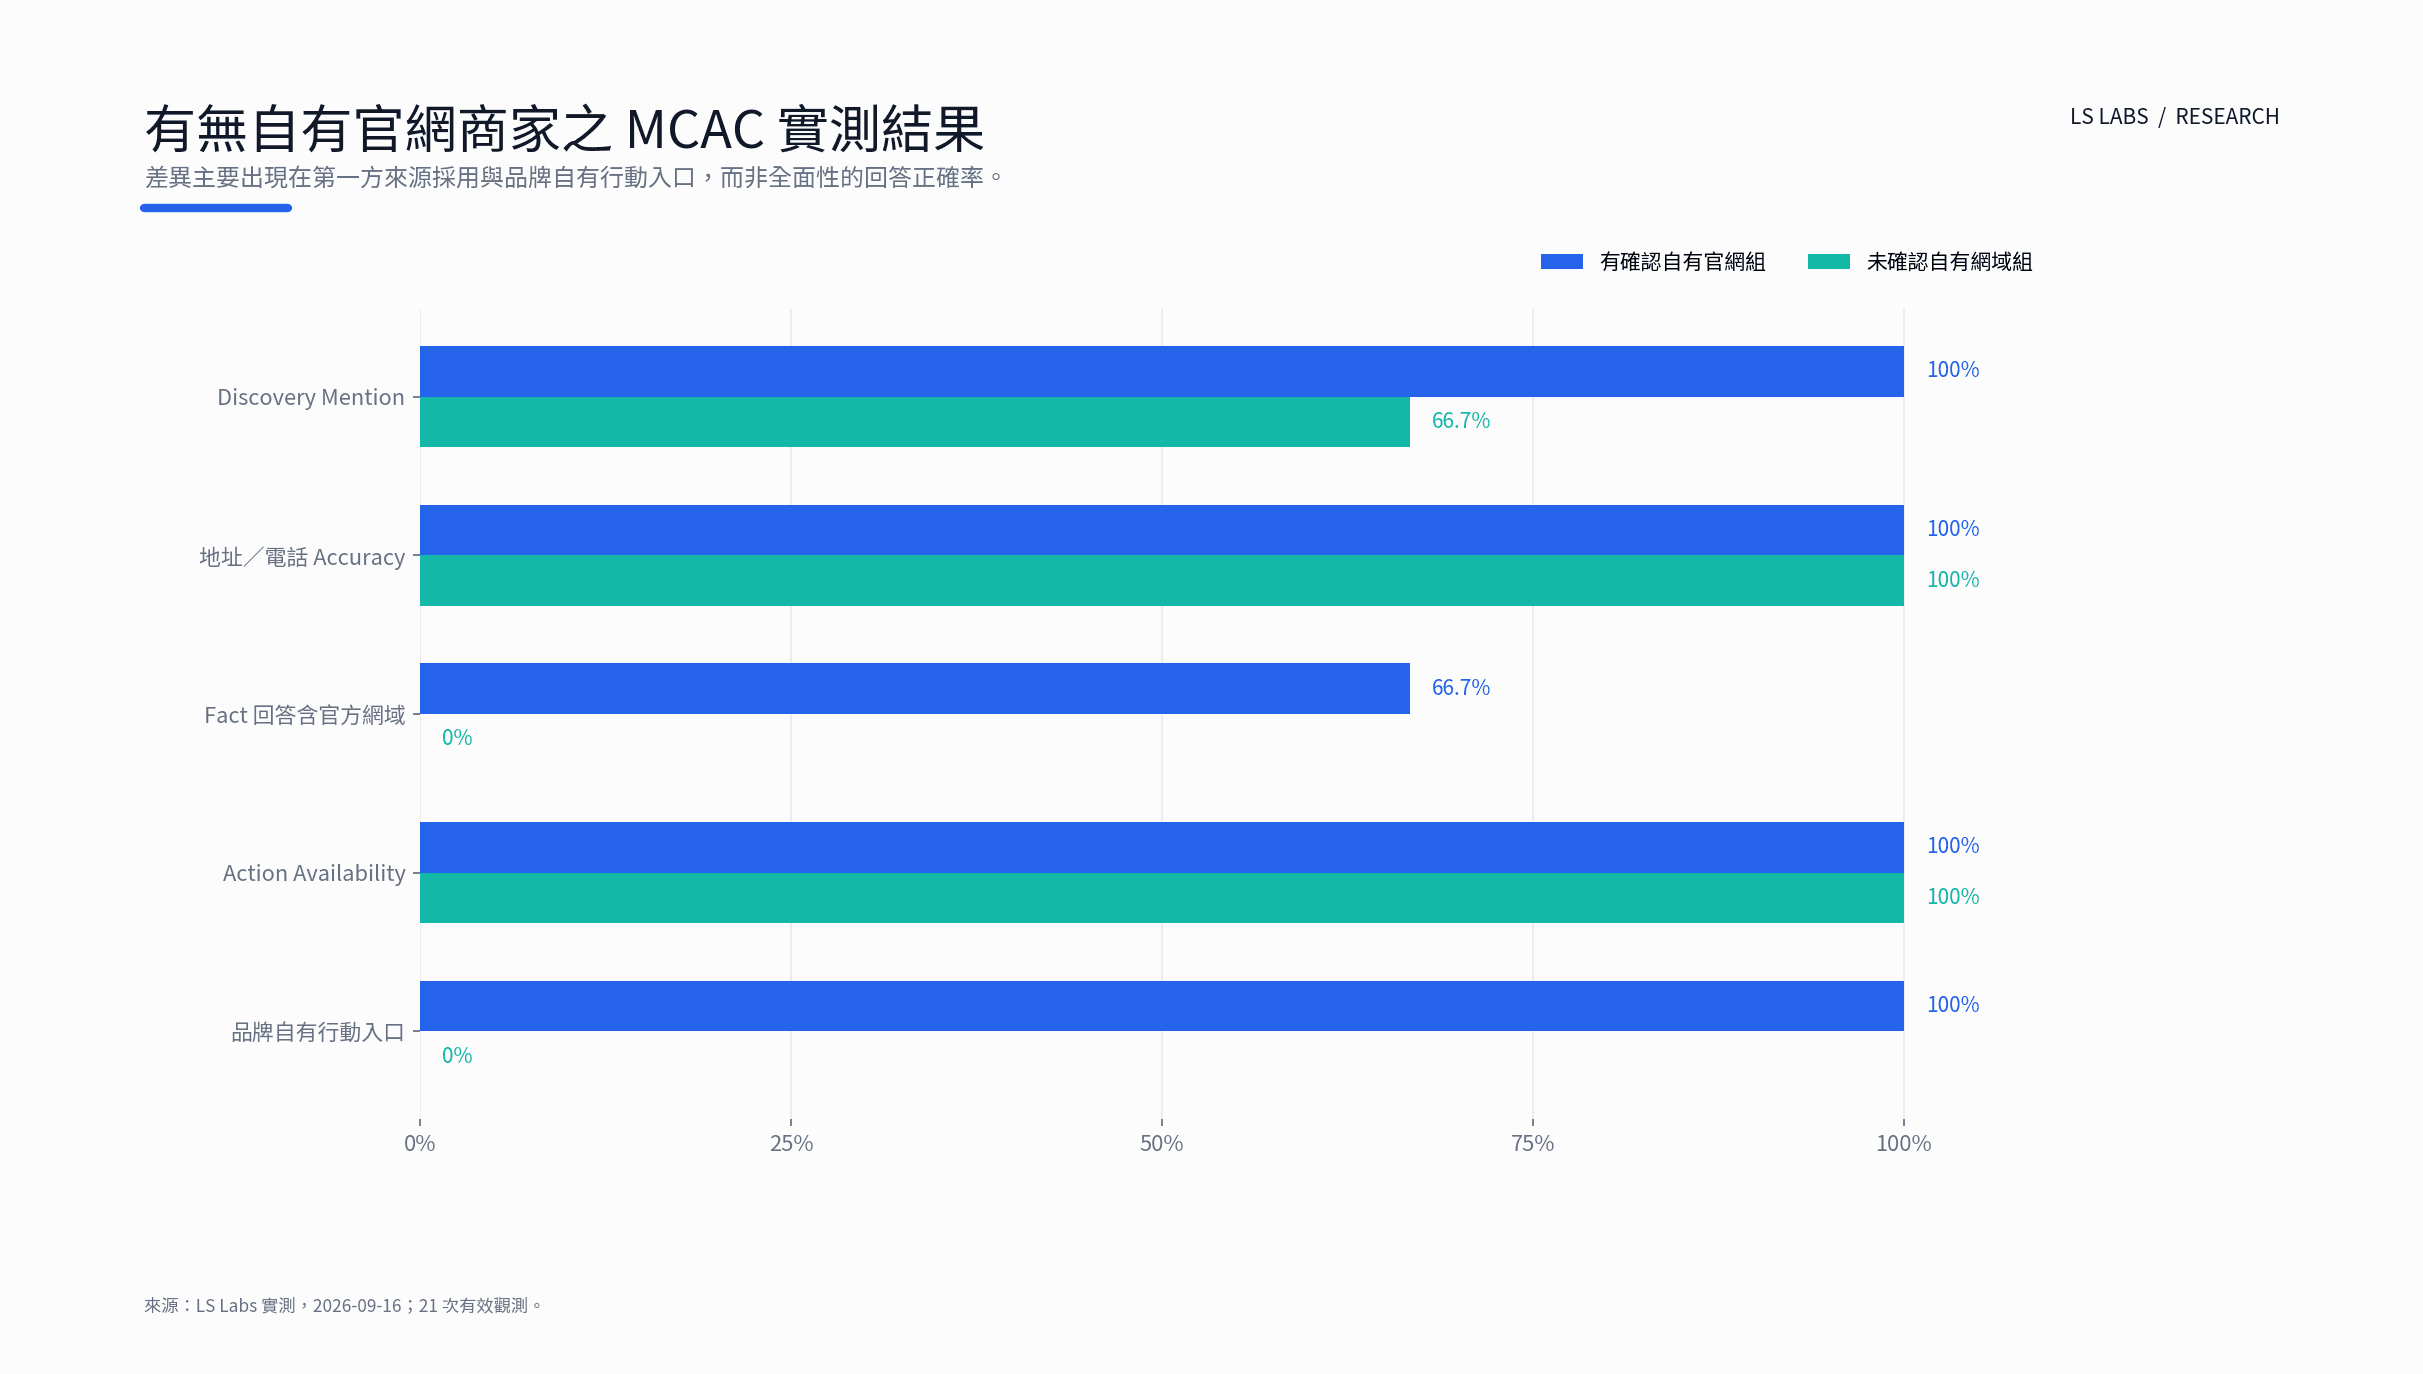
数据收集使用 Perplexity Sonar API,语境固定为台北、繁体中文,并保存回答、citations 与 search_results。原始共 24 次调用,其中 3 次因样本重新分类于统计前排除,最终纳入 21 次有效观测:3 次 Discovery Query、6 次 Fact Query、6 次 Action Query,以及 6 次正反序 Comparison Query。
4.3 实测结果:官网能有效提供第一方数字锚点,不过并非垄断 AI 能见度
| MCAC 观测维度 | 有确认自有官网组 | 未确认自有域名组 | 营销实务解读 |
|---|---|---|---|
| Mention:Discovery 留存回答中的品牌出现 | 9/9品牌×执行记录 | 6/9品牌×执行记录 | 无官网商家仍能稳定进入部分推荐回答,官网不是被 AI 看见的必要条件 |
| Citation:Fact 回答来源清单含样本官方域名 | 2/3 | 0/3 | 官网增加第一方来源进入回答的机会,但不保证每次被采用 |
| Accuracy:地址、电话与参照表一致 | 6/6 | 6/6 | 基本本地信息可由多来源支撑,本轮两组没有出现差异 |
| Conversion-readiness:有基本行动信息 | 3/3 | 3/3 | 电话、地址本身就能承接行动,没有官网不等于没有下一步 |
| Conversion-readiness:正文列出登记的官方网址 | 3/3 | 0/3 | 官网组多了一个可由品牌维护的第一方落点 |
这组实测结果最值得注意的是,不同 MCAC 维度在结果上带来了完全不同视角的观点解析。在能见度上,第三方足迹已经可以把没有独立官网的老店带进回答;在基本事实上,两组都能答对地址与电话;到了来源与落点,官网的价值才真正出现。
4.4 Citation 重析:AI 的来源池远比品牌官网更分散
对 21 条有效记录重新计数,共得到 408 个 citations 清单项目、206 个按原始 URL 字符串去重的网址,以及 112 个移除 www. 后的主机名。三家样本商家的登记官方域名,在全量数据中共对应 6 个去重网址,占 206 个去重网址的 2.91%;若以 citations 清单项目计算,官方来源为 10/408,占 2.45%。
表格可左右滚动,比较完整字段
| 题型 (Query Type) | 有效回答数 | citations 项目数 | 题型内去重网址 | 样本官方网址项目 |
|---|---|---|---|---|
| Discovery(推荐题) | 3 | 60 | 20 | 0 |
| Fact(事实题) | 6 | 116 | 114 | 2 |
| Action(行动题) | 6 | 119 | 118 | 6 |
| Comparison(比较题) | 6 | 113 | 111 | 2 |
| 全体合计 | 21 | 408 | 206 | 10 |
这个结果不应被读成“AI 只信任官网 2.91%”,因为来源清单的出现次数不是信任权重;但它很清楚地呈现了一个搜索现实:生成式搜索的答案来源是多源的,品牌官网只是整个信息生态的一部分。
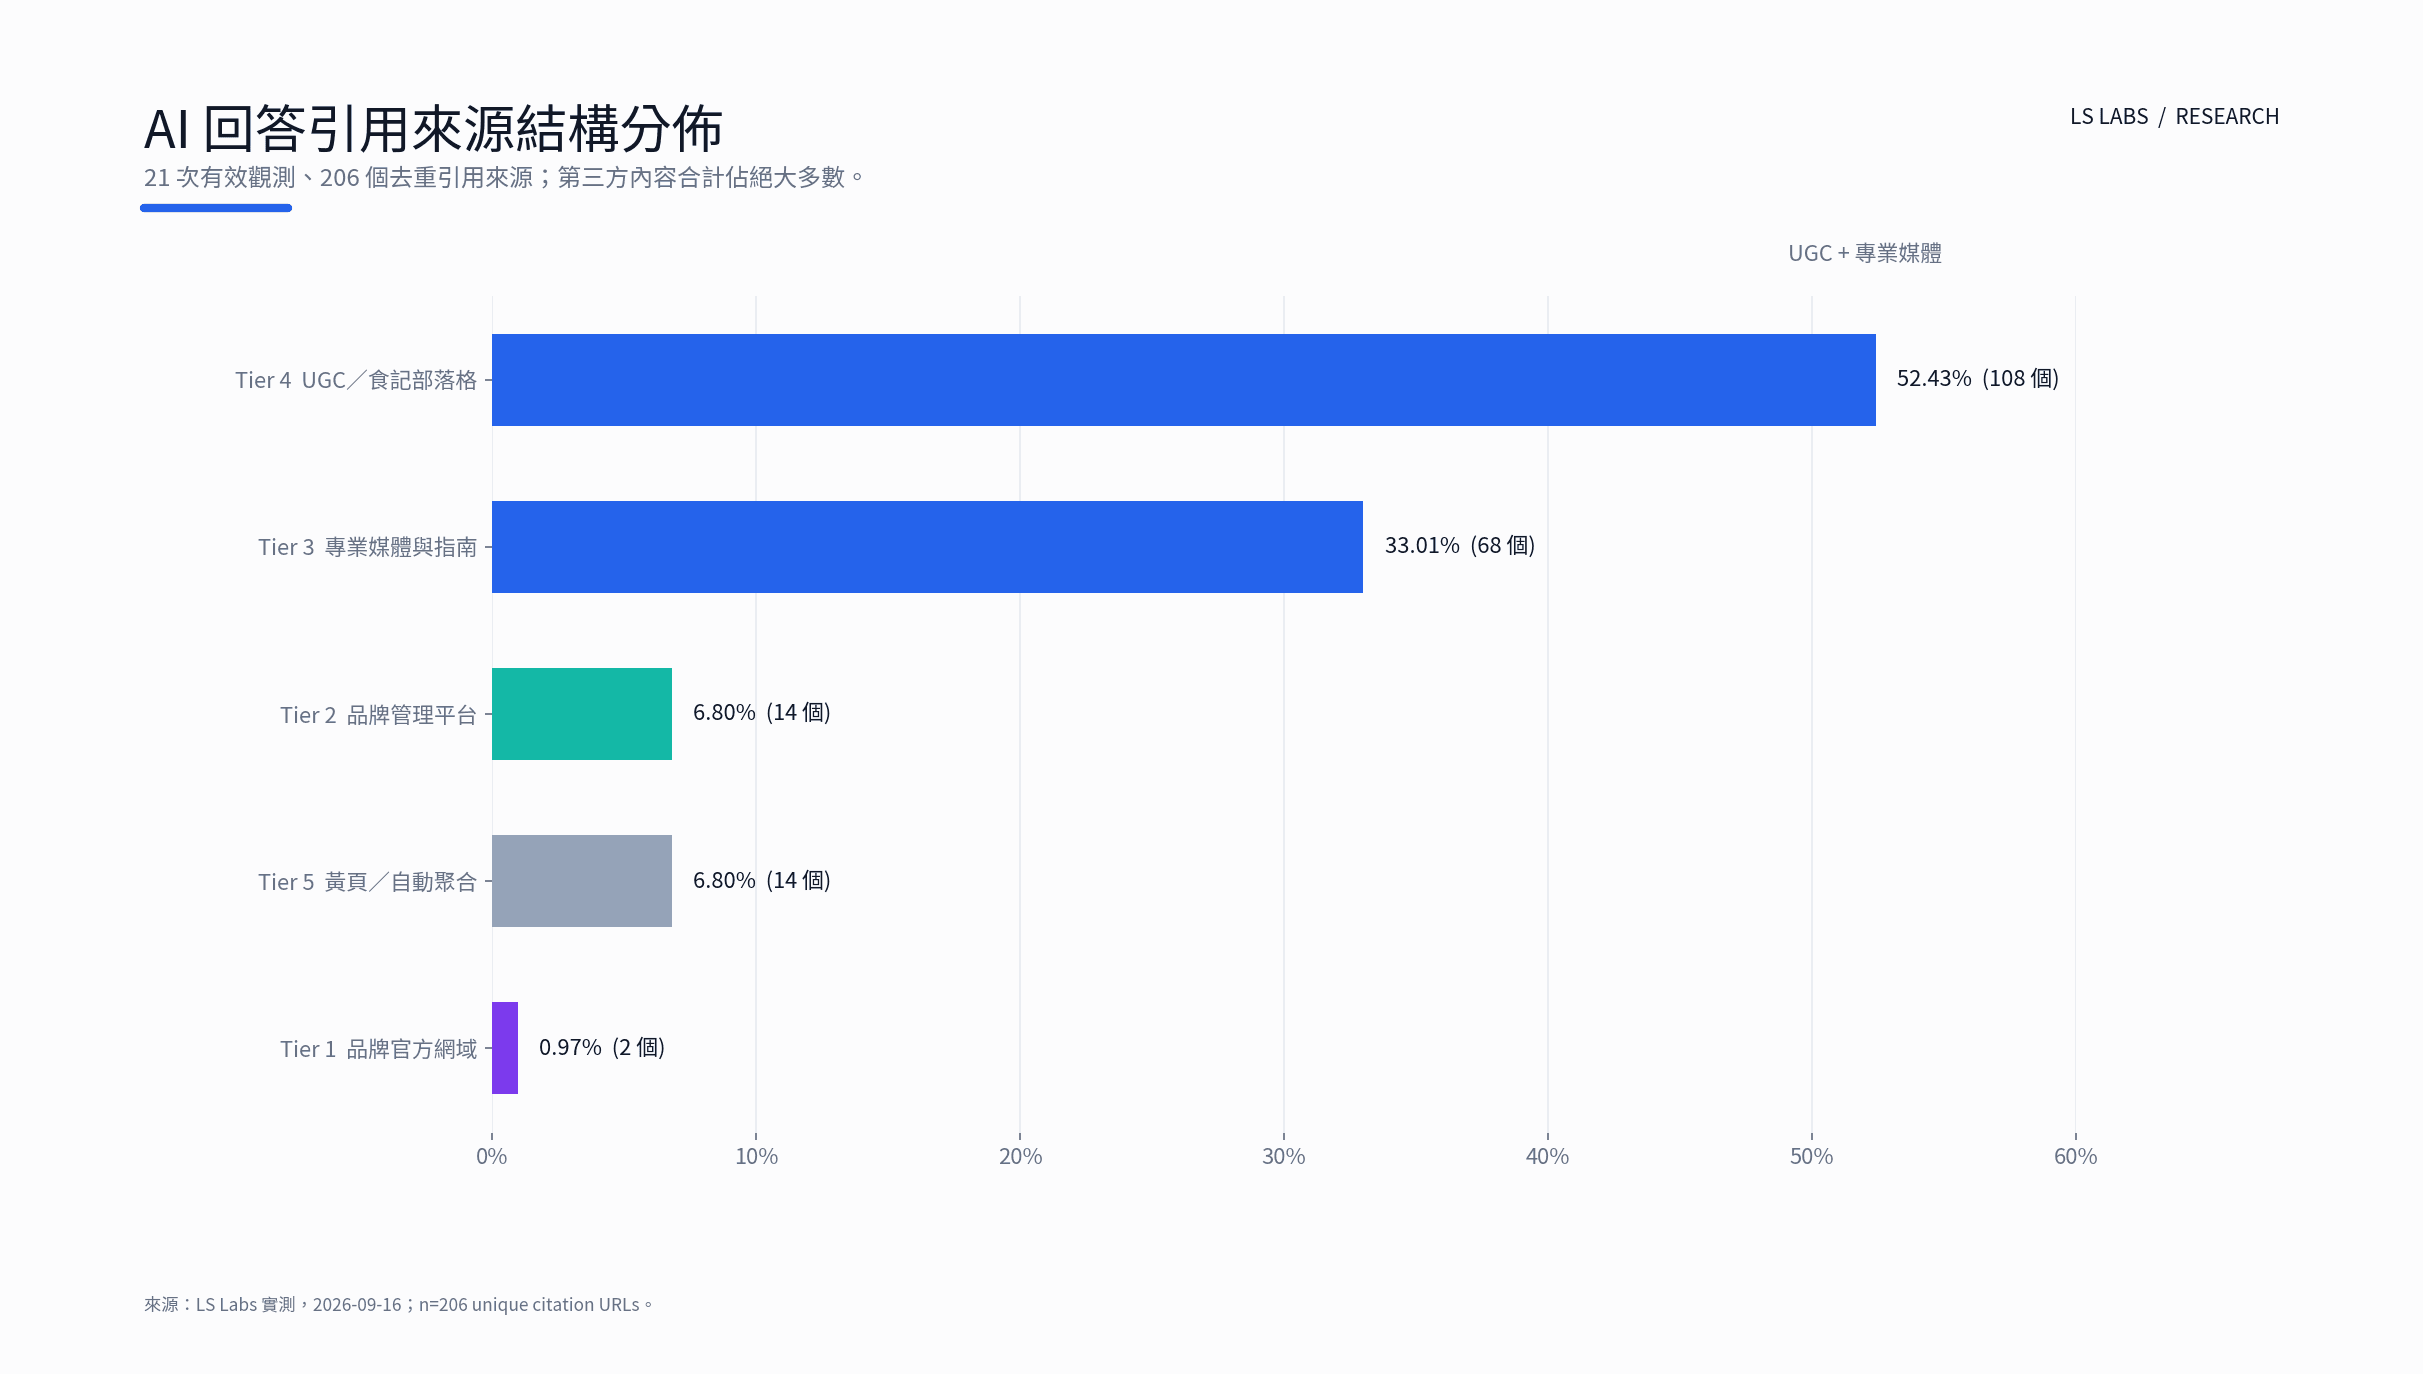
对品牌而言,这反而说明 GEO 不应只做站内 SEO。真正的 AI 可见度来自一个混合结构:第一方官网负责标准答案与承接,Google Business Profile 等可管理平台负责本地实体信息,媒体与专业内容提供权威背书,UGC 与评论则补充口碑与情境语义。这些来源并非相互取代,反而是形成类似合作的关系,共同构筑出 AI 眼中的品牌实体。
4.5 Comparison 压力测试:MCAC 也能检查量测本身
本轮双店比较题出现一个很有价值的现象:正序与反序测试中,第一顺位商家 6/6 都能取得地址与电话,第二顺位则 0/6 完整;顺序翻转后,缺漏也跟着翻转。
这个结果最大的价值,不是证明某一个模型“有位置偏差”,而是提醒 GEO 量测不能只跑一次、只看一种 Prompt。若原始测试没有做反序校准,很容易把“第一顺位比较完整”误读成“有官网商家表现更好”。
对 MCAC 而言,这让框架多了一层用途:它不只衡量品牌,也能检查量测设计。未来实务上可通过重复执行、Prompt 顺序平衡、跨模型观测与时间序列,把一次性的 AI 回答转成更稳定的品牌监测数据。
五、结论:AI 搜索时代,单一维度的 GEO Score 可能造成量测偏差
本报告从“没有官网的老店,为什么还是能被 AI 推荐?”这样一个看似矛盾的观点出发,实际深入探究 AI 眼中品牌形象是如何被组成,最终得出“AI 认识的是商家在整个公开网络留下的实体信号,也就是本研究所谓的 数字足迹”,Google 商家、媒体、探店笔记、社交平台与评论,足以让一个品牌被识别、描述与推荐。
然而实测也发现,官网真正的价值在于塑造一个可持续更新的 数字锚点,让品牌能在多源的搜索环境当中,建立一个由第一方主动控制的信息来源。它让品牌拥有一个可维护的公开版本、一个可被引用的官方落点,以及一个能承接订位、订购、询价、会员与其他商业流程的入口,并不能只从 能不能被 AI 推荐 这样浅薄的理由忽视官网的价值。
对小型本地商家而言,如果主要需求只有名称、地址、电话与现场到店,Google Business Profile、社交平台与第三方平台可能已经承担大部分功能;但当品牌开始面对多分店、服务条件、内容叙事、订位订购、CRM、数据归因与跨平台一致性时,官网的边际价值会明显提高。
在 206 个去重引用网址中,样本商家的登记官方网址有 6 个,占 2.91%。这个比例描述的是本次回答列出的来源构成,不是 AI 对官网的信任分数。品牌若只整理站内内容,仍无法处理分散在公开平台上的过时信息与第三方描述;反过来说,只累积第三方声量,也无法取代一份可持续维护的官方版本。
因此,本报告不把 GEO 压成单一排名分数。反而提出 MCAC 框架分别检查四件事:AI 有没有提到品牌、根据哪些来源描述品牌、基本事实是否正确,以及回答有没有提供可转化的路径。四者呈现的不同维度,正好对应营销的四个价值。本次研究也显示,商家出现在问题中的先后顺序会影响信息完整度;只测一次、只看店名有没有出现,甚至可能把提问方式造成的差异误判成品牌表现。
当搜索从蓝色链接走向生成式答案,真正值得被监测的,不只是曝光,而是品牌在答案形成前就具备足够多的 正确信息。同时,GEO 监测也不应只是告诉品牌“你有没有被提到”,而应该持续回答品牌在 AI 决策链中的位置、来源、正确性与转化能力,这也正是 LS-Labs 持续想要传递的价值。
最后,以上建议仅代表本次案例研究提出的决策方向,而非对所有商家建站效益的因果估计。
数据可用性与研究披露
数据可用性:本页提供研究方法、样本范围与统计结果。原始 API 记录、参照表与分析文件目前未公开提供下载,因此本页不等于已提供可独立重算的公开数据集。数据访问问题可通过联系入口询问。
利益关系:作者同时参与 LS-Labs 的研究与工具开发,相关经验可能影响研究问题、工具选择与诠释。现有研究记录未提供完整的外部赞助或资助声明,不能据此宣称没有利益关系。
AI 协作:研究修订记录载明使用 AI 协助文献检索、程序重算、证据比对与语言编辑。AI 辅助不代表来源已逐项人工查证,也不代表经过外部同行评审。
学术预印本:本研究的学术版已于 2026-10-30 发布于 Zenodo,提供英文与繁体中文 PDF。引用格式:LI-Sheng(李昇)(2026)。Retrieval Mechanisms of Local Businesses in the Generative Search Era: Third-Party Footprints, First-Party Anchors, and the MCAC Empirical Evaluation Framework(预印本)。Zenodo。https://doi.org/10.5281/zenodo.23773956
参考文献
- Aggarwal, P., Murahari, V., Rajpurohit, T., Kalyan, A., Narasimhan, K., & Deshpande, A. (2024). GEO: Generative engine optimization. Proceedings of the 30th ACM SIGKDD Conference on Knowledge Discovery and Data Mining. https://arxiv.org/abs/2311.09735
- Chapekis, A., & Lieb, A. (2025). Google users are less likely to click on links when an AI summary appears in the results. Pew Research Center. 线上报告
- Fishkin, R. (2024). 2024 Zero-Click Search Study. SparkToro & Datos. SparkToro 报告
- Fishkin, R. (2026). In 2026, less than one third of Google searches still send a click. SparkToro / Similarweb. SparkToro 2026 分析
- Gao, T., Yen, H., Yu, J., & Chen, D. (2023). Enabling large language models to generate text with citations. EMNLP 2023. https://arxiv.org/abs/2305.14627
- Google. (n.d.). AI features and your website. Google Search Central. 查阅日期:2026-09-26. 官方说明
- Google. (n.d.). Google’s guide to optimizing for generative AI features on Google Search. Google Search Central. 查阅日期:2026-09-17. 官方指南
- Google. (n.d.). Grounding with Google Maps. Google AI for Developers. 查阅日期:2026-09-26. 开发者文档
- Google. (n.d.). Local business structured data. Google Search Central. 查阅日期:2026-09-17. Schema 规范
- Google. (n.d.). Understand how Google sources & uses info in Business Profiles & local search results. Google Business Profile Help. 查阅日期:2026-09-26. 帮助中心
- HUMAN Security. (2026). 2026 State of AI Traffic & Cyberthreat Benchmark Report. HUMAN Security 白皮书
- Lewis, P., Perez, E., Piktus, A., Petroni, F., Karpukhin, V., Goyal, N., Küttler, H., Lewis, M., Yih, W., Rocktäschel, T., Riedel, S., & Kiela, D. (2020). Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks. NeurIPS 2020. https://arxiv.org/abs/2005.11401
- Liu, N. F., Zhang, T., & Liang, P. (2023). Evaluating Verifiability in Generative Search Engines. Findings of EMNLP 2023. https://arxiv.org/abs/2304.09848
- Loktionova, M. (2026). Why 62% of AI citations don’t lead to brand mentions [Study]. Semrush. Semrush 研究
- McDonald, T., Scharf, A., & Williams, M. (2025). The AI search landscape, beyond the SEO vs GEO hype. Seer Interactive. Seer 研究分析
- Murphy, R. (2026). Local Consumer Review Survey 2026. BrightLocal. BrightLocal 调查
- OpenAI. (n.d.). Searching the web with ChatGPT. 查阅日期:2026-09-17. OpenAI 发布说明
- Perplexity. (n.d.). Create Chat Completion — Sonar API. 查阅日期:2026-09-26. API 文档
- Schulte, J., Bleeker, M., & Kaufmann, P. (2026). Don’t Measure Once: Measuring Visibility in AI Search (GEO). arXiv preprint. https://arxiv.org/abs/2604.07585
- Shi, Q., Zhu, K., & Gu, K. (2026). Answering Without Referring: How AI Search Rewrites the Web’s Economic Bargain. arXiv preprint. https://arxiv.org/abs/2607.07652
- Wang, S. T., Gleason, J., Bart, Y., Wilson, C., & Metaxa, D. (2026). AI in Search Reduces Publisher Referrals Without Improving User Experience: Experimental Evidence. arXiv preprint. https://arxiv.org/abs/2603.14589
- 财团法人台湾网络信息中心(2025)。2025 台湾网络报告。https://report.twnic.tw/2025/