文章目录文章开头0%
过去谈到生成式引擎优化(GEO),许多品牌最关心的,是如何让网站被 ChatGPT 引用,或让产品出现在 AI 的推荐列表中。
但如果 ChatGPT 一边推荐产品,一边提醒用户“这份排名并未经过独立验证”,品牌虽然获得曝光,用户又会如何理解这份推荐?
10 月 14 日,Peec AI 的 GEO 研究员 David Konitzny 在 LinkedIn 分享,他们分析了近 300 万条引用列表文或比较页的 ChatGPT 对话,发现 GPT-6 成为默认模型后,回答中提醒用户注意排名可信度、厂商自报数据的情况增加。几天后,SEO 专家 Lily Ray 也分享了类似观察。
这是否代表 ChatGPT 改变了对品牌内容的评估方式?对于依靠排名文、比较文章及第三方推荐获得 AI 曝光的品牌,又有哪些值得注意的变化?
GPT-6 上线后,ChatGPT 对排名与比较内容的提醒增加
Konitzny 观察的并非所有 ChatGPT 对话,而是近 300 万条至少引用一篇列表文或比较页的对话。他将相关提醒分为两类,比较 GPT-6 成为默认模型前后的出现比例。
| 提醒类型 | 切换前 | 切换后 | 切换后约为原来的 |
|---|---|---|---|
| 排名或比较未经独立验证 | 0.56% | 3.46% | 6.2 倍 |
| 厂商自报数据缺乏独立验证 | 1.01% | 2.27% | 2.2 倍 |
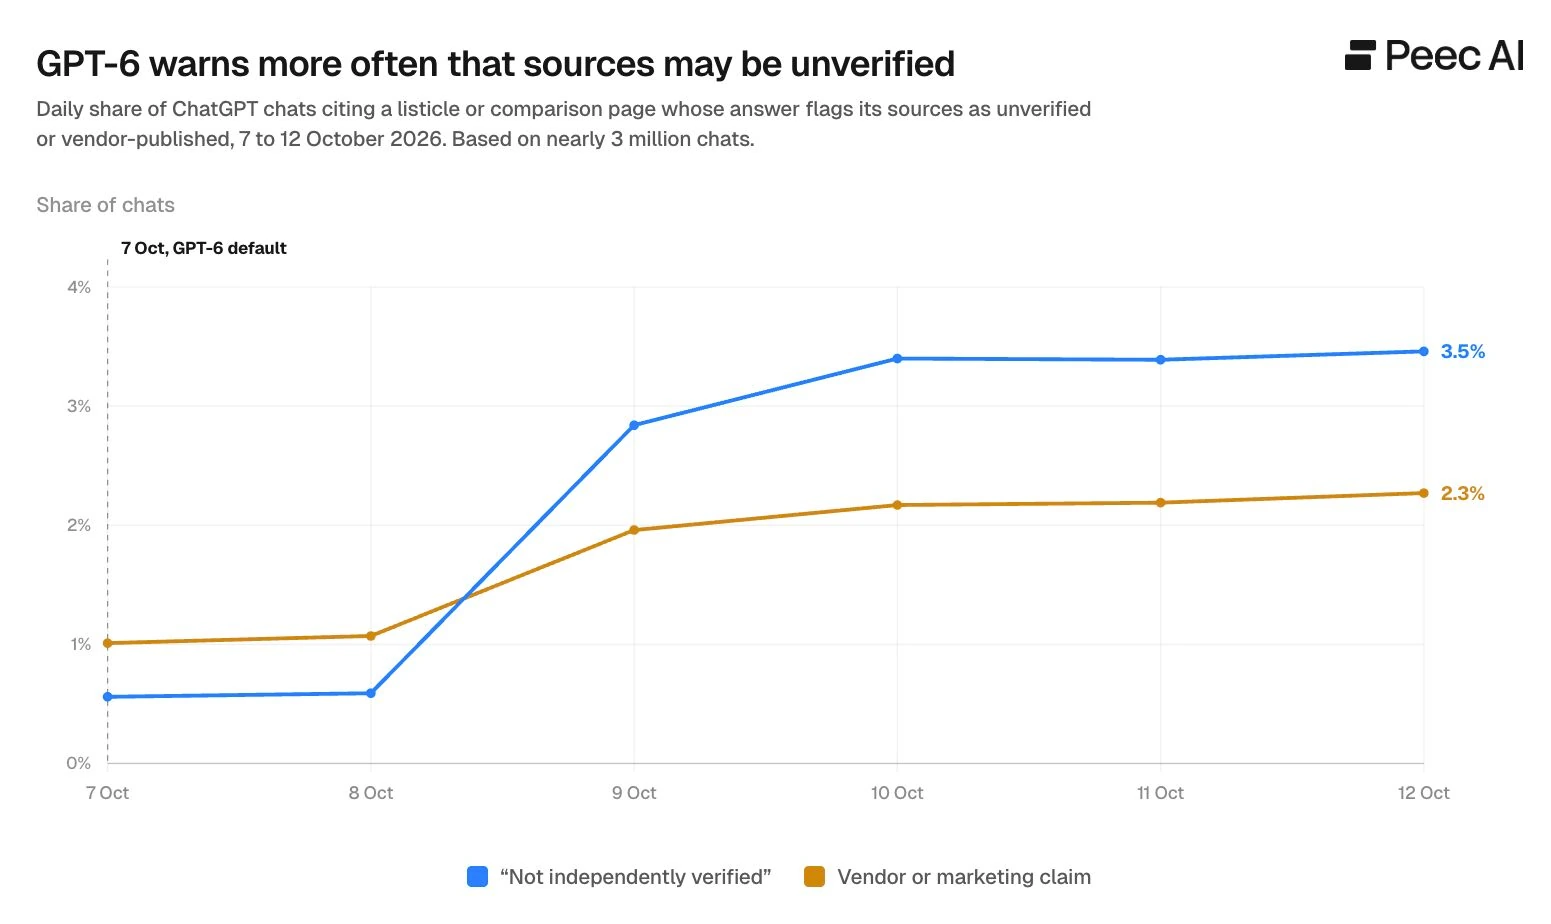
第一类提醒针对排名、推荐列表与产品比较。例如,ChatGPT 引用营销代理商排行榜时,可能指出排名未经独立验证,其中多数信息来自代理商本身。
第二类关注企业自行公布的准确率、客户案例或产品性能。如果比较主要依据厂商提供的数据,ChatGPT 可能提醒读者,这些数据未经第三方测试。
Konitzny 表示,两类提醒都在模型切换后两天内增加,之后维持在相近水平。不过,这类提醒并非 GPT-6 才出现,切换前就已有一定比例;近期观察到的是频率增加。
提醒增加也不代表列表文失去价值。他在 10 月 9 日的另一份观察中指出,列表文在 ChatGPT 引用网址中的占比,反而从 6.45% 上升至 9.70%。
这里的 6.45% 与 9.70% 是引用网址的组成比例,与表格中的提醒对话比例不同。在这些监测样本中,ChatGPT 仍会引用列表文,有时则进一步提醒用户,内容包含尚未验证的主张。
Lily Ray 的观察:AI 提醒推荐内容背后的商业关系
10 月 19 日,Lily Ray 在 X 分享,她通过 Peec AI 追踪一组 B2B 软件问题,在过去一周约 700 条 ChatGPT 回答中,有 82 条出现不同形式的提醒。其中,19 条特别提醒用户注意排名与评论内容的撰写者或来源。
提醒包括厂商在自家比较页替自己排名、评论网站与被评论品牌存在关系、付费评论与赞助位,以及某些推荐可能主要是为了推广联盟营销链接。部分回答也会说明,ChatGPT 自己的推荐列表未经独立测试,或提醒用户留意 Reddit 讨论的赞助关系与客观性。
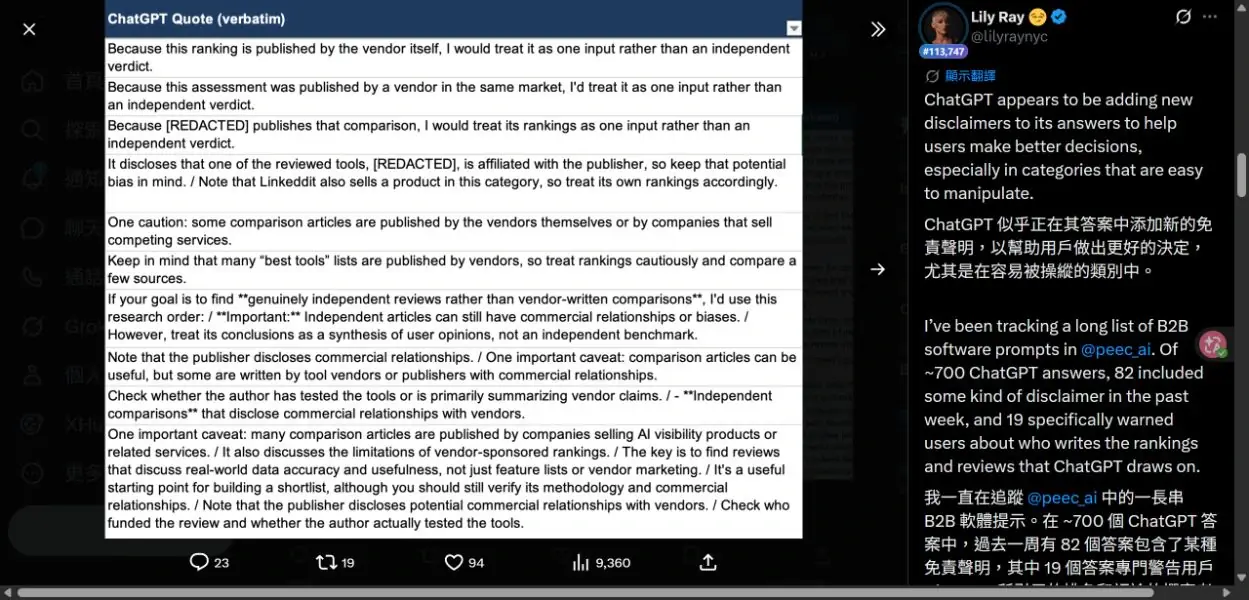
这些并非新问题。Lily Ray 对照传统搜索指出,搜索引擎长期通过排名系统、评论质量评估与垃圾内容政策处理相关内容,而这些判断通常发生在用户看不见的地方。
值得观察的差异是,当 AI 在推荐产品时直接说明来源可能存在的利益关系,这些疑虑便可能成为回答的一部分。
不过,这份观察集中在 B2B 软件;82 条包含各种提醒,不全是针对厂商比较内容的质疑。帖子也没有提供模型切换前的同组数据,无法直接推断提醒增加了多少。
此外,Konitzny 是 Peec AI 的研究员,Lily Ray 使用的同样是 Peec AI。两份观察都与这家 GEO 监测工具厂商有关,不能当成完全独立的交叉验证。
Lily Ray 表示,提醒往往只占回答的一小部分,可能是推荐列表结尾的一两句话。她将此视为 AI 平台处理推荐质量问题的临时措施;这是她的解读,并非 OpenAI 已确认的产品策略。
这是 OpenAI 刻意调整的结果吗?
目前还不能下定论。
根据 OpenAI 官方发布记录,GPT-6 从 2026 年 10 月 7 日起向 Plus、Pro、Business 与 Enterprise 用户陆续推出,Free 与 Go 则从 10 月 8 日开始,Enterprise 仍取决于管理员设置。
10 月 7 日的官方公告也提到,第一批 GPT-6 模型在 9 月就已提供给付费客户。因此,模型首次推出与 ChatGPT 默认模型切换,应视为不同事件。
截至 2026 年 10 月 23 日本文修订时,在本次核对的 GPT-6 公告、ChatGPT 发布记录与系统卡中,未见 OpenAI 将“提高对排名文、比较页及厂商自报数据的提醒频率”明确列为产品更新。
GPT-6 系统卡虽然谈到模型更少对无害请求添加过度或带有评判性的附注,但该段属于安全性与模型响应评估,不能直接用来解释这次的来源提醒。
因此,Konitzny 的数据较适合被理解为模型切换前后的相关现象,还不是模型更新造成变化的因果证据。他的帖子未完整公开提醒分类方法、提示词组成、前后观测时间长度,以及不同行业的差异,这些因素都可能影响统计结果。
对品牌而言,还有一个关键局限:现有数据没有证明,提醒增加会让消费者降低信任、减少点击,或改变购买决策。
被 AI 引用,不代表内容一定被采信
品牌常用引用次数、品牌提及率,以及进入推荐列表的频率衡量 GEO 表现。这些指标衡量的是曝光与出现机会,无法完整呈现 AI 如何描述品牌。
例如,用户问 ChatGPT:“有哪些值得推荐的 GEO 监测工具?”回答可能列出五款工具,并引用厂商撰写的比较文章。如果它同时补充,这份比较主要来自厂商自行公布的数据、尚未经过独立测试,用户接收到的信息就不只有产品优势。
这不表示 ChatGPT 已判定产品不可信,但品牌至少应分开观察三件事:
- 引用来源:AI 引用的是品牌官网、第三方文章,还是评论网站?
- 回答内容:品牌被正面推荐、客观比较,还是伴随特定限制与警示语?
- 实际成效:用户是否进一步访问网站、咨询产品或完成转化?
Konitzny 的观察主要涉及前两者,尚不足以证明第三者受到影响。不过,单看引用率,确实可能漏掉回答内容的重要细节。
学术研究也指出,内容被检索与被引用是不同阶段
10 月 10 日,Mahe Chen 与 Nick Koudas 在 arXiv 提交的研究《What Drives AI Citations?》,从另一个角度分析生成式搜索的引用机制。
研究使用 ChatGPT、Gemini 与 Perplexity 对商业问题的 API 回答数据,再通过 API 复现部分检索过程。它研究的是页面被检索后,哪些因素与进一步被引用有关。
在控制 ChatGPT 检索结果排名等因素后,品牌自有页的被引用优势比约为 1.71,列表页为 0.54,比较页为 0.34。这些是特定研究条件下的相对优势比,不能直接当成所有网站的引用率。
研究也发现,将比较范围缩小到同一网站时,FAQ 区块与 Schema 结构化数据等常见做法,未呈现稳健且显著的引用优势。相比之下,内容与用户问题、模型检索查询的语义关联更值得注意。
但论文没有研究来源免责提醒,ChatGPT 实验使用的也是 GPT-5.4-nano API,并非 GPT-6 消费版,不能用来证明 GPT-6 为何更常添加提醒。
Chen 与 Koudas 关注“哪些页面被检索后会得到引用”;Konitzny 关注“已被引用的内容,是否仍伴随可信度提醒”。两者处于不同阶段,也说明 GEO 评估可以从网站是否进入参考来源,进一步看最终回答如何呈现品牌。
品牌应该如何检查自己的 GEO 内容?
现阶段不需要因此全面停止制作列表文或比较文章。Konitzny 的另一组数据显示,列表文仍是 ChatGPT 的引用来源;两类提醒的比例分别为 3.46% 与 2.27%,也不能放大成普遍规则。
比较务实的做法,是先检查一个产品或服务类别。以下是根据上述观察提出的编辑与测量建议,并非 OpenAI 公布的优化规则。
1. 用实际购买场景测试 AI 回答
整理 10~20 个潜在客户可能提出的问题,涵盖产品推荐、品牌比较、价格差异与适用场景。在 ChatGPT 中使用相同问题多次测试,记录日期、界面与模型版本、账号类型、品牌是否出现,以及回答有没有来源提醒,并保存完整回答与引用网址。
不同模型、时间与对话场景都可能造成差异,单次截图不足以代表稳定表现;API 监测结果也应与 ChatGPT 网页或 App 的测试分开记录。
2. 不只记录引用率,也检查 AI 如何描述品牌
针对每条回答,区分品牌是否被提及、是否进入推荐列表,以及引用来自何处。出现提醒时,再记录它针对未验证排名、厂商自报数据、赞助关系,还是 AI 自己的推荐限制。
也要确认提醒针对的是品牌、引用网站,还是整份推荐列表,避免把所有警示语都当成品牌受到负面评价。如果品牌依赖 Reddit 等用户生成内容(UGC)获得曝光,也可一并检查相关描述。
3. 检查比较页、排行榜与成效主张
官网如果有“十大最佳工具”、竞品比较或成效案例,应确认数据来源、评比方法与商业关系是否清楚。品牌自行测试的结果,有没有交代测试时间、样本量、比较条件与计算方法?排名由谁制作?赞助与联盟营销关系是否披露?
这些信息能帮助读者判断内容,但增加披露声明不等于一定能提高 AI 引用或改善推荐结果,目前没有足够数据支持这种效果。
4. 持续监测,并结合网站实际成效
每月用固定问题重测,观察引用来源、品牌推荐与提醒内容的变化。如果某类比较文章开始频繁出现特定警示语,再检查是否有信息不足、过时数据或未披露的利益关系。
同时可通过 GA4 观察 ChatGPT 带来的可识别访问与转化。但并非所有访问都能正确归因,缺少来源信息时也可能被归入 Direct,不能只看 ChatGPT referral 流量判断全部成效。
GEO 的下一个问题,可能不只是如何增加引用
目前能确认的是,Konitzny 在 GPT-6 默认模型切换前后的监测样本中,观察到未验证排名与厂商自报数据提醒增加;Lily Ray 也在 B2B 软件类别看到相关提醒。这些数据尚未证明 OpenAI 正式改变来源评估政策,也无法推断所有行业都有相同情况。
品牌投入 AI 搜索曝光时,引用是一项指标;引用出现在哪类问题、品牌如何被描述,以及回答是否附带来源限制,同样会影响对曝光质量的判断。
品牌需要理解的,不只是自己有没有出现在 AI 回答中,还有用户通过这份回答,究竟认识到什么样的品牌。
现阶段没有证据显示这些提醒已系统性改变购买决策。与其立即追逐新的优化技巧,不如先从现有比较页、产品数据与成效案例开始,确认哪些主张能被外部查证,哪些仍只是品牌自己的说法。
常见问题
GPT-6 会对所有品牌排行榜添加免责提醒吗?
不会。Konitzny 的监测结果显示,排名未经独立验证的提醒占相关对话约 3.46%,厂商自报数据提醒约 2.27%。分母是至少引用一篇列表文或比较页的对话;两类可能重叠,不能相加,也不代表所有 ChatGPT 对话的比例。
ChatGPT 开始质疑比较文,代表 GEO 不应该再做排行榜吗?
不能这样解读。Konitzny 的另一项观察指出,列表文在 GPT-6 切换后的引用网址占比反而上升。品牌仍可制作有实际比较价值的内容,并清楚交代数据来源、评比方法与商业关系;这些做法是否改善 AI 引用,仍需另行验证。
ChatGPT 引用率增加,就代表 GEO 成效改善吗?
不一定。引用率主要衡量来源曝光,还需要结合品牌是否被推荐、回答内容、网站访问与实际转化来评估。品牌也可能被提及,却没有获得可追踪的网站流量。
参考资料
- David Konitzny:GPT-6 is becoming more critical of claims,2026 年 10 月 14 日。
- David Konitzny:ChatGPT has a new default model: GPT-6,2026 年 10 月 9 日。
- Lily Ray:ChatGPT 来源提醒观察,2026 年 10 月 19 日。
- OpenAI:ChatGPT Release Notes,本次核对 2026 年 10 月 7 日发布记录。
- OpenAI:GPT-6 and Intelligent UI for everyone,2026 年 10 月 7 日。
- OpenAI:GPT-6 Sol and GPT-6 Luna: October 2026 update,2026 年 10 月 7 日。
- Chen 与 Koudas:What Drives AI Citations? Content, Retrieval and Model Knowledge in GEO,arXiv 预印本,2026 年 10 月 10 日。